探索全部
共 1,808 个仓库 · 一年内有推送 · Python
用 Triton 重写 LLM 训练中的 RMSNorm、RoPE、交叉熵等关键算子,减少显存占用并提升微调吞吐,兼容 Llama、Mistral、Gemma、Phi 等主流模型。
基于 Python 的开源离线翻译库,用本地语言模型完成多语种互译,无需联网即可在自有设备上跑机器翻译。
Python 图像处理算法库,提供滤波、分割、形态学、特征检测等常用算法,适合科研与工程中快速实现图像分析流程。
把扫描版 PDF 书籍转成 Markdown、EPUB 等格式,结合 DeepSeek OCR 处理影印书,方便数字化阅读和翻译。
把长期目标拆成可验证结果的本地优先语义控制平面,让多智能体团队跨会话、跨运行时持续协作并追踪研究进展。
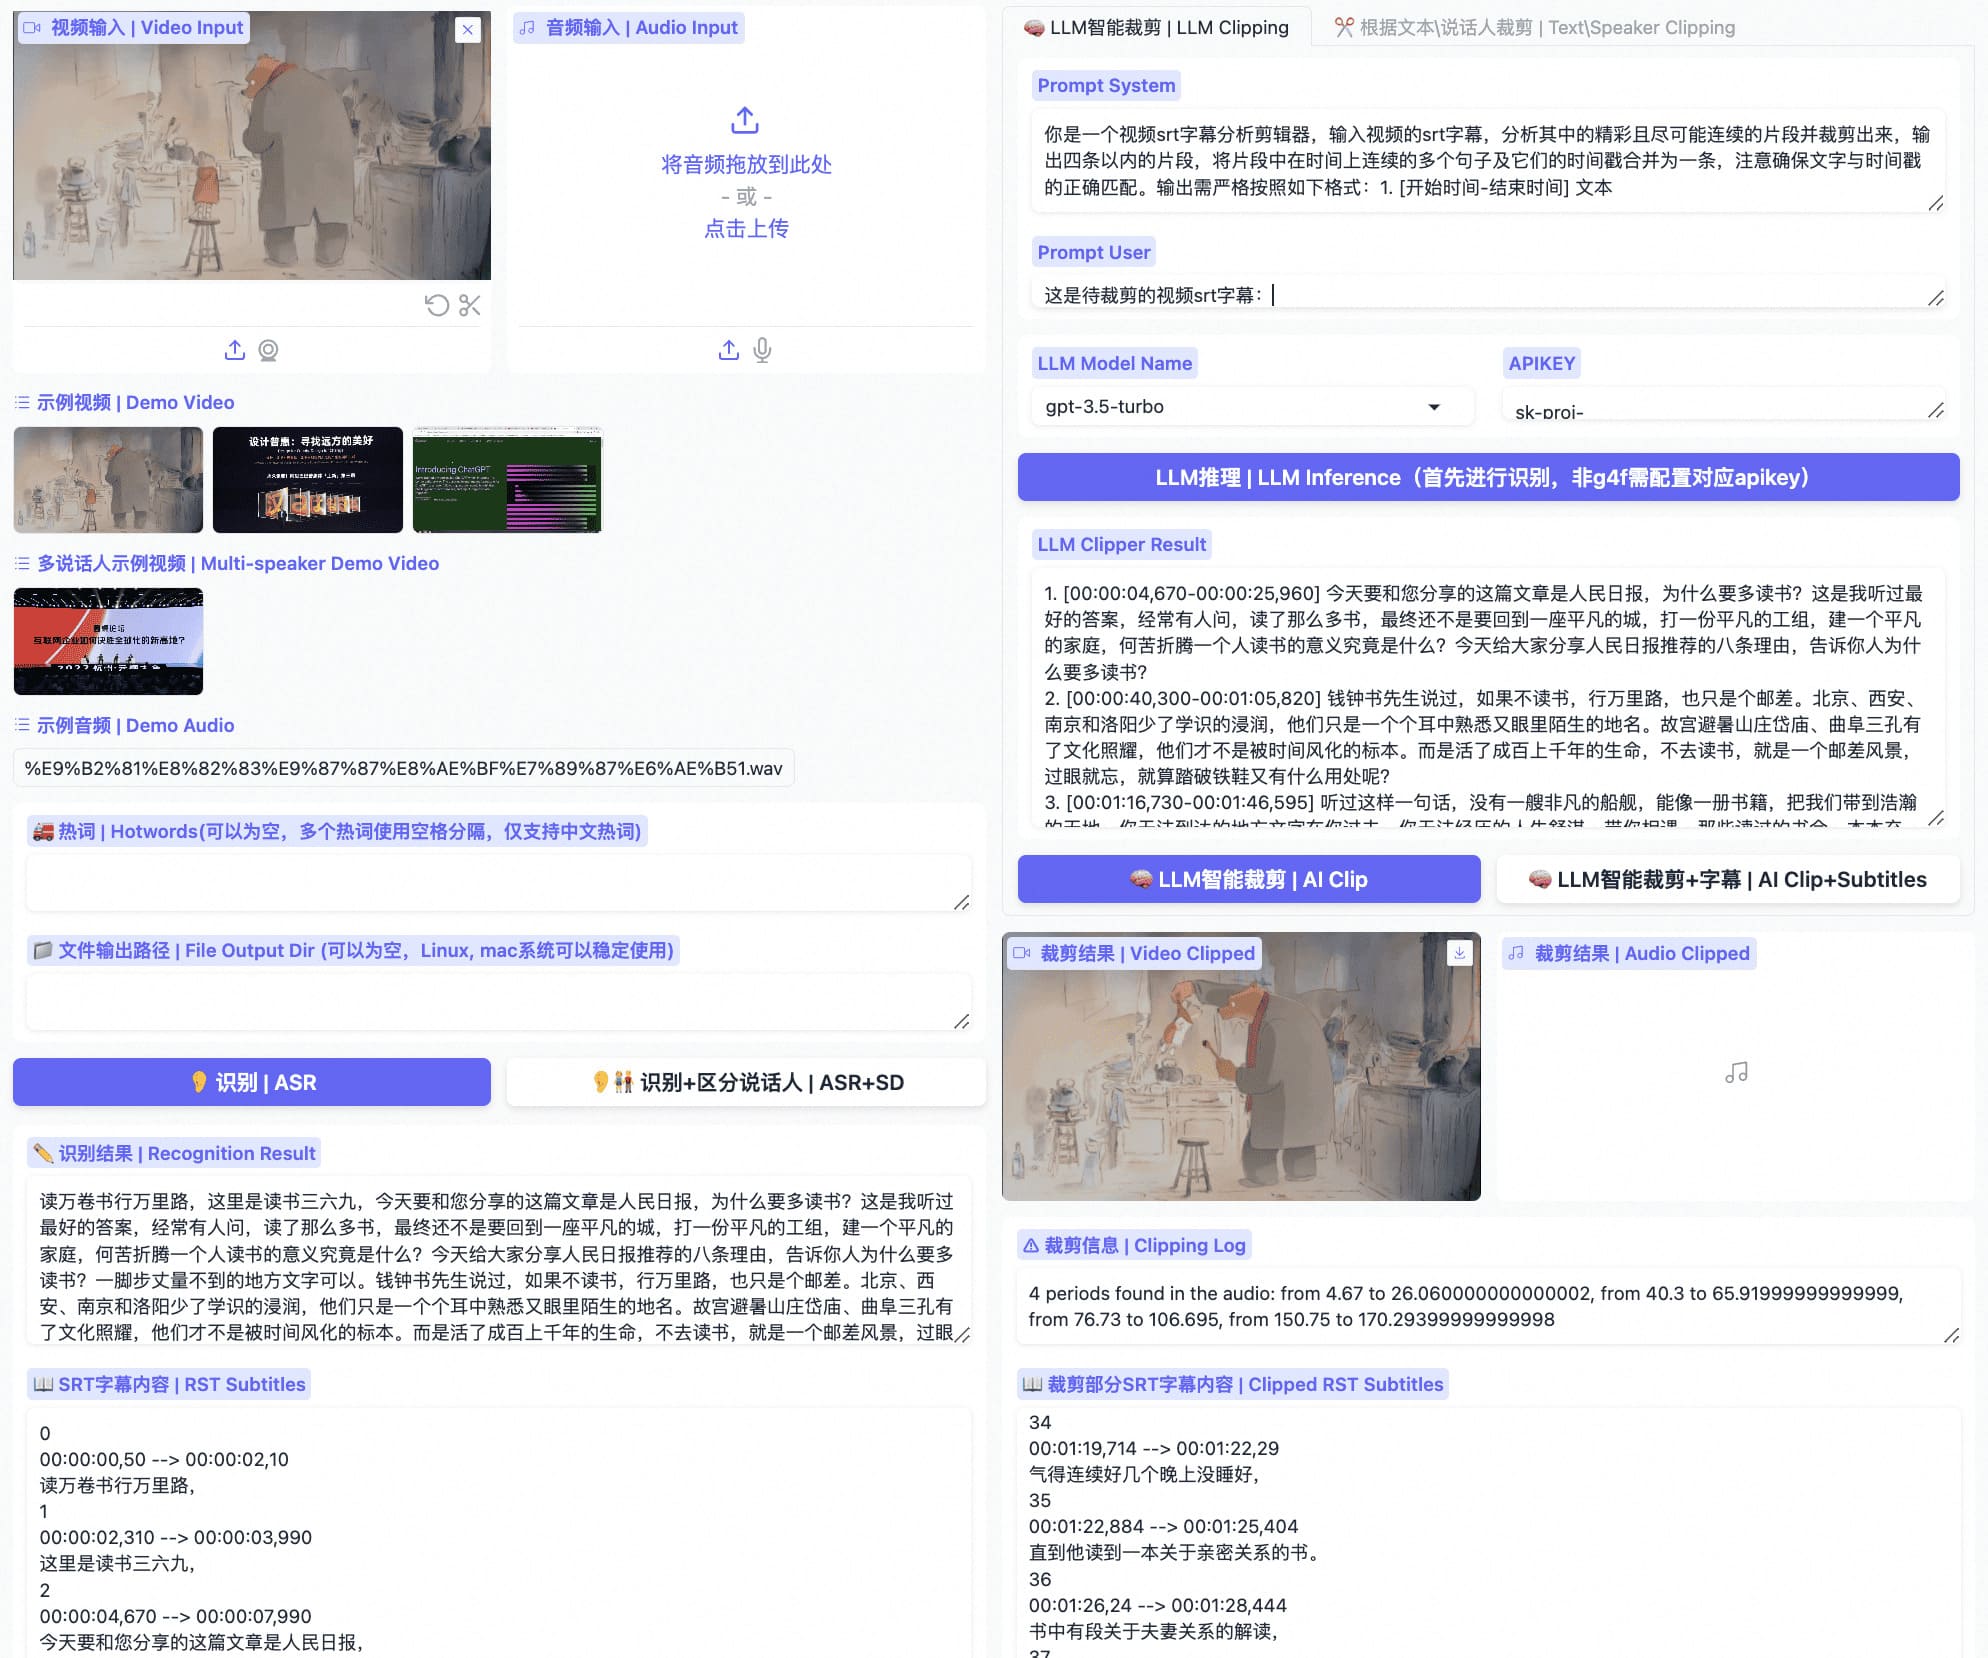
基于 FunASR 的本地视频转写与字幕生成工具,带 Gradio 界面,还能用大模型辅助自动剪辑,适合做中文视频内容创作。
用 Git 管理 dotfiles 的命令行工具,支持加密、模板和跨平台引导,让配置文件版本化、可移植。
基于深度学习的一站式 OCR 库,把文字检测、文字识别和版面分析串成流水线,支持 PyTorch 训练与微调,适合快速搭建文档解析应用。
自部署的 AI 视频工作台,能把小说和剧本自动拆成角色、场景、道具资产与分镜,生成视频并导出剪映草稿,还支持跨镜头一致性和多供应商费用追踪。

用 Python 解析 Android 应用,反编译 DEX 字节码、分析权限与组件,做逆向和渗透测试时不用再手动拆包。
针对 Solidity 和 Vyper 智能合约的静态分析器,能在部署前自动检测漏洞、代码异味和规范问题,帮审计和开发人员提前排雷。
基于大语言模型的语音合成系统,能生成接近真人音色的自然语音,并支持实时流式输出,适合搭建低延迟的 TTS 服务。
面向 AI Agent 的代码检索工具,用嵌入向量做语义搜索,比 grep+read 少消耗 99% 的 token,让 Agent 更快更准地定位代码。
一个能自我进化的 Agent 操作系统,通过面试式准入、分阶段评估和预算约束的演化循环让编码 Agent 越用越强,支持 Claude Code、Codex CLI 等 14 种运行时。
从图片和视频中清除可见与不可见的 AI 水印,并移除 C2PA、EXIF 等来源元数据,提供 Python 库、CLI 和 agent skill。
基于 PyTorch 的度量学习库,提供对比损失、难例挖掘、采样器和检索指标,用来训练和评估相似度搜索所需的嵌入向量。
把任意编码助手变成 Google Cloud 上的 AI Agent 专家,提供命令行工具和技能,覆盖 Agent 的创建、评估与部署全流程。

FLARE 团队开源的恶意软件分析工具,能自动识别可执行文件中的能力特征,帮逆向工程师快速判断样本干了什么。
开源实验追踪工具,能记录、可视化和对比机器学习训练中的指标、超参数与元数据,帮团队理清大量实验。
基于飞桨的一站式开发工具,把分类、检测、分割、OCR、语音识别等任务封装成流水线,支持训练到部署全流程。
把时间序列当成语言来建模的预训练预测模型,基于 Transformer 架构,可直接用于零样本或微调预测,省去从零训练的成本。
把文字描述直接变成可编辑的 3D 模型和 CAD 设计,省去从零建模的麻烦,适合 3D 打印和快速原型场景。
一条命令就能搭好包含 Caffe、Keras、MXNet 等主流框架的深度学习 Docker 环境,省去逐个配置依赖的麻烦。
用 Flask + Redis 搭建的代理池,自动从多个来源抓取免费代理并持续检测可用性,通过 HTTP 接口给爬虫提供稳定可用的代理 IP。