探索全部
共 1,808 个仓库 · 一年内有推送 · Python
把训练好的 sklearn、XGBoost 等 ML 模型直接暴露成 LLM Agent 可调用的工具,省去自己写胶水代码,让 Agent 能调用传统模型做预测。
命令行驱动 Google Flow 批量生成 Veo 视频和 Imagen 图片,支持脚本化流水线,并内置 MCP 服务器让编码智能体也能直接调用。
通过部署恶意流水线,从 Azure DevOps、GitHub、GitLab 的 CI/CD 环境中提取密钥,用于红队评估流水线配置的泄露风险。

面向基础模型训练的多模态数据流水线,把数据清洗、筛选和质量评估串成可扩展流程,解决大规模图文数据难治理的问题。

OmniVGGT 是 CVPR 2026 提出的多模态视觉几何 Transformer,把图像、深度、点云等不同模态统一进一个空间基础模型,用来做 3D 重建和几何理解。
用单张图片自监督重建三维场景,基于神经辐射场实现新视角合成与深度估计,无需三维标注数据。
轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。
用生成模型合成带标注的肝脏肿瘤 CT 图像,无需人工标注即可训练分割模型,缓解医学影像标注成本高的问题。
Vulners 漏洞情报 API 的官方 Python SDK,可查询 CVE、漏洞利用和公告(含 CVSS/EPSS/KEV),审计软件、主机与 SBOM,并提供同步/异步客户端和内置 MCP 服务供 AI Agent 调用。
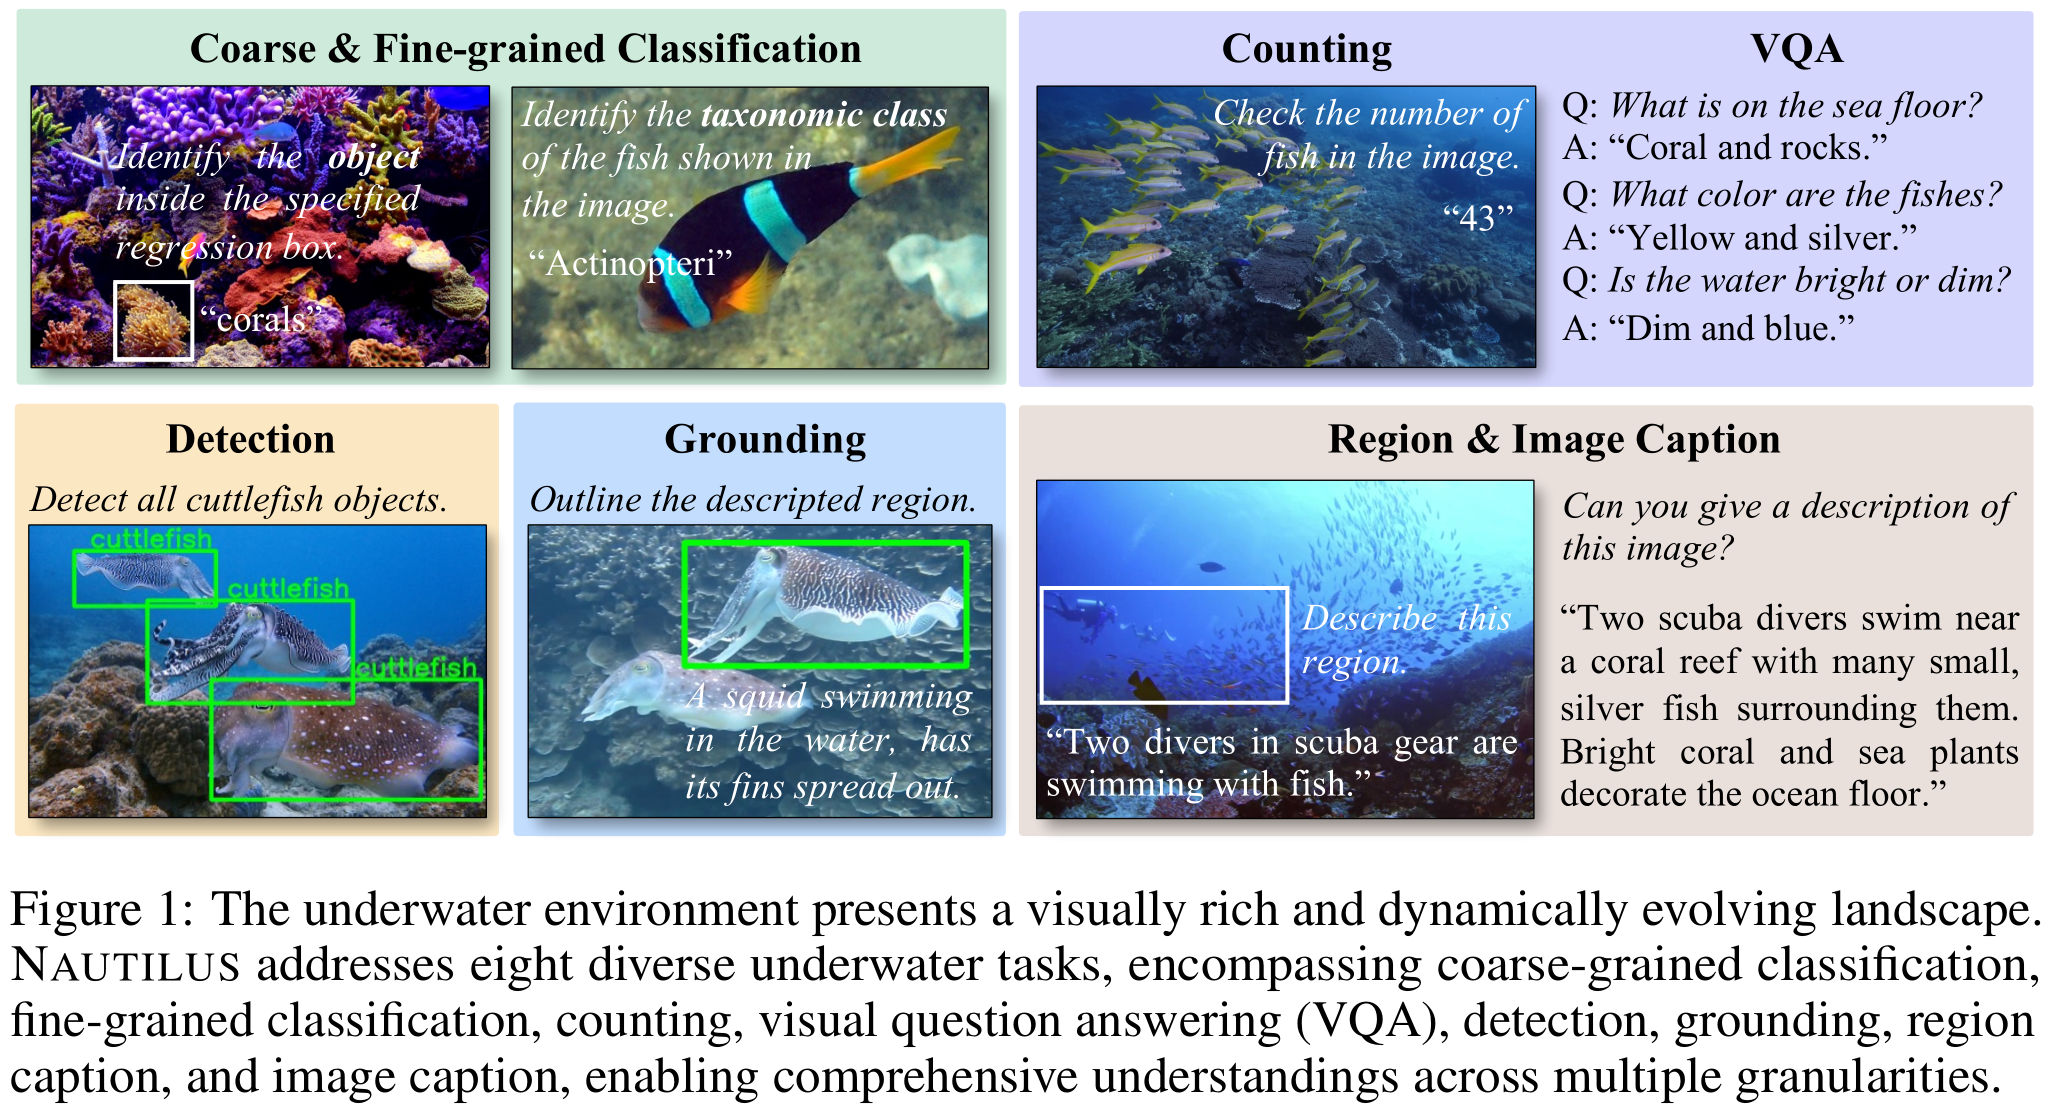
面向水下场景理解的大型多模态模型,能同时处理水下图像与文本,完成描述、问答等视觉语言任务,填补水下环境多模态研究的空白。
一套用于压测向量搜索引擎的基准框架,可对比不同向量数据库的检索性能,帮你在选型时拿到实测数据。
基于 YOLOv8、PyTorch 和 OpenCV 实现目标检测与多目标跟踪,可直接跑通视频流中的实时追踪,省去自己拼装检测器和跟踪器的麻烦。
极简的多模态大模型微调代码库,支持 LLaVA、Qwen-VL、Llama-3.2-Vision 等主流视觉语言模型,方便快速做指令微调实验。
自动更新维护的 IPTV 直播源合集,提供 CCTV 等频道的 m3u/txt 播放列表,方便直接导入播放器观看电视直播。
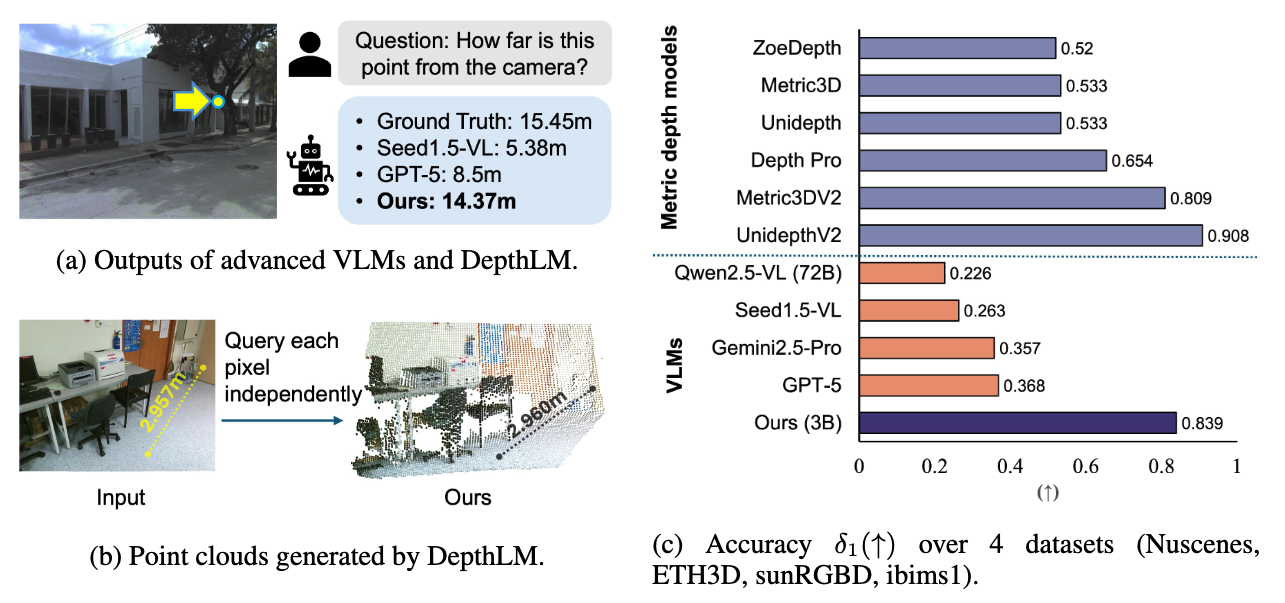
DepthLM 的官方实现,用视觉语言模型做单目深度估计,把深度预测转成语言建模任务,在 ICLR 2026 入选 Oral。
追踪 arXiv 上 3D 高斯泼溅(Gaussian Splatting)最新研究进展的精选列表,每日自动更新,帮研究者快速跟进三维重建与渲染的前沿论文。
在 Apple Silicon Mac 上离线跑 LTX-2.5 和 MiniMax H3,做带声音的文本/图片转视频、对口型和角色 LoRA 训练,不用云端和 API key。
用 LLM 自动审查 Pull Request 的代码差异,并把评审意见直接评论到 PR 上的 GitHub Action,省去人工逐行看 diff 的功夫。
vMAP 是 CVPR 2023 提出的神经场 SLAM 系统,用向量化对象建图实现实时 RGB-D 稠密重建,无需逐场景训练即可完成三维重建。
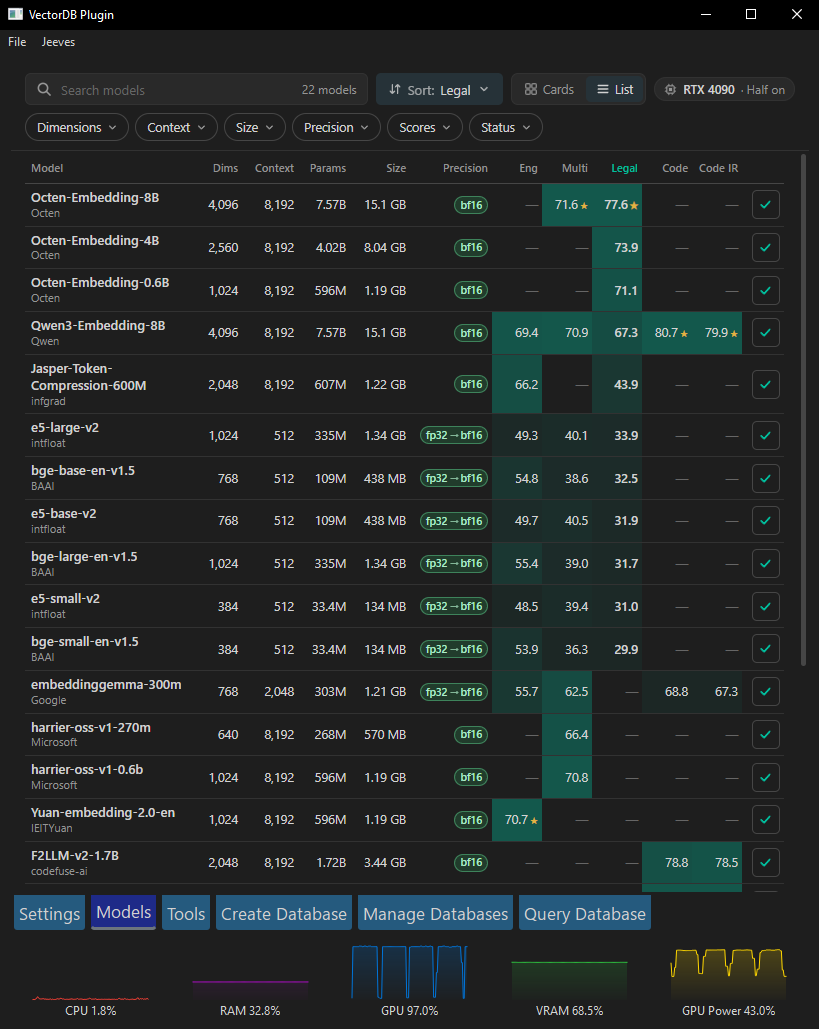
把本地文档和音视频文件建成向量库,用自然语言提问就能检索并回答,适合搭建私有 RAG 问答。
用 AI 自动翻译漫画的桌面工具,集 OCR 识别、文字擦除修复和 LLM 翻译于一体,省去手动修图和逐句翻译的麻烦。
用 Meta 的 Segment-Anything 模型对 LiDAR 点云做分割的 Python 包,省去自己搭建分割流程的麻烦。
追踪勒索软件团伙的情报平台,抓取并整理受害者信息、谈判记录和截图,帮安全人员快速掌握勒索攻击动态。
用洪水填充网络在三维体数据中做实例分割,主要面向连接组学中神经元等结构的自动追踪与分割。