Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 24 / 43 页在 Apple Silicon Mac 上原生微调大模型的工具,基于 MLX 支持 SFT、DPO、GRPO 以及视觉、语音、OCR 等多模态训练,API 兼容 Unsloth。
SkillNet 用知识图谱把 AI 技能组织成可复用、可评估、可连接的技能网络,让智能体按需检索并组合技能完成任务。
一个桌面 AI 代理,能为每个任务自动雇佣专家代理,在你的真实应用里连续工作数周,还能用手机远程下达指令。
给 Claude Code 加上语音对话能力,用 Whisper 做语音识别、Kokoro 做语音合成,通过 MCP 服务实现自然流畅的语音交互。
仅凭视频输入就能做流式三维重建,重点解决长时序场景下局部上下文丢失的问题,适合在线建图与SLAM类应用。
OpenCV-Python 4.1 中文教程文档,涵盖图像处理、目标检测等计算机视觉入门内容,适合中文开发者系统学习 OpenCV 的 Python 用法。
OuteTTS 模型的推理接口,支持 GGUF 和 Transformers 后端,方便本地跑文本转语音。
PointCNN 提出 X-变换卷积算子,直接在无序点云上做特征学习,可用于三维点云分类和分割,服务于自动驾驶、机器人等场景。
面向波斯语(Farsi)的 Python NLP 工具包,提供文本归一化、分词、词性标注、依存句法分析、词形还原和词向量等完整处理流程。
Milvus 向量数据库的官方 Python SDK,让 Python 开发者能直接建集合、写入向量并做相似度检索,是搭建 RAG 和向量搜索应用的基础客户端。
把视频自动翻译并配音成另一种语言,集语音识别、说话人分离、字幕翻译和语音合成于一体,输出音画同步的译制视频。
韩语版 BERT 预训练模型,基于 PyTorch 和 Transformers,可直接加载做韩语文本分类、情感分析等下游任务的微调。
一个可直接用于生产的 MLOps Python 包模板,集成 MLflow、scikit-learn、Pydantic、Pandera 和 uv,帮你快速搭起带实验追踪与数据校验的机器学习工程骨架。
分布式模型服务框架,能把多台机器组成自建 AI 推理集群,用来跑 Llama、DeepSeek 等大模型。
围绕 TTS 生成模型搭建的语音合成服务,提供 API Server 和 Gradio WebUI,方便快速部署和调用多种语音生成模型。

一个完全自主的通用 AI 智能体,能自己拆解任务、调用工具并完成复杂目标,适合搭建自动化 Agent 流程。
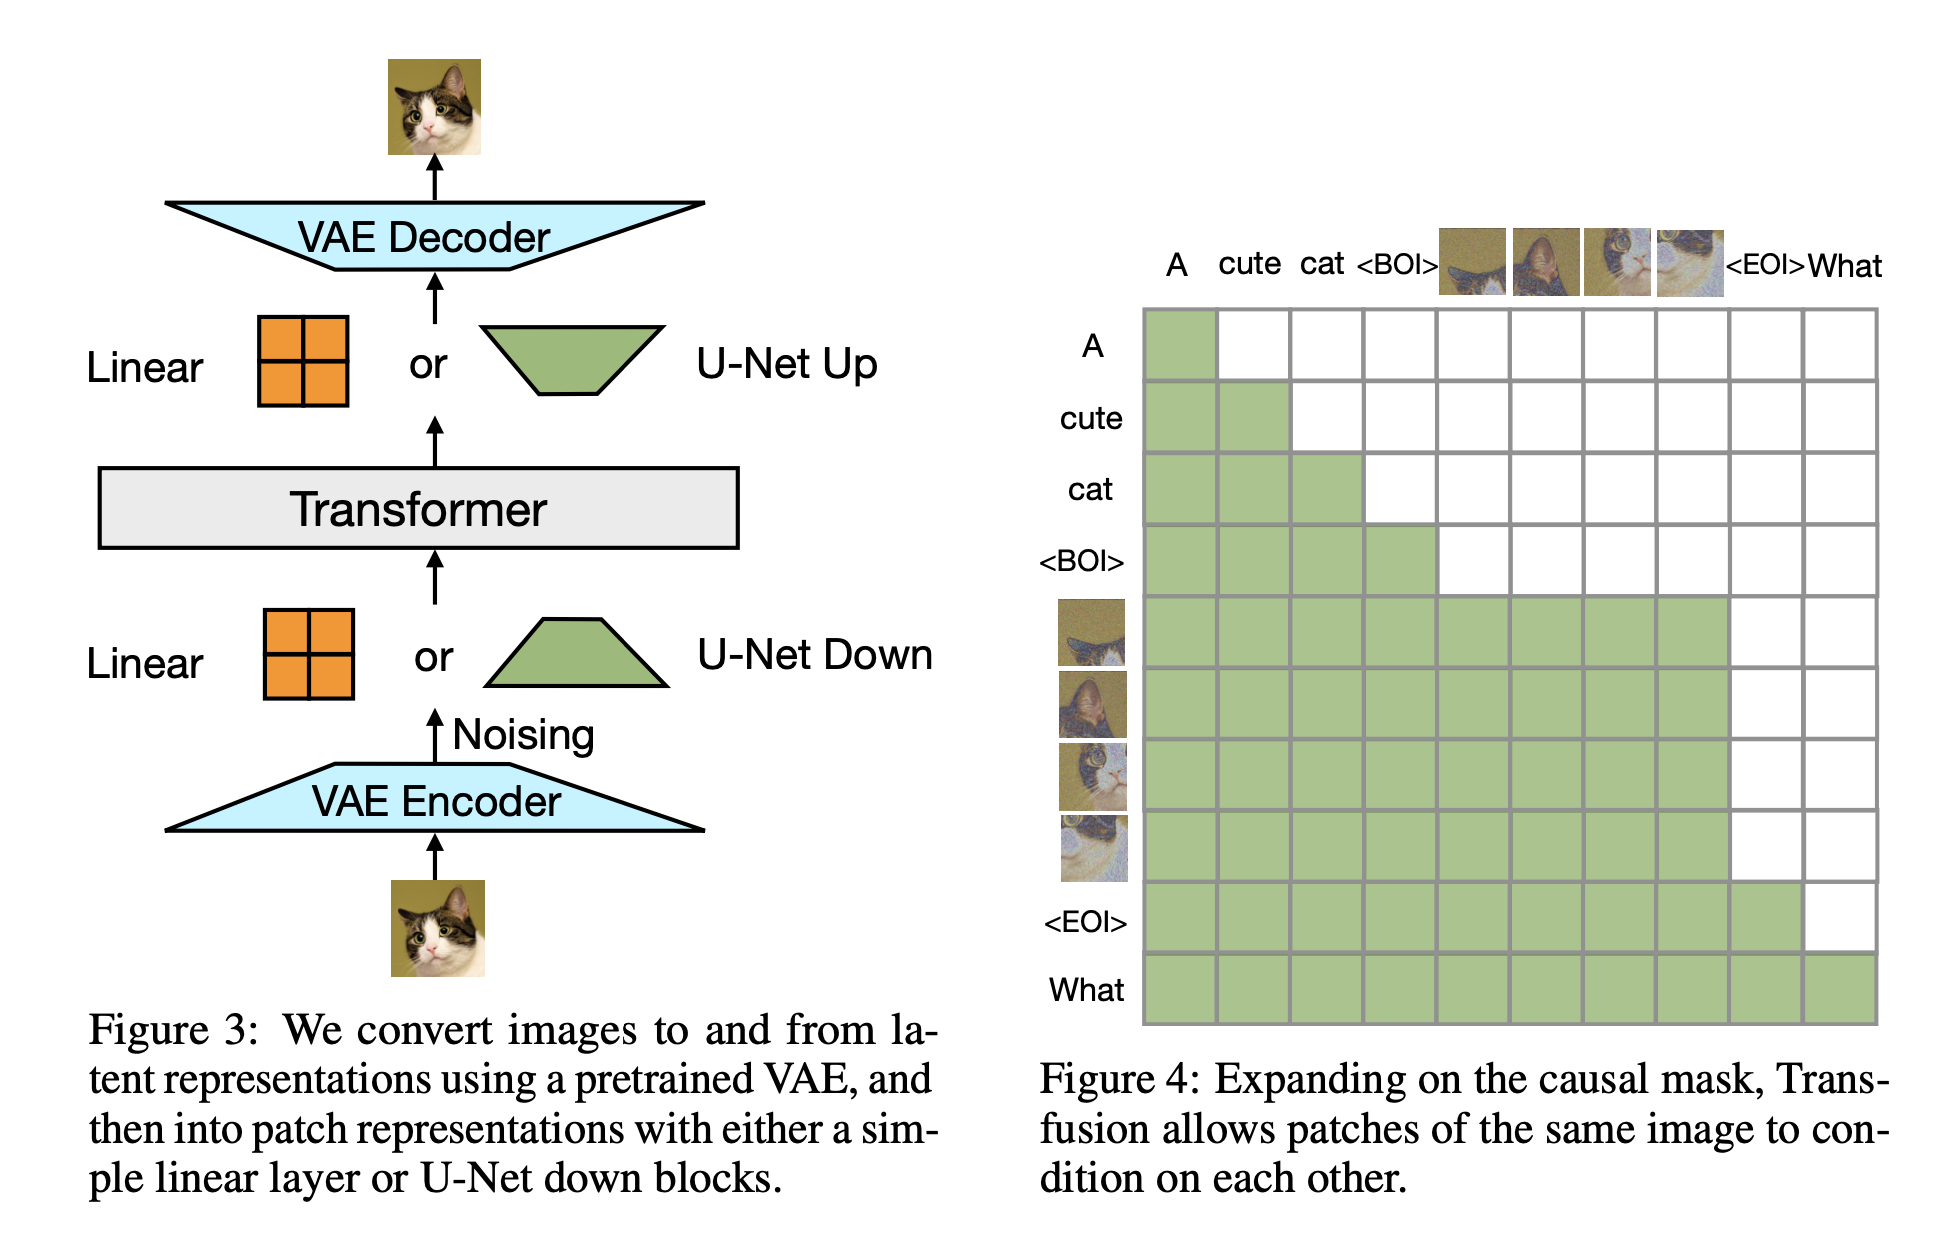
用 PyTorch 复现 MetaAI 的 Transfusion:在同一多模态模型里同时预测下一个 token 和扩散生成图像,把语言建模与图像扩散统一到一个 Transformer 中。
实时端到端开放词汇目标检测模型,无需重新训练即可用自然语言描述检测任意类别物体,适合零样本检测场景。
把大语言模型接入 spaCy 的结构化 NLP 流水线,用提示词完成命名实体识别等任务,无需训练即可复用现有流程。
阿里开源的高性能大模型推理引擎,支持 GPT、Llama 等多种模型,面向各类应用提供低延迟、高吞吐的在线推理服务。
给 Hermes Agent 用的七层持久记忆系统,基于 Qdrant 向量库做结构化事实存储、自动整理 wiki 和精准上下文注入,本地运行且兼容任意 LLM 提供商。
一种面向视频扩散模型的免训练缓存加速方法,利用时间步嵌入判断哪些步骤可以复用计算结果,从而在不重新训练的情况下显著提升推理速度。
开源图像编辑基础模型,能精准理解指令完成高保真修图,并保持人物身份一致、自然融合多元素,适合做图像编辑训练与微调。
面向开发者的模型优化框架,能对扩散模型、LLM、语音识别等模型做压缩加速,以极低改造成本换来更快、更省资源的推理。
集音视频处理、图片编辑、文本操作与编码于一体的桌面工具箱,内置语音识别、OCR 等 AI 增强能力,并提供本地 MCP 服务来简化日常办公流程。

Qdrant 向量搜索引擎的官方 Python 客户端,方便在 Python 项目里接入向量检索,做相似度搜索和 RAG 应用。
基于 CTranslate2 加速的 Whisper 命令行客户端,接口与 OpenAI 官方客户端兼容,能更快地做语音转文字。

本地完成计算机视觉模型从标注、训练到优化部署的全流程,支持增量学习与模型压缩,针对 Intel XPU 加速并兼容 CUDA。
一款功能完整的图片/视频管理应用,能读取 SD-webui、ComfyUI、Fooocus、NovelAI 等生成的元数据,并支持 AI 整理与语义搜索,可独立运行或作为扩展使用。
非官方的 Finviz 数据接口,用 Python 抓取股票筛选器、图表和 CSV 数据,省去自己写爬虫解析网页的麻烦。

面向俄语的轻量级 NLP 工具集,把分词、词形还原、命名实体识别、句法分析等基础任务封装成统一 API,适合快速搭建俄语文本处理流程。

用扩散模型做医学图像器官分割与重建,把去噪扩散思路引入分割任务,适合医学影像研究和训练微调。
面向扩散模型的可扩展、显存优化训练框架,基于 PyTorch 和 Diffusers,让大模型微调在有限显存下也能跑起来。

把 PDF、书籍和论文自动转成可追溯、可测验、可做笔记的交互式学习网页,适合用 AI Agent 把复杂资料变成能学能练的知识库。
UNO 是字节跳动开源的通用图像定制方法,基于扩散 Transformer,用同一套框架同时支持单主体和多主体参考图生成,解决多主体一致性难的问题。
给代码仓库装上大脑的代码智能问答工具,能接入 Claude Code、Cursor、Codex 等 IDE 和命令行,用知识图谱检索帮你快速理解和查询整个代码库。
基于扩散模型的虚拟试衣方案,可自定义服装、姿态和场景生成高保真人物图,并保持服装细节一致。
复现 DeepSeek Engram 记忆架构的研究项目,基于 Qwen-3 和 Stable Diffusion,用 LoRA/PEFT 给大模型注入外部记忆,免去全量微调。

基于 DGL 的高性能知识图谱嵌入学习库,支持在超大规模图谱上训练 TransE、RotatE 等嵌入模型,兼顾易用性与可扩展性。

基于扩散模型的时间流逝视频生成模型,能把文本提示变成物体随时间逐渐变形的延时视频,还配套了专门的延时数据集。
RoMa 是 CVPR 2024 提出的鲁棒稠密特征匹配器,能为几乎任意图像对估计像素级稠密形变和可靠的匹配置信度,用于 3D 重建等任务。
开箱即用的实时交互数字人,支持自定义形象和音色克隆,端到端对话延迟低至3秒,适合快速搭建虚拟主播或客服场景。
把 ONNX 模型转成 TensorFlow 格式,方便在 TensorFlow 生态里直接加载和运行其他框架训练好的模型。
用超网络仅凭任务文本描述就为 LLM 生成 LoRA 权重,免去标注数据和反向传播,让模型快速适配特定基准任务。
用 Python 抓取和管理 IMDb 电影、演员与角色数据的工具包,方便做影视资料查询和数据集构建。
把 TAR、RAR、ZIP、GZ 等大型压缩包直接挂载成文件系统,无需解压就能随机访问其中文件,省时省磁盘。

一套从零到精通 AI 工程的中文学习路径,20 个阶段 542 节课,配动画讲解视频和配套站点,帮人系统成长为 AI Agent 工程师。

用 PyTorch 复现 bert4keras 风格的 Transformer 实现,支持 BERT、LLaMA、ChatGLM 等模型,方便做 NLP 训练与推理。