Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 25 / 43 页一套 14 个 AI Skill,把抖音、B站、小红书、公众号、播客等中文平台内容采集进个人知识库,支持图文存图、字幕优先免 GPU 转写、订阅调度和每日简报,还带知识库 MCP server。
从稀疏多视角图像前馈式重建 3D 高斯,用代价体积做几何匹配,无需逐场景优化就能快速合成新视角。
本地优先的语义代码搜索引擎,用向量嵌入理解代码含义,支持像 grep 一样搜索,但能按语义而非仅靠正则匹配找代码。
跨 macOS 和 Windows 的实时语音翻译桌面应用,本地运行无需服务器,用自己的 API key 完成语音识别与翻译,并免费合成语音。
面向生产环境的 GraphRAG 系统,支持多模态索引、AI 智能体和 MCP 协议,可在 K8s 上弹性部署,帮团队把知识图谱与检索增强真正落地。
本地离线跑图像生成、实时语音对话和 LLM 聊天机器人的桌面推理引擎,数据不出本机,适合注重隐私的创作与自动化工作流。
把 Gemini、Grok、豆包、元宝等平台的原生 AI 搜索能力聚合成统一接口,一次查询即可拿到科技趋势、行业舆情和热点信息,方便接进自己的 Agent 和工作流。
给 LLM 应用接入 OpenTelemetry 埋点,统一采集 OpenAI、LangChain、LlamaIndex 等框架的调用链路,方便做可观测和排障。

把 AI Agent 线上失败自动聚类、冻结成可复现用例,在 CI 中回放并拦截有问题的 PR,实现 trace 原生的回归测试。
Python 抠图 SDK,支持本地 ONNX 模型和云端两种方式去除图片背景,几行代码就能集成到图像处理流程里。
用单步扩散模型修复 3D 重建中的伪影和缺失细节,提升 NeRF 与高斯泼溅的渲染质量,出自 CVPR 2025 Oral。
用 Python 实现 node2vec 图嵌入算法,把网络中的节点映射成低维向量,方便下游做节点分类、链接预测等图学习任务。
基于 InSPyReNet(ACCV 2022)的抠图工具,能一键去除图片和视频背景,输出带透明通道的结果。
把 Frigate NVR 接入 Home Assistant 的官方集成,让摄像头画面、目标检测事件和录像直接在智能家居面板里联动展示。
可微分渲染器 SoftRas 的官方实现,把光栅化过程变得可导,让基于图像的三维重建和几何推理能端到端训练。
用空间稀疏注意力做超大规模 3D 生成,单卡也能跑千兆级 3D 内容,支持图生 3D 和 3D 重建。
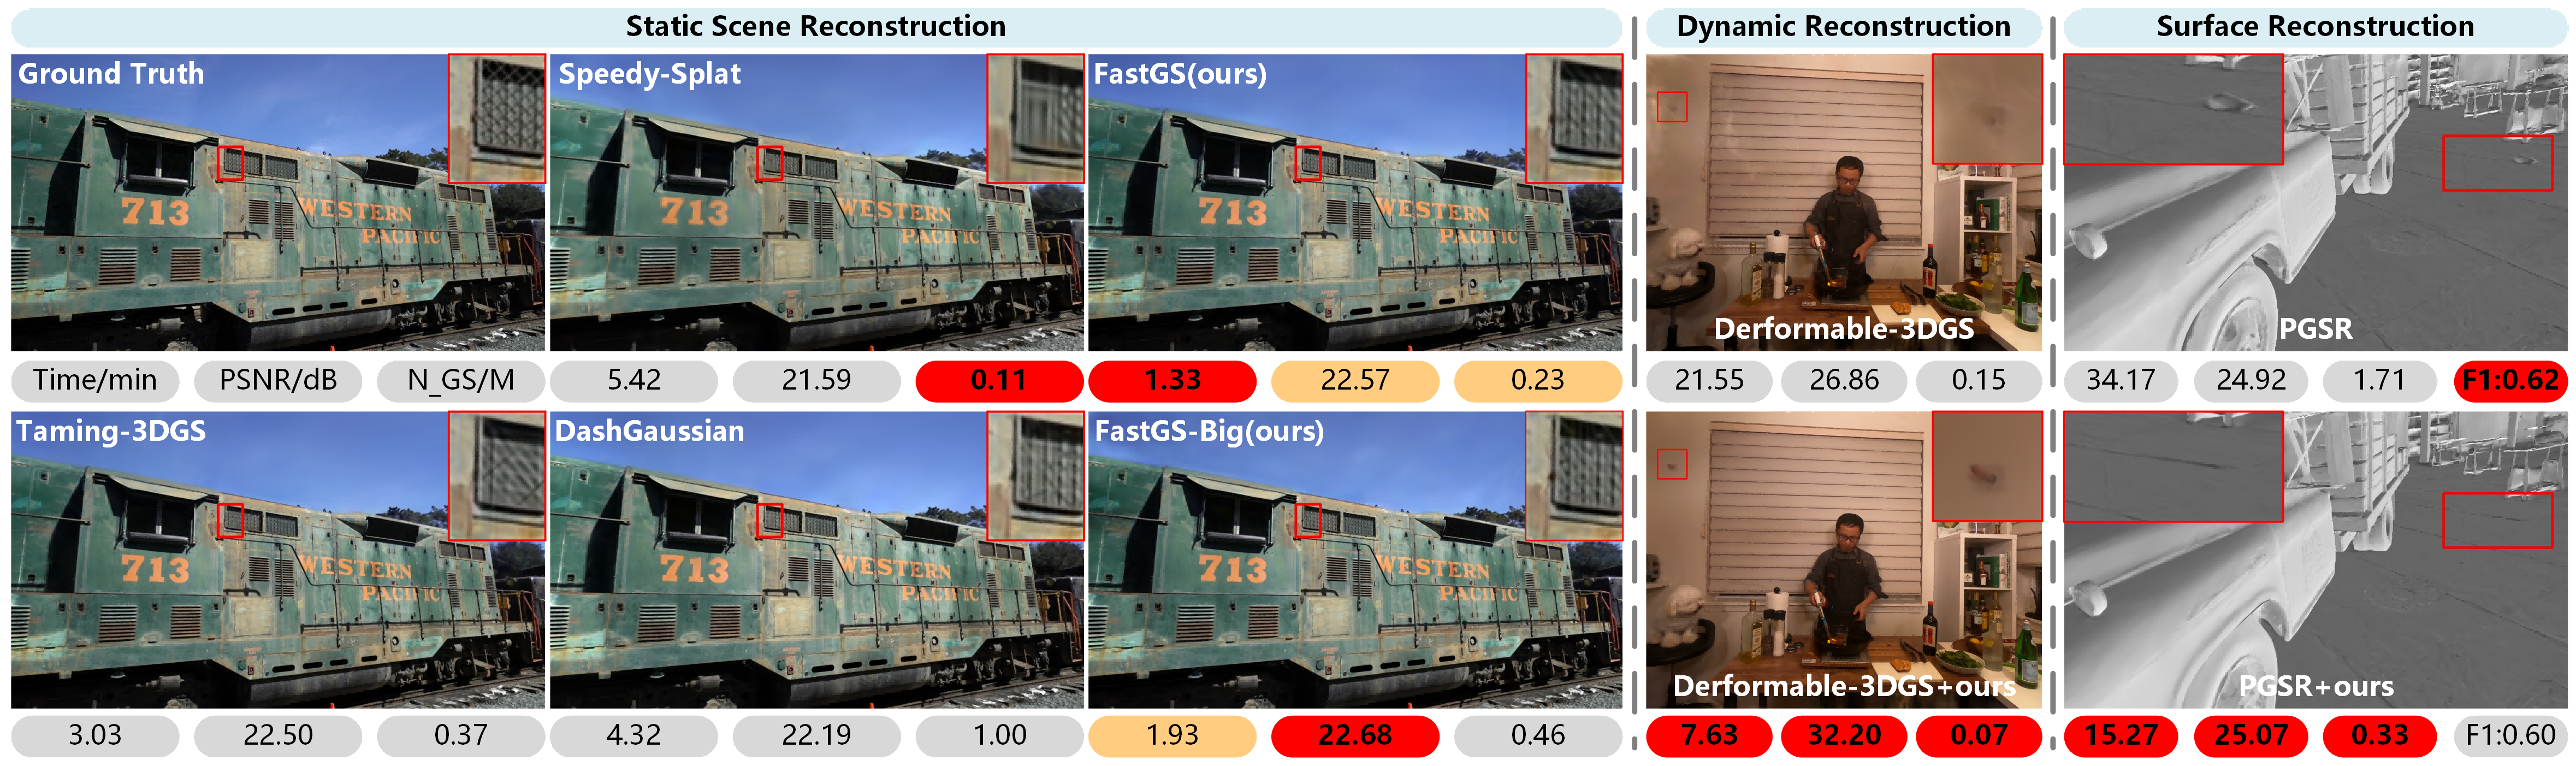
FastGS 是 CVPR 2026 收录的 3D Gaussian Splatting 加速训练方案,能在约 100 秒内完成 3DGS 训练,大幅缩短三维重建的迭代时间。
一个模型同时搞定离线与流式的语音识别、语音翻译和语音合成,无需为不同任务分别部署系统。
用 OCR 识别屏幕内容,再通过 TypeSafe 分类下一步操作并自动点击,实现每步约 0.0002 美元的 macOS 电脑操作自动化。
用星凸多边形表示做目标检测的深度学习库,专门解决显微镜图像里细胞核等密集小目标的实例分割问题。
从任意文本自动抽取实体与关系并生成知识图谱的 Python 工具,附带基准测试,方便用 LLM 构建和评测图谱抽取流程。
面向大模型量化的压缩工具包,支持 NVIDIA、AMD、Intel、华为昇腾等多硬件加速,可无缝接入 HF、vLLM 和 SGLang 推理。
纯 Python 实现的超快跨平台截图库,基于 ctypes 直接调用系统接口,能一次抓取多个显示器画面,适合做屏幕采集和自动化工具。
用 Python 写的远控木马(RAT),通过 Discord 远程操控目标机器,附带图形化构建器,能一键生成带键盘记录和密码抓取功能的恶意程序。
TrustRAG 是一个强调可靠输入与可信输出的 RAG 框架,帮你在检索增强生成流程里控制数据质量、减少幻觉,适合搭建可溯源的知识问答系统。
Linux 上的原生语音转文字工具,提供系统级听写,速度快、准确率高且数据本地处理,适合注重隐私的用户。
把 BERT 等预训练上下文向量和传统主题模型结合,用来在多种语言上抽取更连贯的主题,适合文本挖掘和主题分析。
支持电影、剧集、动漫、专辑和歌曲的下载工具,能处理 DASH、HLS、ISM 等流媒体格式及 MP4 文件,适合离线保存音视频内容。
把 Claude、Codex、Cursor 等多个 AI 编码窗口编排成协作团队,通过共享任务、确认、预检和独立评审来协调并行开发,并在本地双语面板追踪进度与证据。
基于 Vosk 和 Kaldi 的语音识别服务端,通过 WebSocket、gRPC、WebRTC 接口对外提供离线 ASR 能力,方便把语音转文字集成进自己的应用。

把 RVC、F5-TTS、Chatterbox、IndexTTS-2 等十多种本地语音合成与变声引擎集成进 ComfyUI,支持多语言、超长文本、SRT 时间轴和角色音色,一站式完成配音与音频编辑。
用逼真的合成对话模拟来诊断和优化 LLM Agent 的框架,帮助开发者在真实上线前发现并修复 Agent 的薄弱环节。
高通官方维护的预优化模型库,模型已针对延迟和内存调优,可直接部署到骁龙等高通设备上推理。

Graphite 的基于文件的时间序列数据库格式,用固定大小文件存储监控指标,解决指标数据高效读写和长期保留的问题。
给纯文本大模型补上视觉能力的工具箱,支持多图理解、长截图 OCR、前端 UI 还原和 GUI 自动化,可无缝接入 Claude Code、Codex 等主流 agent。
在 Blender 里直接导入、渲染和编辑 3D 高斯泼溅(3DGS/4DGS)模型的插件,省去格式转换,方便做动画和场景合成。

轻量级多模态模型库,能同时理解多语言文本和图像,速度比 OpenAI CLIP 和 LLaVA 快 5 倍,适合做图文检索和内容生成。
面向浏览器 AI 智能体的开源评测基准,用日常任务数据集衡量智能体在真实网页操作中的表现。

用配置驱动的 CI 流水线每天自动构建 Android 应用,省去手动打包和重复操作,适合学习自动化构建流程。

基于扩散模型的文本到音频生成工具,输入一段文字描述就能合成对应的声音片段,适合做音效生成和音频内容创作。

把 COCO、LabelMe、Labelbox、VoTT 等格式的 JSON 标注转成 YOLO 训练格式,适合做目标检测数据集迁移;官方已建议改用 Ultralytics 包里的 convert_coco()。
带图形界面的哔哩哔哩漫画下载器,支持关键词搜索、二维码登录、多线程下载和多种保存格式,还能管理本地漫画并一键检查更新。
用张量分解来建模和重建辐射场,把 NeRF 的显存占用和训练时间大幅压下来,同时保持渲染质量。

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。
腾讯混元开源的多模态定制视频生成架构,支持音频驱动、图生视频和视频编辑,可按输入条件生成定制化视频内容。
基于知识图谱为 LLM 微调合成高质量问答数据,把结构化知识转成训练语料,缓解监督微调数据稀缺。
把 AI/ML 模型打包成可直接上线的推理服务,省去手写 Docker 和部署脚本的麻烦,一条命令就能跑起来。
一个自动进化框架,用多智能体像 7×24 小时算法团队一样持续迭代优化任意目标,适合需要自动调优和自改进的场景。