发布包为 .7z 或 .7z.exe 自解压包,需先解压再运行 Umi-OCR.exe,不能直接当安装程序用;Scoop 的 umi-ocr 与 umi-ocr-paddle 不要同时安装,快捷方式可能被覆盖;识别超大长图或大图需在页面设置中调高「限制图像边长」数值。

Umi-OCR
hiroi-soraMIT更新放缓开源免费的离线 OCR 软件,支持截图、批量图片和 PDF 识别,可排除水印与页眉页脚,还能扫描或生成二维码,内置多国语言库。
OCR software, free and offline. 开源、免费的离线OCR软件。支持截屏/批量导入图片,PDF文档识别,排除水印/页眉页脚,扫描/生成二维码。内置多国语言库。
v2.1.5发布于 2025-03-25 16:31 UTC48,567star +72 / 7 天4,739fork同步于 2026-11-10 23:20 UTC
解压发布包后运行 Umi-OCR.exe;Scoop 安装:scoop bucket add extras 然后 scoop install extras/umi-ocr 硬件要求按 README 说明
README 未说明具体显存或 GPU 要求;软件为离线运行,适用于 Windows7 x64 与 Linux x64,界面默认支持显卡加速渲染,出现截屏闪烁或 UI 错位时可切换渲染器或关闭硬件加速。
免费开源的离线OCR软件,解压即用,支持截图、批量图片和PDF识别
开源免费的离线 OCR 软件,支持截图、批量图片和 PDF 识别,可排除水印与页眉页脚,还能扫描或生成二维码,内置多国语言库。
核心能力
- 截图OCR支持快捷键唤起与粘贴图片识别
- 批量OCR可一次导入几百张图片并导出txt/jsonl/md/csv
- 用忽略区域矩形框排除水印和页眉页脚文字
- 文档识别可将扫描件输出为双层可搜索PDF
- 提供命令行与HTTP接口供外部调用
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
- v2.1.5Umi-OCR v2.1.5最新正式版2025-03-25 · 2025-03-25 16:31 UTC
Umi-OCR 三周年撒花~~
v2.1.5 主要更新:
- 新增:日志机制。在命令行中启动 Umi-OCR 可查看实时日志。指定级别以上(默认为ERROR)的日志被保存到
Umi-OCR/UmiOCR-data/logs目录中,保存级别可以在全局设置标签页中更改。 - 新增:大部分标签页能手动切换左右/上下双栏模式。 (#789)
- 新增:Esc键隐藏主窗口。 (#652)
- 新增:调整二维码生成相关参数后,自动刷新二维码生成。 (#690)
- 新增:命令行指令
--reload,用于重新加载配置文件。 👉 文档 - 修复:文档识别提取PDF自带的文本内容时,未考虑页面旋转的影响。 (#785)
- 修复:文档识别生成单层PDF时,未写入原PDF自带的文本内容。
- 修复:OCR结果展示列表的一些显示Bug和鼠标划选Bug。
- 修复:调整标签页顺序或删除标签页后,未及时保存顺序信息。
- 修复:HTTP接口
/api/doc/download参数ignore_blank的错误。 - 修复:Linux版本截图时,系统任务栏推移顶层窗口,导致截图位置偏移。 (#778)
- 修复:Linux版本截图后,主窗口的位置与操作前不一致。
- 优化:图片/文档的异步加载机制。现在可以流畅地加载含有数万个子文件的文件夹,且能预览加载进度。 (#710)
- Windows 版本更新第三方依赖库:
PyMuPDF 1.24.11,fontTools 4.56.0,Pillow 10.4.0,psutil 10.4.0,pynput 1.8.0,zxing-cpp 2.3.0 - 新增UI语言:俄语
Русский,译者:Вячеслав Анатольевич Малышев、Muhammadyusuf Kurbonov。泰米尔语தமிழ்,译者:தமிழ்நேரம்。
Windows 下载
不同版本仅OCR引擎插件不同,其它功能完全一致,附带多国语言识别库。
.7z.exe为自解压包,可以用压缩软件打开,也可以在没有安装压缩软件的电脑上直接双击解压。Paddle 引擎插件版
(性能好,速度快,占用率高,适合高配机器。不兼容奔腾、赛扬、凌动CPU)
重要提示:如果执行OCR时报错
0xc0000142、[Error] OCR init fail,大概率是CPU不兼容Paddle,请换用Rapid版本。Umi-OCR_Paddle_v2.1.5.7z.exe (128MB) SHA256:
abe00248d6e68dda75029739751ad7258f0ecc14d720b19240a844f5341859b2Rapid 引擎插件版
(速度稍慢,内存占用低,适合低配机器,兼容性好)
Umi-OCR_Rapid_v2.1.5.7z.exe (98.5MB) SHA256:
659c55896c32a5e019dc7bde1713d0e5c73186a2c653bed84c4480fa1795b722更多下载途径: 蓝奏云 | SourceForge | Scoop
Linux 下载
Umi-OCR_Linux_Paddle_2.1.5.tar.xz (264.5MB) SHA256:
7ff32e5dc818d67171820545100433c86e7e71155f9bad0851fad2ced9588f9b首次运行请在命令行中执行
./umi-ocr.sh,随后可在全局设置中创建桌面/开始菜单快捷方式,便于日常使用。Docker 部署
- 新增:日志机制。在命令行中启动 Umi-OCR 可查看实时日志。指定级别以上(默认为ERROR)的日志被保存到
- v2.1.4Umi-OCR v2.1.42024-08-31 · 2024-08-31 09:39 UTC
查看更新说明
v2.1.4 主要更新:
- 修复:引擎原始输出项的"text"为空时,导致文本分析越界的错误。 (#625)
- 新增UI语言:葡萄牙语
Português。译者:@杨鹏 - PaddleOCR 插件相关:
- 修复:布尔类型选项不生效的问题。
- 修复:
繁体中文配置文件错误的问题。 - 优化:调整默认线程/内存限制,默认内存占用不超过系统总内存的一半。
- 优化:调整识别语言库结构,精简不必要的文件。
- Linux 版本相关:
- 优化:
glibc依赖降级至2.31,兼容Debian-11等发行版。 - 修复:Docker 部署 在部分旧系统中报错
'code': 803的问题。(#621)
- 优化:
Windows 下载
不同版本仅OCR引擎插件不同,其它功能完全一致,附带多国语言识别库。
.7z.exe为自解压包,可以用压缩软件打开,也可以在没有安装压缩软件的电脑上直接双击解压。Paddle 引擎插件版
(性能好,速度快,占用率高,适合高配机器。不兼容奔腾、赛扬、凌动CPU)
重要提示:如果执行OCR时报错
0xc0000142、[Error] OCR init fail,大概率是CPU不兼容Paddle,请换用Rapid版本。Umi-OCR_Paddle_v2.1.4.7z.exe (126.5MB) SHA256:
319edf4d58803ed5482174dcaf8713248cc377a77d9164fcc28796ade591348bRapid 引擎插件版
(速度稍慢,内存占用低,适合低配机器,兼容性好)
Umi-OCR_Rapid_v2.1.4.7z.exe (97MB) SHA256:
c1e851b172437f383ffb6ec1f3236e1beab23c0d7bfd6ba84ffea8f720126471更多下载途径: 蓝奏云 | SourceForge | Scoop
Linux 下载
Umi-OCR_Linux_Paddle_2.1.4.tar.xz (264.5MB) SHA256:
0dae3a93eb4fc8da23097944f403d143430ec27a91ce3fa563ac5d363b69246e此发行版在
Ubuntu 22.04/Debian 11/Debian 12/Kali 2023.3桌面环境中通过测试。如果遇到问题,可参考 常见问题及修复方法 ,或根据报错安装缺失的依赖库。欢迎提 Issue 共同讨论解决方法。有能力的用户可尝试 从源码部署 Umi-OCR ,以得到最好的兼容性。首次运行请在命令行中执行
./umi-ocr.sh,随后可在全局设置中创建桌面/开始菜单快捷方式,便于日常使用。Docker 部署
- v2.1.3Umi-OCR v2.1.32024-07-23 · 2024-07-23 17:40 UTC
查看更新说明
v2.1.3 主要更新:
bate.1 版本之后的更新:
- 修复:HTTP文档识别接口上传的文件名含非ascii字符时,该字符可被保留。
- 优化:HTTP文档识别接口的 Python示例 和 Html示例 代码。
- 优化:排版解析的 单栏-单行 方案,对于间隔较大的两个相邻文本块,会添加空格作为间隔符。
Windows7 和 Linux 用户注意: 常见问题及修复方法
Windows 下载
不同版本仅OCR引擎插件不同,其它功能完全一致,附带多国语言识别库。
.7z.exe为自解压包,可以用压缩软件打开,也可以在没有安装压缩软件的电脑上直接双击解压。Paddle 引擎插件版
(性能好,速度快,占用率高,适合高配机器。不兼容奔腾、赛扬、凌动CPU)
重要提示:如果执行OCR时报错
0xc0000142、[Error] OCR init fail,大概率是CPU不兼容Paddle,请换用Rapid版本。Umi-OCR_Paddle_v2.1.3.7z.exe (134MB) SHA256:
27f5eb5097ba8fe95bf8247cb186c9c8518f6c8268b4f5d828e2e80b9e40be34Rapid 引擎插件版
(速度稍慢,内存占用低,适合低配机器,兼容性好)
Umi-OCR_Rapid_v2.1.3.7z.exe (97MB) SHA256:
de945941f785b9bbf6c7c5d82a5736c9b14a777d3503966c5ea110ac21ebc816Linux 下载
Umi-OCR_Debian_x64_Paddle_2.1.3.tar.xz (273MB) SHA256:
6d9596eaf482d4a37452bf8e960586fc66605d9c96047927270128a0a3a416fd此发行版在
Ubuntu 22.04/Debian 12.5/Kali 2023.3桌面环境中通过测试。由于 Linux 平台的多样化,发行版不一定能在所有环境中正常运行。如果遇到问题,可参考 常见问题及修复方法 ,或根据报错安装缺失的依赖库。欢迎提 Issue 共同讨论解决方法。有能力的用户可尝试 从源码部署 Umi-OCR ,以得到最好的兼容性。首次运行请在命令行中执行
./umi-ocr.sh,随后可在全局设置中创建桌面/开始菜单快捷方式,便于日常使用。鸣谢
- @Gavin1937 为 PaddleOCR-json引擎 兼容 Linux 做出的大量贡献。
更多下载途径: 蓝奏云 | SourceForge | Scoop | Docker 部署
- v2.1.3.beta.1Umi-OCR v2.1.3 beta.1pre-release2024-07-13 · 2024-07-13 15:33 UTC
查看更新说明
v2.1.3 beta.1 测试版 主要更新:
- 新推出 Linux 平台版本。
- 新增:HTTP 文档识别接口。👉 文档
- 修复:文档中宽高为0的异常图片会导致任务卡住。 (#562)
Windows7 和 Linux 用户注意: 常见问题及修复方法
Windows 下载
不同版本仅OCR引擎插件不同,其它功能完全一致,附带多国语言识别库。
.7z.exe为自解压包,可以用压缩软件打开,也可以在没有安装压缩软件的电脑上直接双击解压。Paddle 引擎插件版
(性能好,速度快,占用率高,适合高配机器。不兼容奔腾、赛扬、凌动CPU)
重要提示:如果执行OCR时报错
0xc0000142、[Error] OCR init fail,大概率是CPU不兼容Paddle,请换用Rapid版本。Umi-OCR_Paddle_v2.1.3.beta.1.7z.exe (134.4MB) SHA256:
81e9b1af8c3d9f81050c13ab57fc26939ad1a77239336fbd78a0a4582d88a8b0Rapid 引擎插件版
(速度稍慢,内存占用低,适合低配机器,兼容性好)
Umi-OCR_Rapid_v2.1.3.beta.1.7z.exe (97.0MB) SHA256:
07bffac520eeee6442e2516db20c08a20b8a100a780fb718b9a3b15eae5bddfaLinux 下载
Umi-OCR_Linux_x86-64_Paddle_2.1.3.beta.1.tar.xz (274.8MB) SHA256:
c566a6277cdde064edd9dae71951ce06caf1b8454fd7b3746711dd15b3b619d7此发行版在
Ubuntu 22.04/Debian 12.5/Kali 2023.3上通过测试。由于 Linux 平台的多样化,不保证能在任何系统中正常使用。如果使用时遇到问题,欢迎提 Issue 共同讨论解决方法。有能力的用户可尝试 从源码部署 Umi-OCR ,以得到最好的兼容性。
首次运行请在命令行中执行
./umi-ocr.sh,随后可在全局设置中创建桌面/开始菜单快捷方式,便于日常使用。更多插件
前往 Umi-OCR_插件仓库 ,下载更多OCR插件,获取
离线数学公式识别等附加功能。鸣谢
- @Gavin1937 为 PaddleOCR-json引擎 兼容 Linux 做出的大量贡献。
- v2.1.2Umi-OCR v2.1.22024-06-03 · 2024-06-03 13:46 UTC
查看更新说明
v2.1.2 主要更新
- 新增:批量任务(图片、文档)支持 暂停任务 。只要不退出软件,在待机/休眠后可以恢复任务。
- 新增:文档任务支持保存为 单层纯文本PDF 。
- 新增:HTTP OCR接口 允许设置 忽略区域 参数。👉 文档
- 新增:HTTP 二维码接口 允许设置 图像预处理 参数。👉 文档
- 新增:命令行
--screenshot允许 指定屏幕范围 ,自动进行截图。👉 文档 - 修复:文档内容提取和写入时的坐标旋转、比例适配问题。
- 修复:截图预览 & 记录面板中,跨区块复制文本时,尾块的复制字数不正确。
- 修复:文档识别 整页强制OCR 模式下,无法进行任务。(2024.6.5紧急修复)
- 优化:批量文档标签页,拖入大量文件、提交大批任务时的性能和流畅度。
- 优化:文档任务保存的文件名规则。
- UI:优化一些布局,调整一些文本,美化一些视觉效果。
Windows7 用户注意: 常见问题及修复方法
Linux 用户:可尝试使用 最新测试版本
新开通了赞助方式 爱发电 ,有意愿的用户可以支持一下~
Umi-OCR 保证始终 开源 和 完全免费 。所有需要付费/注册/关注才能下载的渠道均 不是 我们发布的渠道,请注意辨别。
配置文件迁移
Umi-OCR v2 用户升级时,将旧版软件的
UmiOCR-data/.settings拷贝到新版相同位置即可。下载说明
不同版本仅OCR引擎插件不同,其它功能完全一致。 均支持 win7 x64 及以上的系统,附带多国语言识别库。
.7z.exe为自解压包,可以用压缩软件打开,也可以在没有安装压缩软件的电脑上直接双击解压。Paddle 引擎插件版
(性能好,速度快,占用率高,适合高配机器。不兼容奔腾、赛扬、凌动CPU)
重要提示:如果执行OCR时报错
0xc0000142、[Error] OCR init fail,大概率是CPU不兼容Paddle,请换用Rapid版本。Umi-OCR_Paddle_v2.1.2.7z.exe (128.5MB) SHA256:
6dce23ea7f95a2ffb9415f8f5bb588df75ddf90abdcbbb972cc38fe2dbbfc70dRapid 引擎插件版
(速度稍慢,内存占用低,适合低配机器,兼容性好)
Umi-OCR_Rapid_v2.1.2.7z.exe (97.1MB) SHA256:
879484ca912814702c30ba4dc0d9a5afff1ba0457c2fca2825ef7ea7adcde7b4更多插件
前往 Umi-OCR_插件仓库 ,下载更多OCR插件,获取
离线数学公式识别等附加功能。
更多下载途径: 蓝奏云 | SourceForge | Scoop
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。
- 免费:本项目所有代码开源,完全免费。
- 方便:解压即用,离线运行,无需网络。
- 高效:自带高效率的离线OCR引擎,内置多种语言识别库。
- 灵活:支持命令行、HTTP接口等外部调用方式。
- 功能:截图OCR / 批量OCR / PDF识别 / 二维码 / 公式识别
目录
- 截图识别
- 排版解析 - 识别不同排版,按正确顺序输出文字
- 批量识别
- 忽略区域 - 排除截图水印处的文字
- 二维码 支持扫码或生成二维码图片
- 文档识别 从PDF扫描件中提取文本,或转为双层可搜索PDF
- 全局设置
- 命令行调用
- HTTP接口
- 构建项目(Windows、Linux)
使用源码
开发者请务必阅读 构建项目 。
下载发行版
以下发布链接均长期维护,提供稳定版本的下载。
- 蓝奏云 https://hiroi-sora.lanzoul.com/s/umi-ocr (国内推荐,免注册/无限速)
- GitHub https://github.com/hiroi-sora/Umi-OCR/releases/latest
- Source Forge https://sourceforge.net/projects/umi-ocr
Scoop 是一款Windows下的命令行安装程序,可方便地管理多个应用。您可以先安装 Scoop ,再使用以下指令安装 Umi-OCR :
- 添加
extras桶:
scoop bucket add extras
- (可选1)安装 Umi-OCR(自带
Rapid-OCR引擎,兼容性好):
scoop install extras/umi-ocr
- (可选2)安装 Umi-OCR(自带
Paddle-OCR引擎,速度稍快):
scoop install extras/umi-ocr-paddle
- 不要同时安装二者,快捷方式可能会被覆盖。但您可以额外导入 插件 ,随时切换不同OCR引擎。
开始使用
软件发布包下载为 .7z 压缩包或 .7z.exe 自解压包。自解压包可在没有安装压缩软件的电脑上,解压文件。
本软件无需安装。解压后,点击 Umi-OCR.exe 即可启动程序。
遇到任何问题,请提 Issue ,我会尽可能帮助你。
界面语言
Umi-OCR 支持的界面多国语言。在第一次打开软件时,将会按照你的电脑的系统设置,自动切换语言。
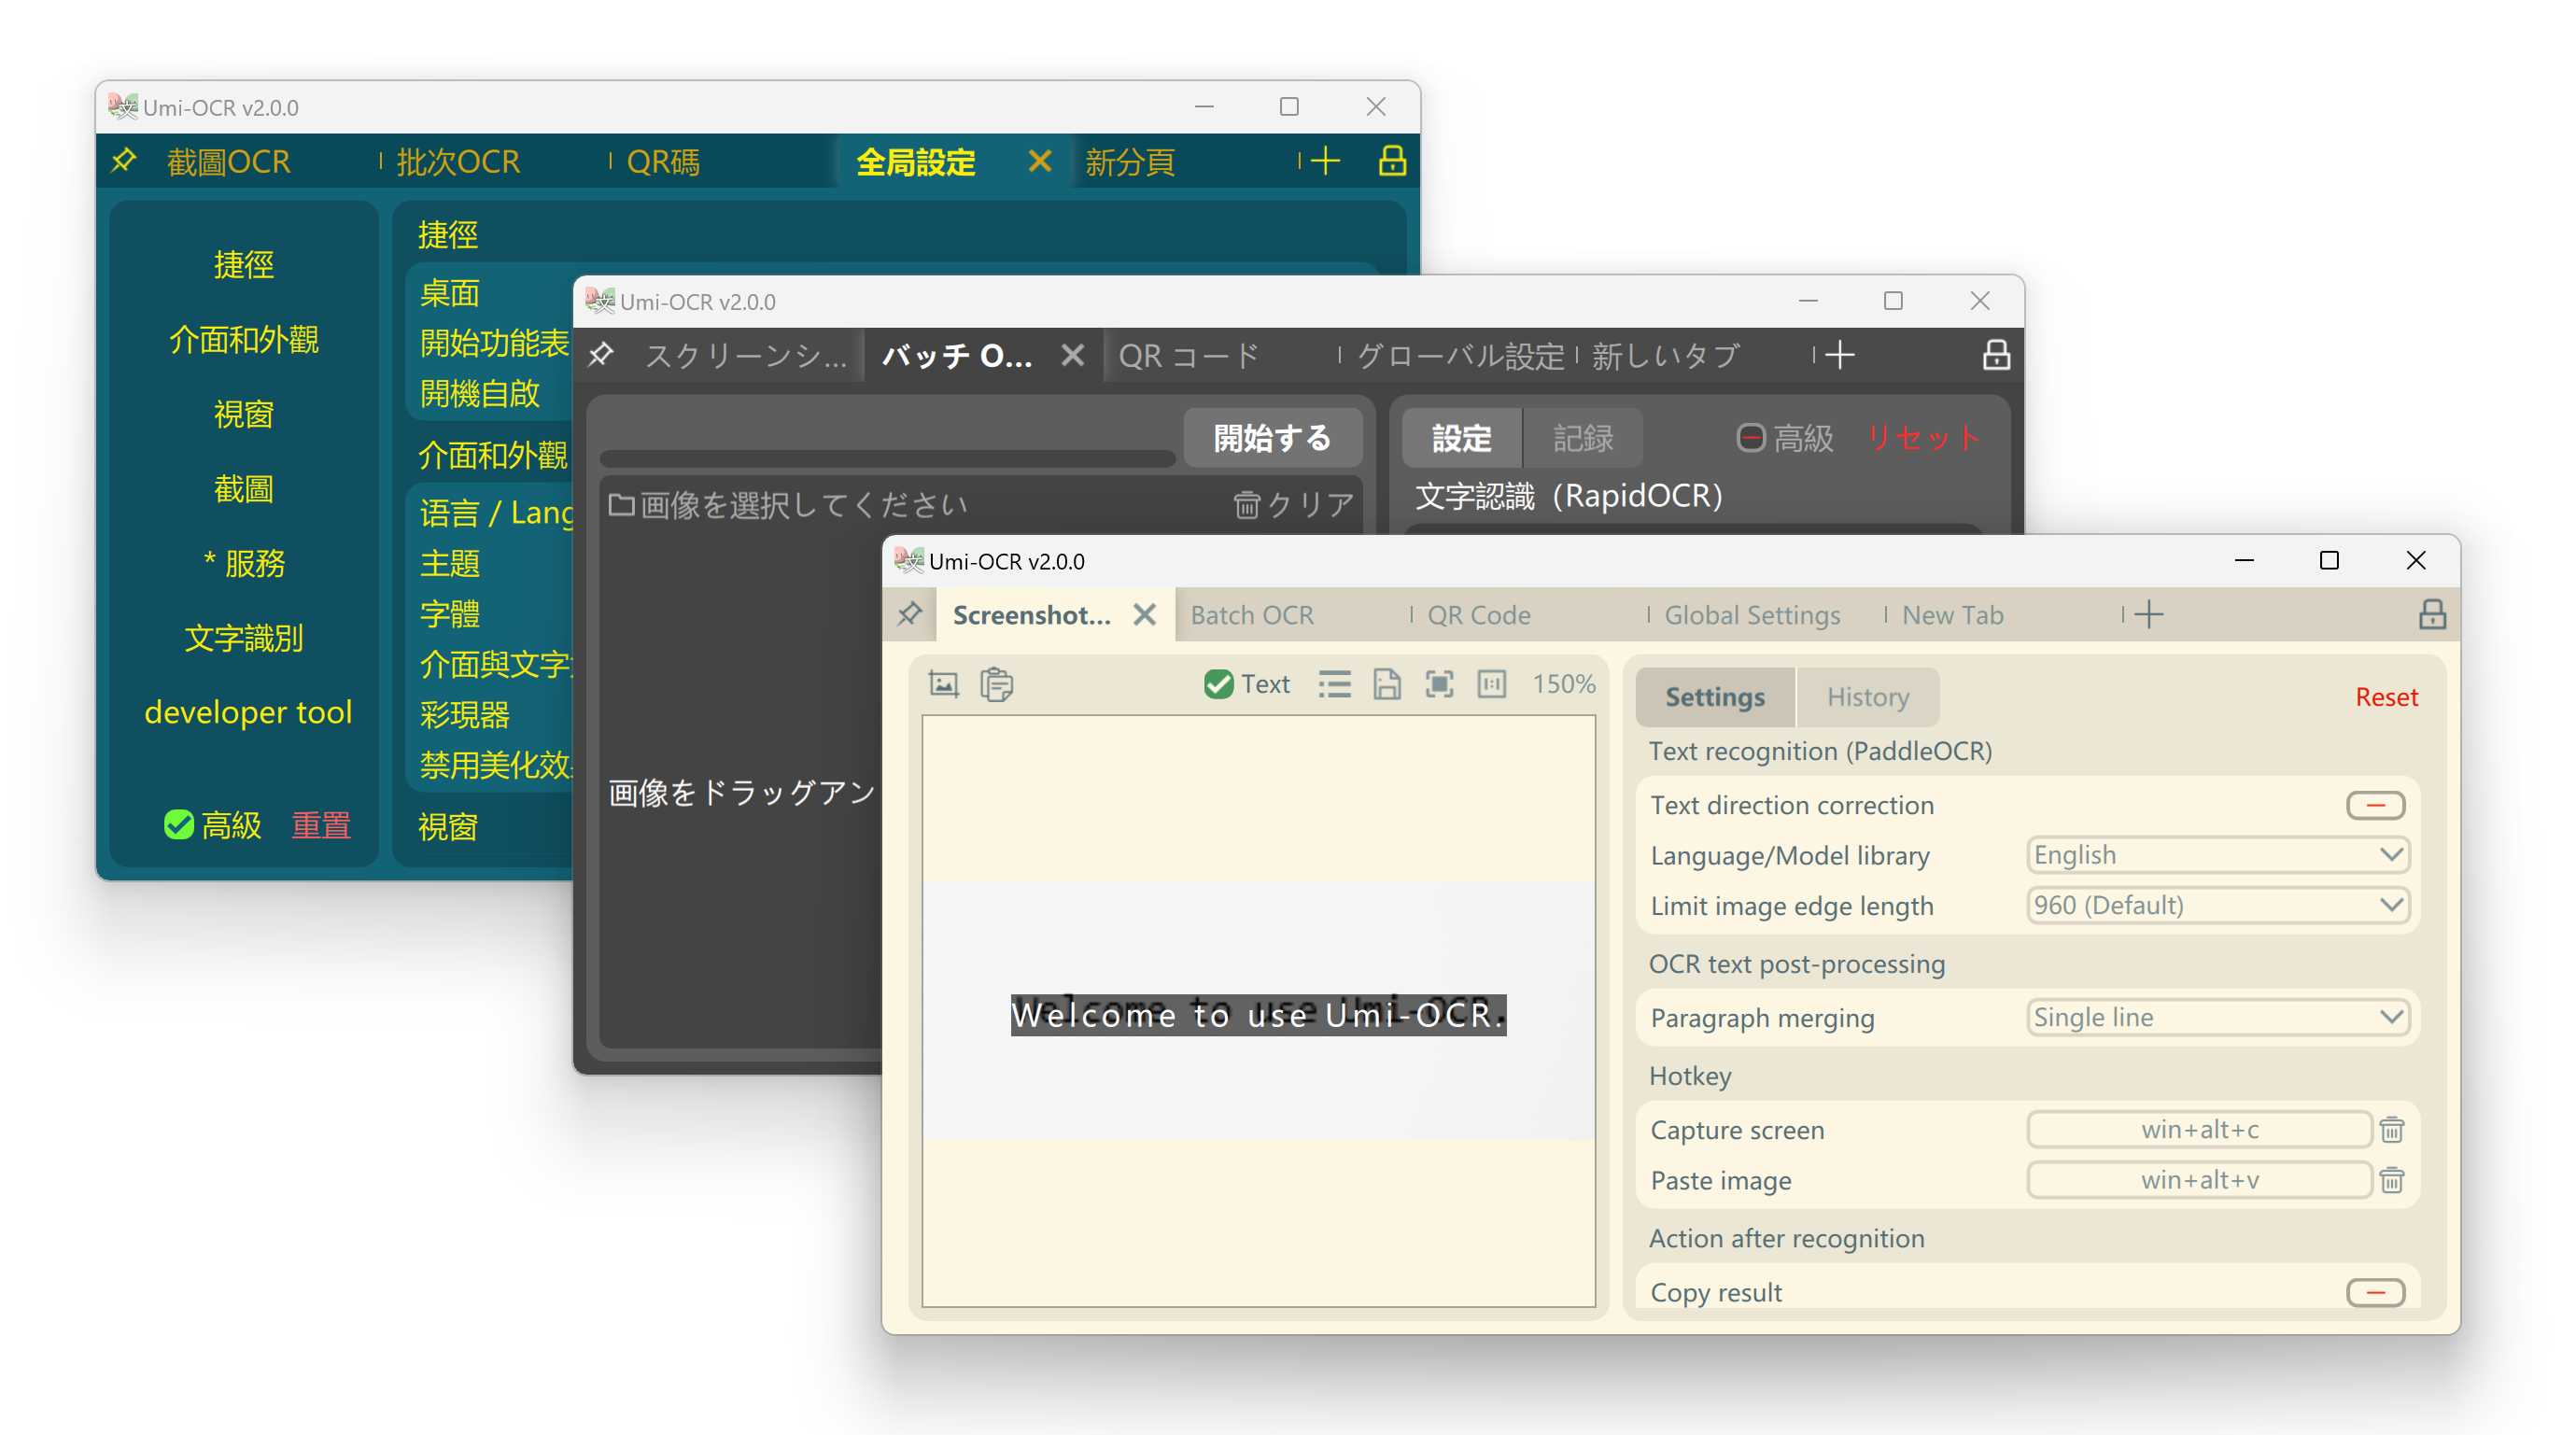
如果需要手动切换语言,请参考下图,全局设置→语言/Language 。
标签页
Umi-OCR v2 由一系列灵活好用的标签页组成。您可按照自己的喜好,打开需要的标签页。
标签栏左上角可以切换窗口置顶。右上角能够锁定标签页,以防止日常使用中误触关闭标签页。
截图OCR
截图OCR:打开这一页后,就可以用快捷键唤起截图,识别图中的文字。
- 左侧的图片预览栏,可直接用鼠标划选复制。
- 右侧的识别记录栏,可以编辑文字,允许划选多个记录复制。
- 也支持在别处复制图片,粘贴到Umi-OCR进行识别。
- 关于 公式识别 功能
文本后处理
关于 OCR文本后处理 - 排版解析方案: 可以整理OCR结果的排版和顺序,使文本更适合阅读和使用。预设方案:
多栏-按自然段换行:适合大部分情景,自动识别多栏布局,按自然段规则进行换行。多栏-总是换行:每段语句都进行换行。多栏-无换行:强制将所有语句合并到同一行。单栏-按自然段换行/总是换行/无换行:与上述类似,不过 不区分多栏布局。单栏-保留缩进:适用于解析代码截图,保留行首缩进和行中空格。不做处理:OCR引擎的原始输出,默认每段语句都进行换行。
上述方案,均能自动处理横排和竖排(从右到左)的排版。(竖排文字还需要OCR引擎本身支持)
批量OCR
批量OCR:这一页用于批量导入本地图片进行识别。
- 支持格式:
jpg, jpe, jpeg, jfif, png, webp, bmp, tif, tiff。 - 保存识别结果的支持格式:
txt, jsonl, md, csv(Excel)。 - 与截图OCR一样,支持
文本后处理功能,整理OCR文本的排版和顺序。 - 没有数量上限,可一次性导入几百张图片进行任务。
- 支持任务完成后自动关机/待机。
- 如果要识别像素超大的长图或大图,请调整:页面的设置→文字识别→限制图像边长→【调高数值】。
- 拥有特殊功能
忽略区域。
忽略区域
关于 OCR文本后处理 - 忽略区域: 批量OCR中的一种特殊功能,适用于排除图片中的不想要的文字。
- 在批量识别页的右栏设置中可进入忽略区域编辑器。
- 如上方样例,图片顶部和右下角存在多个水印 / LOGO。如果批量识别这类图片,水印会对识别结果造成干扰。
- 按住右键,绘制多个矩形框。这些区域内的文字将在任务中被忽略。
- 请尽量将矩形框画得大一些,完全包裹住水印所有可能出现的位置。
- 注意,只有处于忽略区域框内部的整个文本块(而不是单个字符)会被忽略。如下图所示,黄色边框的深色矩形是一个忽略区域。那么只有
key_mouse才会被忽略。pubsub_connector.py、pubsub_service.py这两个文本块得以保留。
文档识别
文档识别:
- 支持格式:
pdf, xps, epub, mobi, fb2, cbz。 - 对扫描件进行OCR,或提取原有文本。可输出为 双层可搜索PDF 。
- 支持设定 忽略区域 ,可用于排除页眉页脚的文字。
- 可设置任务完成后 自动关机/休眠 。
二维码
扫码:
- 截图/粘贴/拖入本地图片,读取其中的二维码、条形码。
- 支持一图多码。
- 支持19种协议,如下:
Aztec,Codabar,Code128,Code39,Code93,DataBar,DataBarExpanded,DataMatrix,EAN13,EAN8,ITF,LinearCodes,MatrixCodes,MaxiCode,MicroQRCode,PDF417,QRCode,UPCA,UPCE
生成码:
- 输入文本,生成二维码图片。
- 支持19种协议和纠错等级等参数。
全局设置
全局设置:在这里可以调整软件的全局参数。常用功能如下:
- 一键添加快捷方式或设置开机自启。
- 更改界面语言。Umi支持繁中、英语、日语等语言。
- 切换界面主题。Umi拥有多个亮/暗主题。
- 调整界面文字的大小和字体。
- 切换OCR插件。
- 渲染器:软件界面默认支持显卡加速渲染。如果在你的机器上出现截屏闪烁、UI错位的情况,请调整
界面和外观→渲染器,尝试切换到不同渲染方案,或关闭硬件加速。
调用接口:
关于项目结构
各仓库:
工程结构:
** 后缀表示本仓库(主仓库)包含的内容。
Umi-OCR
├─ Umi-OCR.exe
├─ umi-ocr.sh
└─ UmiOCR-data
   ├─ main.py **
   ├─ version.py **
   ├─ qt_res **
   │  └─ 项目qt资源,包括图标和qml源码
   ├─ py_src **
   │  └─ 项目python源码
   ├─ plugins
   │  └─ 插件
   └─ i18n **
      └─ 翻译文件
支持的离线OCR引擎:
运行环境框架:
- PyStand 定制版
构建项目
请跳转下述仓库,完成对应平台的开发/运行环境部署。
软件本地化翻译:
本项目使用 Weblate 平台进行UI界面的本地化翻译协作。我们欢迎任何译者参与翻译工作,您可进入此链接 Weblate: Umi-OCR ,在线校对、补充现有语言,或添加新语言。
感谢以下译者,为 Umi-OCR 贡献了本地化翻译工作:
| 译者 | 贡献语言 |
|---|---|
| bob | English, 繁體中文, 日本語 |
| Qingzheng Gao | English, 繁體中文 |
| Weng, Chia-Ling | English, 繁體中文 |
| linzow | English, 繁體中文 |
| Marcos i | English, Português |
| Eric Guo | English |
| steven0081 | English |
| Brandon Cagle | English |
| plum7x | 繁體中文 |
| hugoalh | 繁體中文 |
| Anarkiisto | 繁體中文 |
| ドコモ光 | 日本語 |
| 杨鹏 | Português |
| Вячеслав Анатольевич Малышев | Русский |
| Muhammadyusuf Kurbonov | Русский |
| தமிழ்நேரம் | தமிழ் |
如果有信息错误或人员缺漏,请在 这个讨论 中回复。
赞助
Umi-OCR 项目主要由作者 hiroi-sora 用业余时间在开发和维护。如果您喜欢这款软件,欢迎赞助。
- 国内用户可通过 爱发电 赞助作者。
Star History
更新日志
开发计划
- 标签页框架。
- OCR API控制器。
- OCR 任务控制器。
- 主题管理器,支持切换浅色/深色主题主题。
- 实现 批量OCR。
- 实现 截图OCR。
- 快捷键机制。
- 系统托盘菜单。
- 文本块后处理(排版优化)。
- 引擎内存清理。
- 软件界面多国语言。
- 命令行模式。
- Win7兼容。
- Excel(csv)输出格式。
Esc中断截图操作- 外置主题文件
- 字体切换
- 加载动画
- 忽略区域。
- 二维码识别。
- 批量识别页面的图片预览窗口。
- PDF识别。
- 调用本地图片浏览器打开图片。 #335
- 重复上一次截图。 #357
- 修Bug:文档识别在Windows7系统的兼容性问题。
- HTTP/命令行接口添加二维码识别/生成功能。 (#423)
- 二维码接口的文档。
- Linux 平台移植。
- HTTP 文档识别接口。
远期计划
这些是预想中的功能,在开发初期已预留好接口,将在远期慢慢实现。
但开发途中受限于实际情况,可能更改功能设计、新增及取消功能。
-
重构底层插件机制。
-
在线 OCR API 插件。
-
独立的数学公式识别插件。
-
“数学公式”标签页,提供独立的数学公式识别/Latex渲染。
-
检查更新机制。
-
排版解析之外的文本后处理模块(如保留数字、半全角字符转换、文本纠错)。
-
关键接口函数添加事件触发方式。
-
基于GPU的离线OCR。
-
图片翻译
-
离线翻译。
-
固定区域识别。
-
识别表格图片,输出为Excel。
-
历史记录系统。
-
兼容 MacOS / Ubuntu 等平台。
PaddleOCR
PaddlePaddle·Python
轻量级 OCR 工具包,能把图片和 PDF 转成结构化数据,支持 100 多种语言,方便接入 LLM 和 RAG 流程。
OCR+4文档解析 / OCR
92537+15112kv3.7.02026-09-16 03:31 UTC

MinerU
opendatalab·Python
把 PDF、Office 等复杂文档转成 LLM 可直接用的 Markdown/JSON,内置版面分析和 OCR,专为 RAG 与 Agent 工作流准备语料。
文档解析+4文档解析 / OCR
83452+1976.9kmineru-4.2.0-released2026-11-10 17:04 UTC
tesseract
tesseract-ocr·C++
老牌开源 OCR 引擎,用 LSTM 识别图片中的文字,支持上百种语言,适合做文档扫描和文本提取。
OCR引擎+4文档解析 / OCR
77449+5011k5.5.42026-11-10 18:26 UTC

docling
docling-project·Python
把 PDF、DOCX、HTML 等文档解析成结构化 Markdown 或 JSON,方便喂给大模型和 RAG 流程。
文档解析+4文档解析 / OCR
70395+1555.3kv2.150.02026-11-10 17:59 UTC