文档解析 / OCR
PDF、版面、表格与扫描件解析。
轻量级 OCR 工具包,能把图片和 PDF 转成结构化数据,支持 100 多种语言,方便接入 LLM 和 RAG 流程。

把 PDF、Office 等复杂文档转成 LLM 可直接用的 Markdown/JSON,内置版面分析和 OCR,专为 RAG 与 Agent 工作流准备语料。
老牌开源 OCR 引擎,用 LSTM 识别图片中的文字,支持上百种语言,适合做文档扫描和文本提取。

把 PDF、DOCX、HTML 等文档解析成结构化 Markdown 或 JSON,方便喂给大模型和 RAG 流程。

开源免费的离线 OCR 软件,支持截图、批量图片和 PDF 识别,可排除水印与页眉页脚,还能扫描或生成二维码,内置多国语言库。
把纸质文档扫描后自动 OCR、打标签并归档成可全文检索的个人文档管理系统,适合想彻底告别纸质文件柜的人。
一键截图或录屏的开源工具,支持区域捕获、GIF 录制、图像标注和 OCR,还能把图片、文本等文件上传到多种存储服务。

把 PDF 快速转成 Markdown 和 JSON,解析准确率高,适合喂给 RAG 或做文档结构化处理。

纯 JavaScript 实现的 OCR 库,基于 WebAssembly 在浏览器和 Node.js 中直接识别 100 多种语言的图片文字,无需后端服务。
把 PDF 解析成带坐标信息的 JSON、Markdown 或 HTML,方便喂给 RAG 和 AI 流程,同时自动生成无障碍标签。
跨平台划词翻译与截图 OCR 的桌面外壳,把各家翻译、OCR 和 TTS 接口统一到一个快捷键后面
把 PDF、DOCX、图片等复杂文档解析成干净结构化数据,方便喂给语言模型做 RAG 和检索。
一款简洁优雅的 macOS 词典翻译应用,支持划词查询、离线 OCR 识别,并聚合有道、苹果词典、OpenAI、DeepL、Google 等十余种翻译服务。
开箱即用的通用验证码识别 OCR 库,Python 直接 pip 安装即可调用,省去自己训练模型和搭环境的麻烦。
面向视觉小说和 Galgame 的翻译工具,通过文本钩子、OCR 和剪贴板等多种方式提取游戏文本,再接入翻译引擎,让玩家能顺畅阅读原文。
用 Rust 写的高性能开源文档解析器,能从 PDF 等文档中快速提取文本和 OCR 识别结果,适合给 RAG 和检索流程做预处理。

能识别复杂表格、表单和手写内容的 OCR 模型,保留完整版面布局,适合把扫描件和图片转成结构化文本喂给 RAG 或文档解析流程。

超轻量级中文 OCR 工具,总模型仅 4.7M,支持竖排文字识别,可在 ncnn、MNN、TNN 等推理后端运行,适合端侧和低资源场景部署。
高性能 Python 库,用来从 PDF、EPUB 等文档中提取文本、表格和图像,并做格式转换与页面操作,适合搭建文档解析和 RAG 数据管道。
macOS 上的翻译和 OCR 工具,支持划词翻译、截图取字,并接入 ChatGPT、DeepSeek、Gemini 等多种大模型翻译服务。
本地离线从视频画面中提取硬字幕并生成 srt 文件,基于深度学习做字幕区域检测和文字识别,不用调第三方 API。

字节跳动开源的文档图像解析模型,用异构锚点提示把 PDF 和图片里的版面、文字、表格一次性解析成结构化内容,适合喂给 RAG 或做文档分析。

基于 WPF 开发的即用即走翻译与 OCR 工具,支持划词翻译、截图取字,插件机制可扩展翻译源和 OCR 引擎。

基于 ONNX Runtime、OpenVINO、PaddlePaddle 等多家推理后端的 OCR 工具包,支持多语言识别,方便在不同硬件上快速部署文字检测与识别。

聊天回复前的决策助手:读取聊天内容判断对方意图和风险,一键生成草稿供你确认后发送,支持 Android、Windows、macOS、iOS。
把 PDF、图片、音视频等各种格式的数据统一解析成结构化文本,方便直接喂给 GenAI 框架和 RAG 流程使用。
GLM-OCR 是一个基于 GLM 的图片转文字 OCR 工具,主打高精度、高速度与全面覆盖,适合文档解析和 RAG 场景下的文字提取。
跨平台截屏工具,集离线 OCR、屏幕翻译、以图搜图、录屏和滚动截屏于一体,适合需要快速提取屏幕文字并翻译的场景。
Windows 上离线可用的文件格式转换工具,内置 FFmpeg、LibreOffice、Poppler 和 Tesseract,支持图片、文档、表格、PPT、PDF、音视频及 WPS 格式互转,还能做 OCR 和批量转换。
Windows/macOS 上替代 Snipaste 和系统截图工具的本地截图录屏方案,OCR 与标注全程离线
提供 Snow Shot 截图工具和 Snow Image Viewer 看图软件的源码,集截图、录屏、OCR 和图片浏览于一体,适合需要本地桌面图像处理工具的用户。
基于深度学习的一站式 OCR 库,把文字检测、文字识别和版面分析串成流水线,支持 PyTorch 训练与微调,适合快速搭建文档解析应用。

把 PDF、扫描件和图片解析成带版面结构、表格和文本的富结构化数据,适合做文档入库和 RAG 前的预处理。
实时屏幕翻译工具,能识别游戏画面、视频硬字幕和静态文本中的文字并即时翻译,适合玩外语游戏或看无字幕视频时使用。
基于深度学习的漫画翻译辅助工具,能自动识别文字、机翻并修复原图文字区域,还支持手动编辑图像和文本。
Windows 上的轻量 OCR 截图取字工具,框选屏幕区域即可识别文字并复制,支持后台常驻和识别完成通知。
管理 BibTeX 和 BibLaTeX 文献库的桌面工具,帮研究人员整理参考文献、生成引用并统一引用格式。

跨平台文档扫描工具,支持 TWAIN、WIA、eSCL 和 SANE 协议,把纸质文件扫成 PDF 并内置 OCR 识别,Windows、Linux、macOS 都能用。
Windows 上免费开源的 PDF 编辑器,自带 PDF 2.0 引擎,能查看、批注、OCR、合并拆分、编辑文字和填表签名,不用订阅。
把 PDF、DOCX、PPT 等文档解析成 Markdown、JSON、Excel 等结构化数据,并提供云端知识代理与文档管理能力,方便接入 RAG 检索流程。
开源文档解析模型,用强化自迭代(RSI)循环做后训练,在准确率和速度上达到 SOTA,适合给 LLM 和 Agent 做 OCR 与文档理解。
用小型模型把图片里的版面、表格、数学公式和文字识别成 Markdown,支持 80 多种语言,是 Mathpix 的免费替代方案。

面向文档 AI 的 Python 工具箱,把 OCR、版面分析和表格识别串成流水线,方便从扫描件和 PDF 里抽取结构化内容。
开箱即用的漫画 AI 翻译桌面工具,自动完成日韩英漫画的 OCR 检测、原文擦除、翻译、图像修复和译文排版,并带可视化编辑器调整文本样式。
基于 CNN/ResNet/DenseNet 加 GRU/LSTM 与 CTC/交叉熵的验证码识别模型训练工具,专注训练环节,帮你快速产出可用的验证码 OCR 模型。
把 PDF、Word、PPTX 等文档和图片通过 OCR 加 Ollama 模型解析成结构化 JSON 或 Markdown,还能自动匿名化、清除 PII 敏感信息。
Go 语言封装的 Tesseract OCR 库,让 Go 程序直接调用 C++ 版 Tesseract 做图片文字识别,省去自己写 CGO 绑定。
在 PHP 里调用 Tesseract OCR 的封装库,让你不用折腾命令行就能把图片里的文字识别出来,适合做发票、截图等文档的文字提取。
用大模型对 Tesseract 的 OCR 结果做纠错、智能分块和 Markdown 排版,把扫描 PDF 转成干净可读的文本,支持本地或 API 模型。
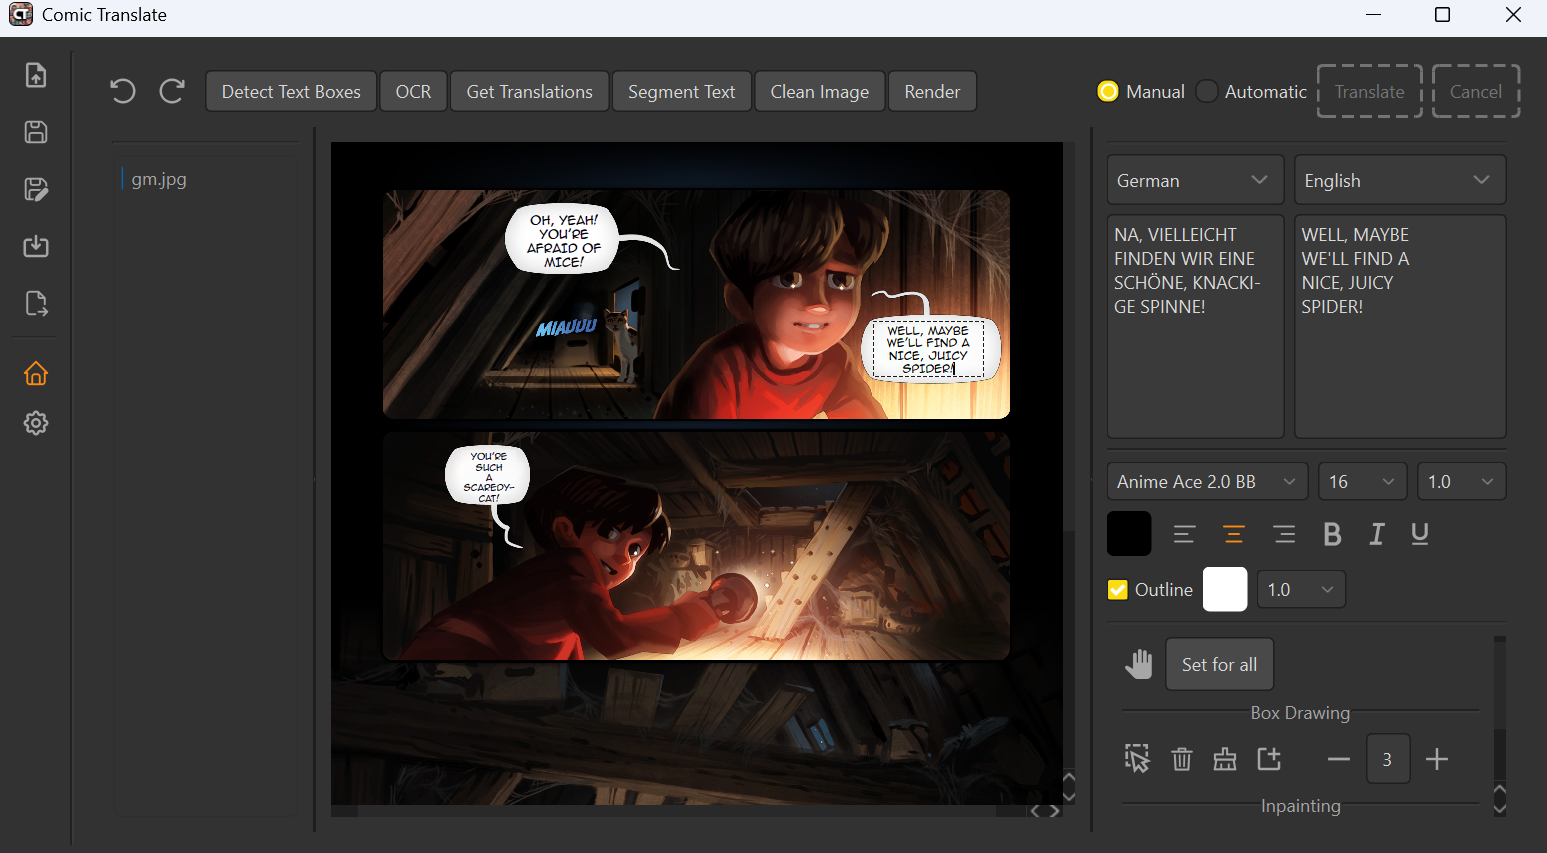
自动翻译漫画、日漫、韩漫等图片与 PDF/EPUB/CBR/CBZ 文件,集成 OCR、图像修复和机器翻译,支持多语言多格式。
开源且注重隐私的屏幕历史记录工具,可替代 Windows Recall,通过 OCR 和语义搜索随时找回你过去看过的内容。
基于 CTPN 做中文场景文字检测、CRNN+CTC 做识别的端到端 OCR 老项目,适合拿来跑通中文自然场景文字识别的完整流程。
Open Source Document Management System for Digital Archives (Scanned Documents)
给 paperless-ngx 文档管理系统接上大模型,用 LLM 和视觉 OCR 自动识别扫描件内容、生成标题和标签,让文档数字化更省事。
面向日文漫画的 OCR 工具,能识别漫画中的对话气泡和拟声词等文字,基于 Transformers 实现,适合做漫画翻译或文本提取。
截图后直接识别图中文字并复制到剪贴板,省去手动输入,支持多平台,适合从图片、PDF 或界面中快速提取文本。
在保留原始版面、公式和结构的前提下翻译 PDF,适合科研论文和技术文档,避免译文打乱排版。
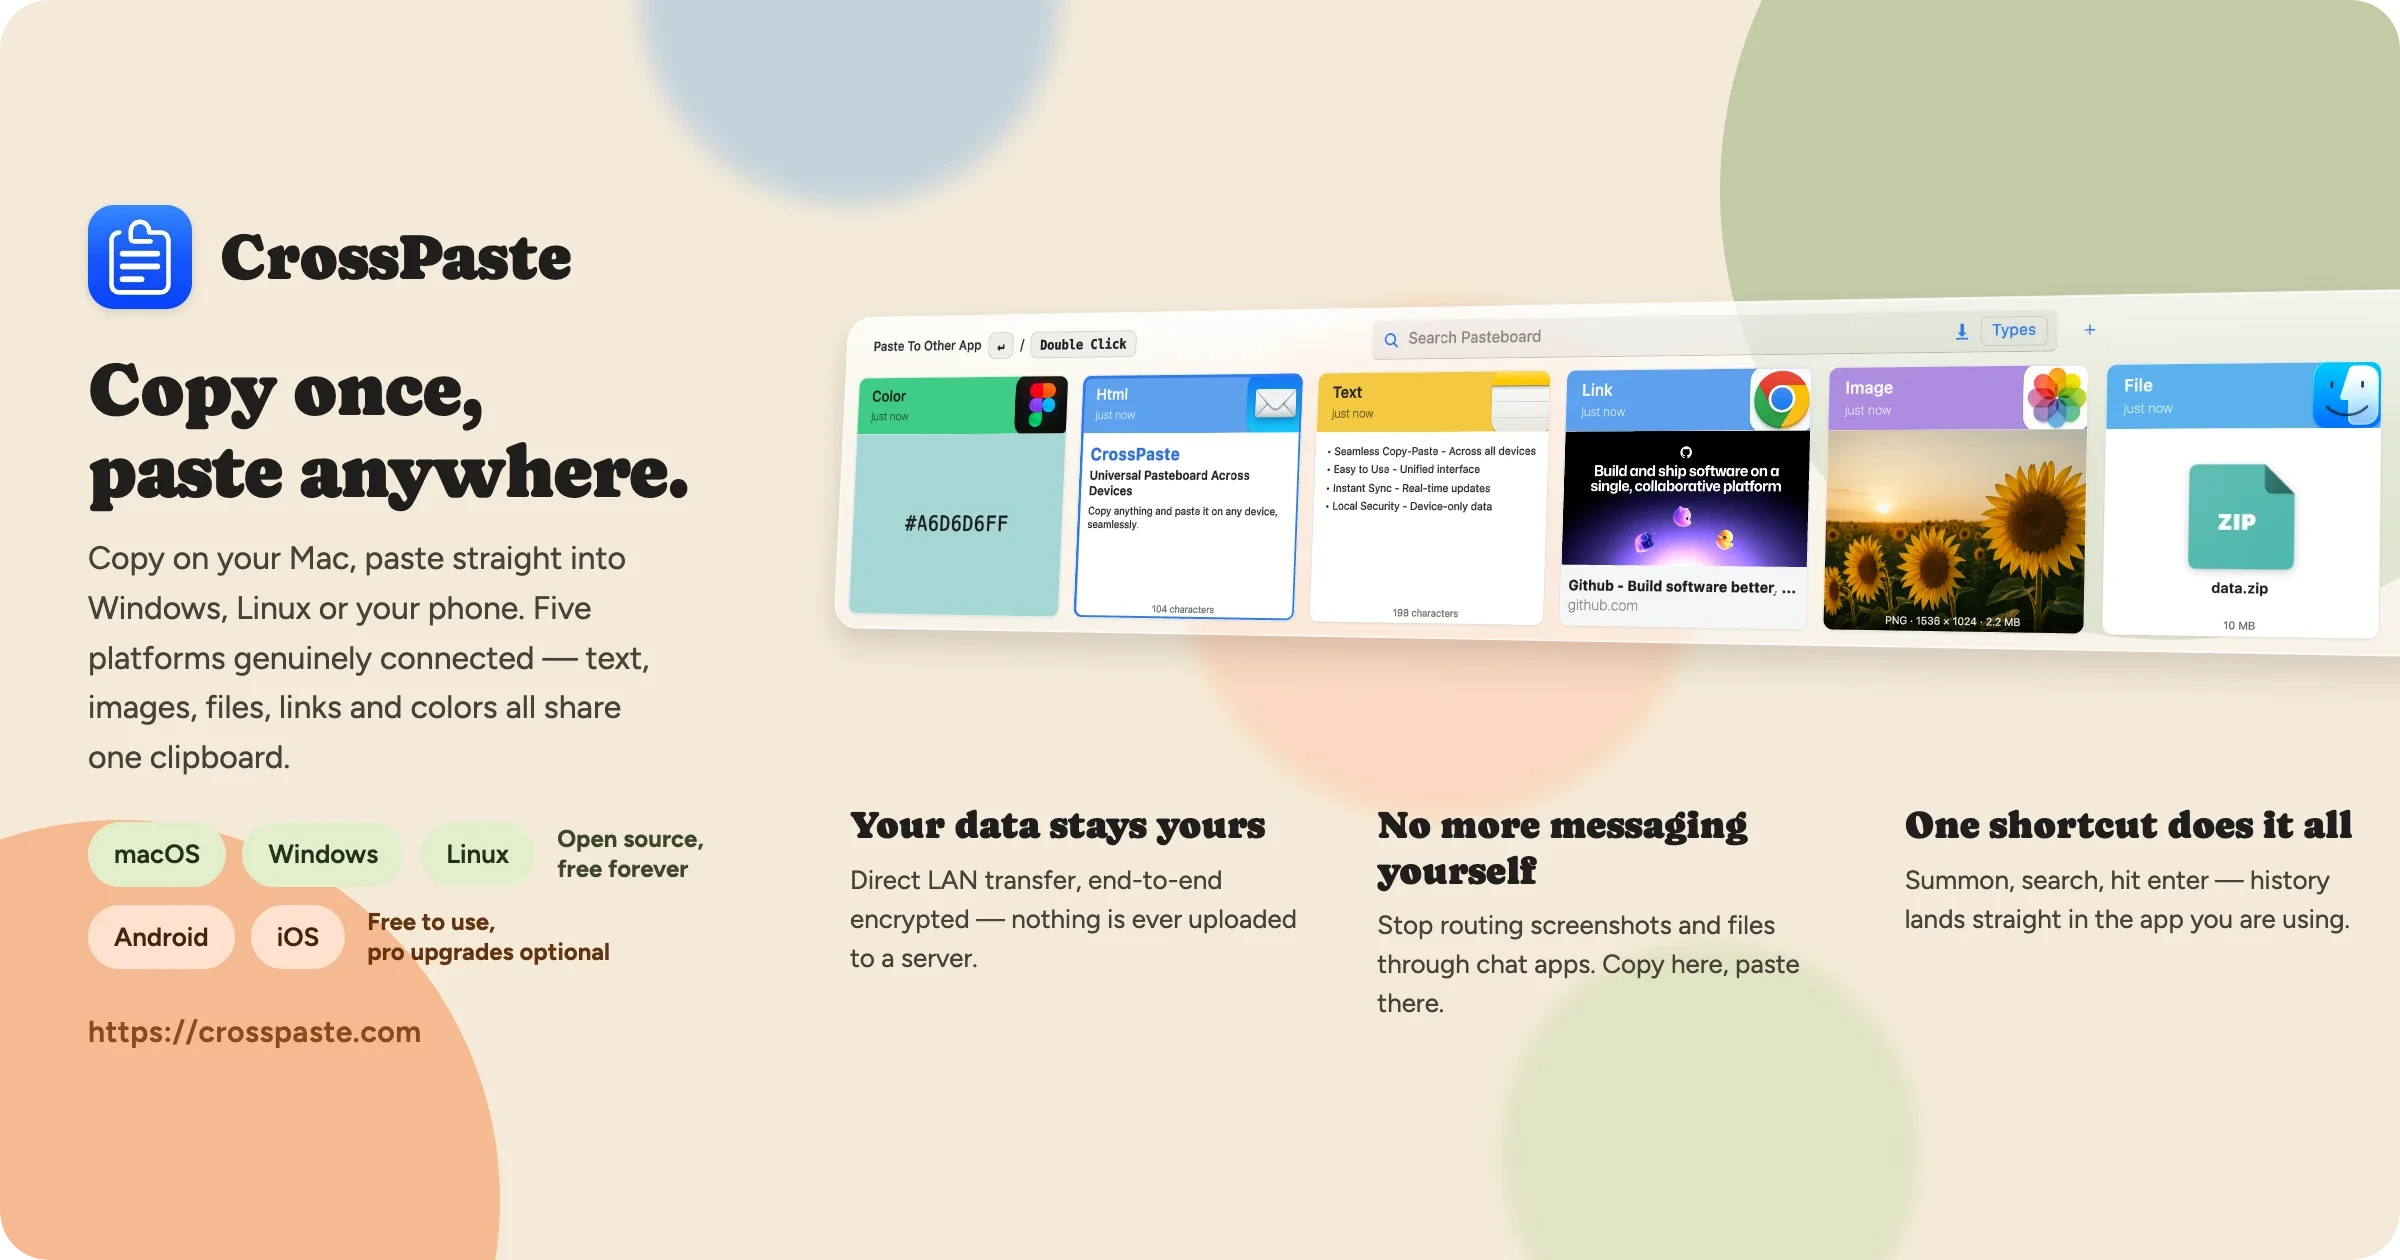
跨设备剪贴板同步工具,支持 macOS、Windows 和 Linux,数据只在局域网内端到端加密传输、不经过云端,还内置 OCR、CLI 和 MCP 服务。
轻量级文档管理系统,支持 OCR、文件共享和自托管,用 Docker 部署即可获得企业级 DMS 的完整功能。

开源的风险决策基础设施与数据编排平台,把 KYC/KYB、身份核验、欺诈检测和合规审核流程串起来,帮风控团队统一管理案件与后台运营。