关键词:语音合成
描述或关键词里包含「语音合成」的项目,共 119 个。找不到想要的?试试完整搜索。
输入一个主题或关键词,就能自动完成文案生成、素材匹配、配音字幕和视频合成,一键产出高清短视频,省去手工剪辑的麻烦。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。
只需 1 分钟语音数据就能训练出高质量 TTS 模型,支持少样本音色克隆,适合快速定制个性化语音合成。

开源 AI 语音工作室,支持声音克隆、语音听写和语音生成,基于 Qwen3-TTS 与 Whisper,可在 CUDA 或 MLX 上本地运行。
用 5 秒语音样本克隆音色,实时合成任意文本的语音,基于 PyTorch/TensorFlow 的说话人编码与声码器流水线。

无需分词器的多语言语音合成模型,支持创意音色设计和逼真声音克隆,可直接从文本生成自然语音。
开源的对话语音生成模型,能把文字转成自然流畅的日常对话语音,适合给聊天机器人和语音助手配音。
输入一段文本就能生成带笑声、叹息等非语言声音和背景音乐的语音,效果自然,适合做创意配音和音频内容原型。
5 秒克隆任意人声,实时合成任意语音,基于 PyTorch 的语音克隆与文本转语音工具。
开源的高质量语音合成模型,基于 VQGAN 和 Llama 架构,支持多语言文本转语音,效果达到 SOTA 水平。
基于 ComfyUI 的全自动短视频生成引擎,串联文生图、语音合成与视频生成,一条流水线把创意直接做成短视频。
工业级零样本语音合成系统,只需几秒参考音频就能克隆音色并跨语种合成,兼顾可控性与推理效率。
把电子书(EPUB 等)一键转成有声书,内置 50 多种 TTS 引擎,支持声音克隆和 1696 种语言,适合批量制作多语言音频书。
把视频从一种语言翻译成另一种语言,自动生成配音和字幕并嵌入视频,适合做视频本地化和跨语言内容分发。
面向语音 AI 的可扩展生成式框架,覆盖语音识别、语音合成、说话人分离与语音翻译,方便研究和开发人员训练部署语音模型。
基于新一代 Kaldi 和 onnxruntime 的离线语音工具包,一套搞定语音识别、合成、说话人分离、降噪、声源分离和 VAD,可跑在嵌入式、手机和服务器上。
基于流匹配的语音合成模型官方实现,只需一段参考音频就能克隆音色并生成流畅自然的语音,适合做零样本 TTS 和语音克隆。
面向创作者和开发者的 Gradio 语音工作台,集成多引擎 TTS、零样本声音克隆、Whisper 转写、人声分离与多语言翻译,一站式完成配音和字幕制作。

开箱即用的语音工具包,覆盖流式语音识别、语音合成、声纹识别、语音翻译和关键词唤醒,自带标点恢复与文本前端,适合快速搭建语音推理服务。
用 Python 直接调用微软 Edge 的在线语音合成服务,无需安装 Edge 浏览器或密钥,即可把文本转成自然语音。
超低延迟的语音转文字、意图识别和语音合成工具,用来搭建语音助手和语音交互界面,响应快、适合实时对话场景。

端到端语音处理工具箱,覆盖语音识别、合成、翻译、增强、分离和说话人日志等任务,基于 PyTorch 提供统一训练与推理流程。
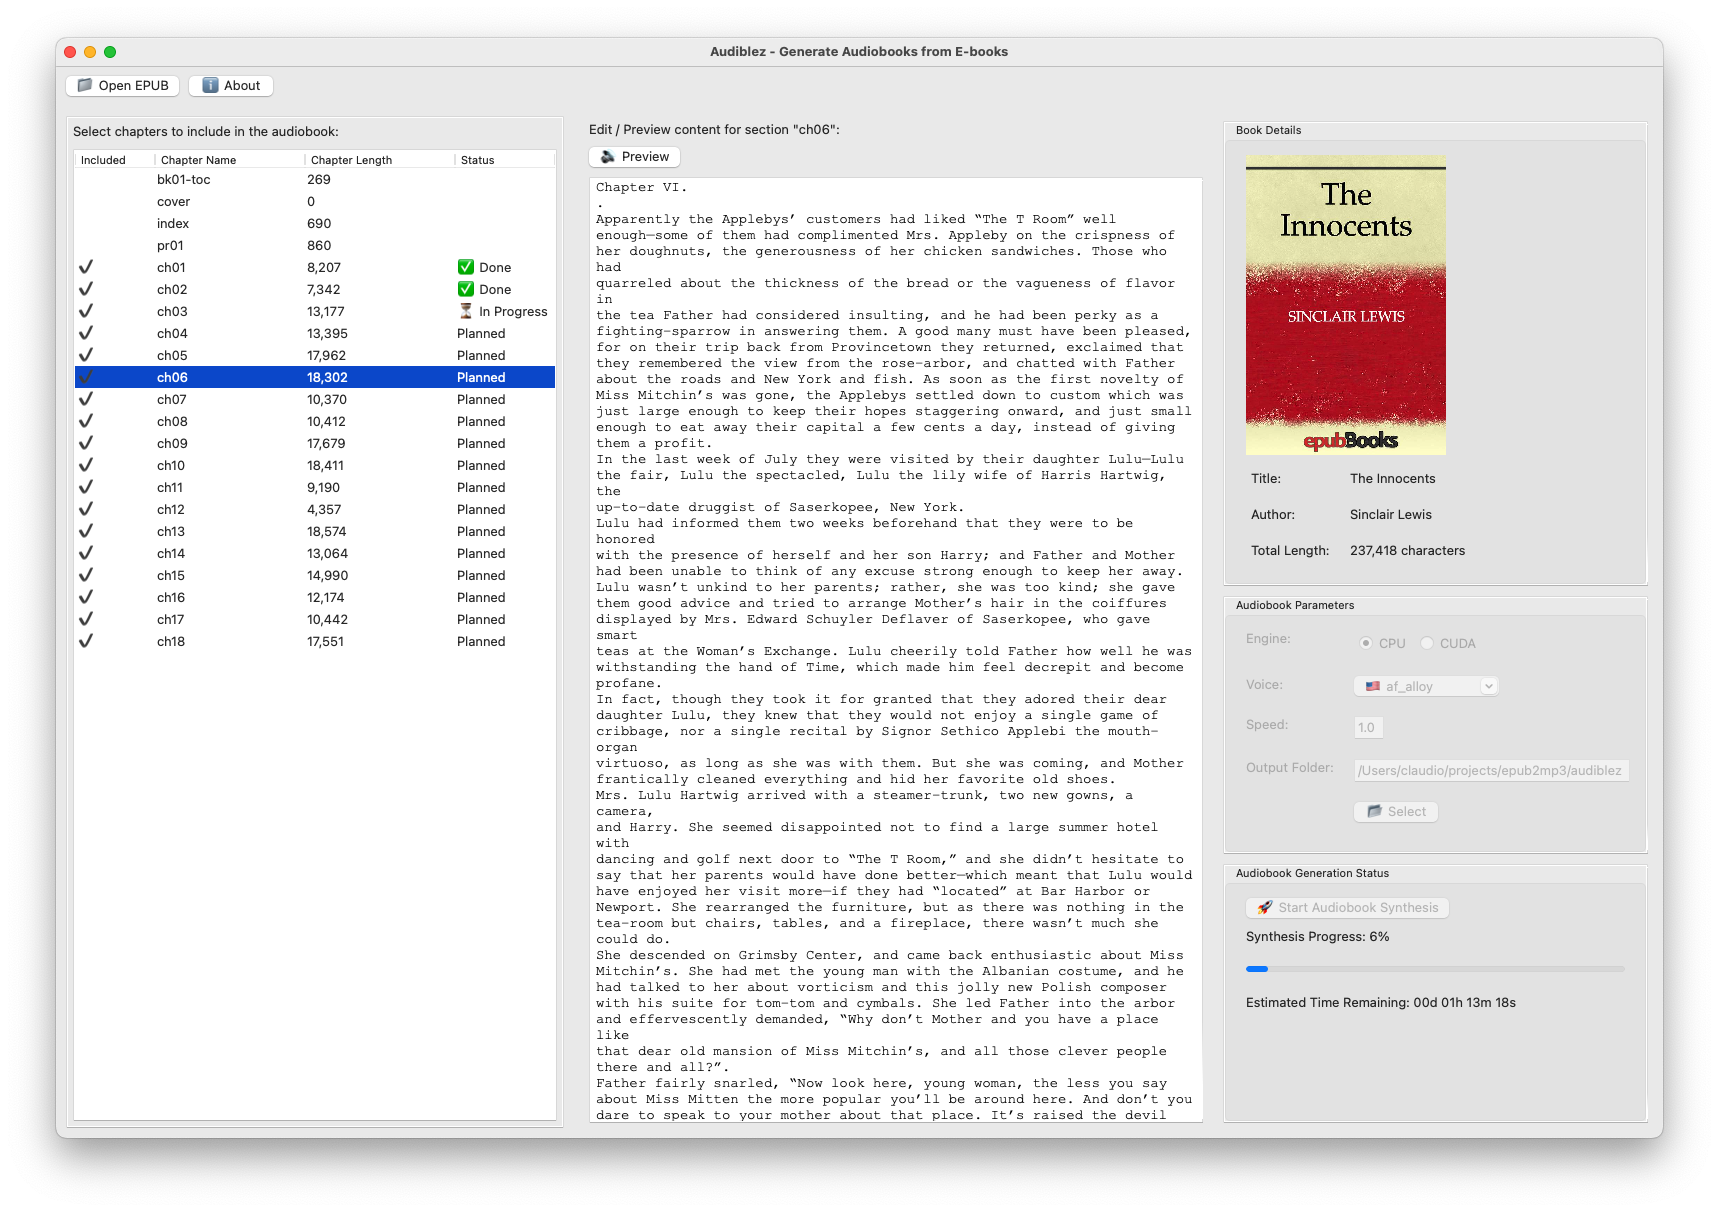
把 EPUB 电子书转成有声书的 Python 工具,基于 Kokoro 语音合成模型,适合想批量制作个人音频书的人。
基于 VITS2 骨干网络和多语言 BERT 的语音合成模型,能生成自然度较高的多语种语音,适合做 TTS 训练与推理。
多音色、支持提示词控制情感与风格的语音合成引擎,输入文本即可生成带情绪表现力的自然语音,适合做有声内容和虚拟人配音。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
支持中英日韩法西六种语言的高质量语音合成库,适合需要多语种 TTS 能力的应用直接集成。
给 ChatTTS 套了个本地网页界面,输入文字就能合成语音,还能对外提供 API 接口,省去自己写前端和接口的功夫。
面向 Apple Silicon 的端侧语音 AI 工具包,用 Swift 在 iOS 和 macOS 上本地跑语音识别、说话人分离和语音合成,不用联网也能处理音频。
基于大语言模型的语音合成系统,能生成接近真人音色的自然语音,并支持实时流式输出,适合搭建低延迟的 TTS 服务。
把 EPUB、PDF 或纯文本一键转成有声书,并生成与语音同步的字幕,适合批量制作有声内容。
预训练语音合成模型集合,支持俄语、亚美尼亚语等多种语言,几行代码就能把文本转成语音,省去自己训练模型的麻烦。
基于微软语音合成接口的桌面工具,用 Electron + Vue 构建,输入文本即可生成语音并导出音频文件。
把 Kokoro-82M 语音合成模型封装成 OpenAI 兼容 API,用 Docker 一键部署,支持多说话人、SSML 和字幕时间戳,CPU、AMD、NVIDIA 都能跑。
一个能自主感知上下文的桌面 AI 伴侣,通过实时屏幕视觉、窗口追踪和 ONNX 语音合成,配合带表情的悬浮界面与你互动。
基于浅层扩散机制的歌声合成与语音合成模型,AAAI 2022 官方实现,支持 MIDI 输入生成歌声,兼顾合成质量与推理速度。
100M 参数的多语言语音合成模型,能在 CPU 上实时推理,支持音色克隆和 48kHz 立体声输出,适合本地部署轻量 TTS。
把 OpenAI Whisper 语音识别模型反过来用做文本转语音的开源 TTS 系统,基于 PyTorch 实现,可直接在真实语音数据上训练出多说话人合成效果。
把安卓手机变成可定制的 TTS 朗读器,内置微软演示接口,支持自定义 HTTP 请求、导入本地引擎,还能按中文引号自动区分旁白和对话。
开源语音合成模型家族,支持长语音、对话合成、音色设计、音效生成和实时流式 TTS,适合搭建多语言语音生成服务。
纯 C++ 音频推理引擎,基于 ggml 实现,一套代码覆盖语音合成、识别、VAD、变声和音乐生成,不依赖 Python,适合边缘部署。
开箱即用的高质量语音转换工具,基于 PyTorch 和 RVC 实现变声与声音克隆,兼顾易用性和推理性能。
一个基于 Gradio + React 的 WebUI,把 GPT-SoVITS、CosyVoice、XTTSv2、Bark、MusicGen、RVC 等二十多种语音合成、音频生成与音乐生成模型整合到同一界面,省去逐个部署的麻烦。
用 Rust 写的高性能 AI 模型推理引擎,支持 LLM 和语音合成,并针对 Metal 做加速,适合在本地或服务端跑模型推理。
输入任意主题,自动生成带 TTS 旁白、字幕和章节进度条的黑底动态图形讲解视频,支持中英文,每帧都用 Remotion 代码绘制。
面向 AI Agent 的实时语音运行时,把语音识别和语音合成接进编码助手,让 Agent 能边说话边干活、保持在线。
面向越南语的本地语音合成工具,支持即时声音克隆,在 CPU 上实时推理并输出 48kHz 音频,适合做越南语 TTS 应用。
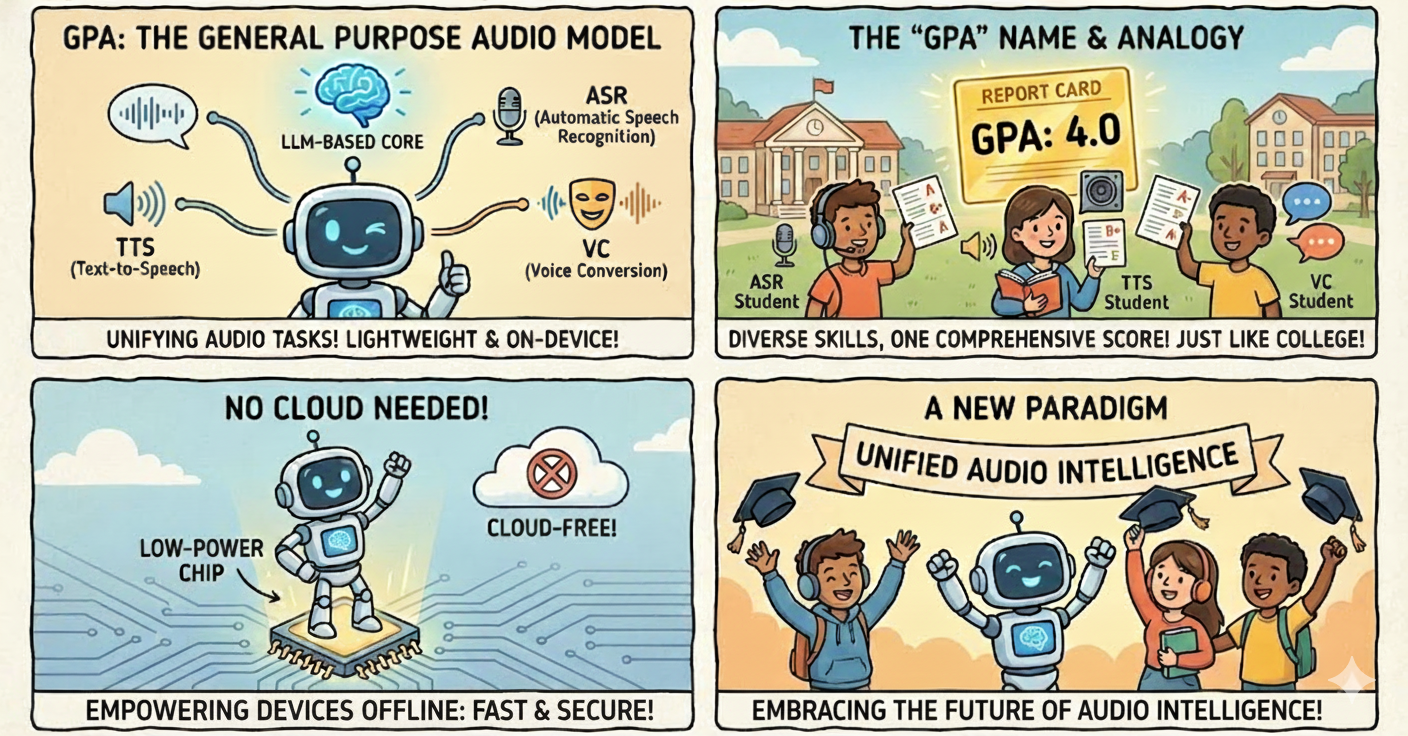
一个超小型的通用音频模型,用同一套权重同时完成语音识别、语音合成和音色转换,省去为每种任务单独部署模型。
跨平台电子书阅读器,内置本地向量库,支持语义搜索、基于 RAG 的书籍问答、笔记、TTS 朗读和 WebDAV 同步,可接入 OpenAI、Anthropic、Ollama 等模型。
基于 Kokoro 模型和 ONNX Runtime 的轻量级语音合成方案,用 Python 就能在本地跑出高质量 TTS,省去复杂环境配置。
Python 库和命令行工具,调用 Google 翻译的文本转语音接口,把文字快速合成语音并保存为音频文件。
跨平台 AI 语言练习应用,基于 Electron 构建,接入 OpenAI 与 Azure 的对话和语音合成能力,让用户通过对话和朗读练习外语。

在 ComfyUI 里搭建 LLM Agent 的框架,接入 MCP、GraphRAG、语音合成与 OCR 节点,兼容 OpenAI 接口的各类模型和本地 GGUF 模型。
开源文本转语音工具,能把超长文本拆成多角色配音,适合做有声书和长内容朗读。
把新闻自动做成 YouTube Shorts 的流水线:生成脚本、AI 画面、配音、字幕并上传,省去手工剪辑。
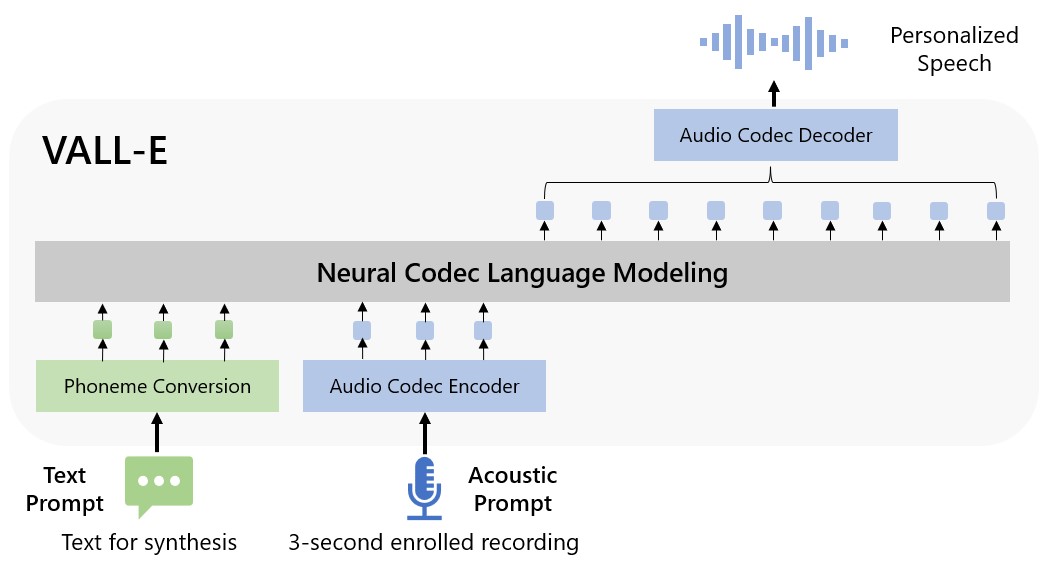
用 PyTorch 复现 VALL-E 零样本语音合成,只需几秒参考音频就能克隆音色朗读任意文本。
基于 PyTorch 的多语言语音合成工具包,支持 7000 多种语言的可控快速 TTS,可训练和微调自己的语音模型。
本地离线的 AI 音频与音乐工作站,支持语音合成、声音克隆、带歌词歌曲和多轨乐谱生成,无需联网和 API 费用。
用微软 Edge 的在线语音合成能力,自建一个免费、高质量的 TTS 接口,直接替换 OpenAI、Azure 或 ElevenLabs 的付费语音服务。
在本地设备上跑实时多模态 AI 的 Python 项目,整合语音识别、语音合成和本地大模型,实现类似 GPT-Live 的实时对话体验,支持 Apple Silicon 和 MLX。
共 119 个,这里展示前 60 个。