标签:Apple Silicon
硬件标签,共 69 个项目。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。

开源 AI 语音工作室,支持声音克隆、语音听写和语音生成,基于 Qwen3-TTS 与 Whisper,可在 CUDA 或 MLX 上本地运行。

一条命令就能从数百个模型和供应商里筛出适合你硬件配置的本地大模型,省去逐个试跑和查显存的麻烦。

面向 Apple silicon 的数组计算框架,让机器学习模型能直接在 Mac 芯片上高效训练和推理,省去折腾 CUDA 的麻烦。
一行代码就能把 GPT 换成任意开源大模型,统一推理 API 支持云端、本地和笔记本部署,覆盖语言、语音和多模态模型。

用一套可读的 Einstein 记号统一 PyTorch、JAX、TensorFlow 等框架的张量操作,让 reshape、转置、rearrange 这类代码更清晰、更不容易出错。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
用 Swift 写的原生 macOS AI 智能体运行环境,可接入任意模型,支持持久记忆、自主执行和加密身份,全程离线运行。
在 Apple Silicon 上快速创建和管理 macOS/Linux 虚拟机,专为 CI 流水线和自动化任务设计,省去手动配置虚拟机的麻烦。
在 Apple Silicon 上通过 MLX 框架运行大语言模型,支持加载、推理和微调,让 Mac 本地跑 LLM 更省心。
在任意 M 系列 MacBook 上仅用约 2GB 内存跑 Gemma 4 26B-A4B 大模型推理,靠 Metal GPGPU 把 MoE 模型塞进本地设备。
在 Mac 上基于 Apple Silicon 用 MLX 跑视觉语言模型的推理与微调工具包,支持 LLaVA、Pixtral、Florence2 等多种 VLM,本地即可完成多模态任务。
面向 AI 研究者的开源实验环境,可在本地硬件到 GPU 集群之间无缝训练、评估和扩展大模型与扩散模型。
纯 C++ 音频推理引擎,基于 ggml 实现,一套代码覆盖语音合成、识别、VAD、变声和音乐生成,不依赖 Python,适合边缘部署。
面向 Apple Silicon 的本地 LLM 推理服务器,兼容 OpenAI 与 Anthropic 接口,主打编码智能体的可靠工具调用,同权重下比 mlx-lm 快至多 4 倍。
在 Mac 上跑 Qwen 3.8 等大模型的原生推理引擎,靠 MTP 投机解码把速度拉到 125 tok/s,16GB 内存也能跑 27B 模型,并提供 OpenAI/Anthropic 兼容的本地服务。
在 Apple Silicon 上用 MLX 原生跑 FLUX、Qwen-Image 等前沿图像与视频生成模型,省去 PyTorch 依赖,让 Mac 本地出图更顺畅。
在终端里实时查看 Apple Silicon Mac 的 CPU、GPU、内存和功耗,界面类似 top,适合跑本地模型时盯资源占用。
面向 Apple Silicon 的本地大模型推理引擎,围绕模型本身做优化,让 Mac 上跑编码智能体和 LLM 推理更快更省资源。
在本地设备上跑实时多模态 AI 的 Python 项目,整合语音识别、语音合成和本地大模型,实现类似 GPT-Live 的实时对话体验,支持 Apple Silicon 和 MLX。
面向 Apple Silicon Mac 的实时系统监控工具,无需 sudo 即可查看 CPU、GPU 等硬件指标,提供 TUI 界面、JSON/Prometheus 指标服务和 Rust 库。
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
本地运行的 AI 聊天应用与推理引擎,基于 llama.cpp 加载 GGUF 开源权重模型,完全离线、保护隐私,支持 Apple Silicon 桌面端。
macOS 上的本地语音转文字工具,基于端侧 AI 实现听写与转录,数据不出本机,也可按需接入云端。
把 PyTorch 模型转成 iOS/macOS 可直接用的 .mlpackage,每个模型都配转换脚本和 SwiftUI 示例,省去自己折腾 Core ML 的麻烦。
在终端里实时查看 Apple Silicon Mac 的 CPU、GPU、内存和功耗占用,类似 top 但针对 M 系列芯片优化,适合跑本地模型时盯资源。
一套 0.8B 到 27B 的开源决策模型,一次前向就能为每个选项给出校准概率,只在不确定时才输出简短思考;配套 vLLM、llama.cpp 和 MLX 推理引擎。
在 Apple Silicon 上跑大模型的高性能推理服务,兼容 OpenAI 和 Anthropic 接口,支持 MLX 原生加速、连续批处理、多模态和 MCP 工具调用。
macOS 上的本地会议转录与语音听写工具,支持 Apple Silicon 端侧推理,隐私优先,可替代 Granola 和 WisprFlow。
在 Apple Silicon Mac 上原生微调大模型的工具,基于 MLX 支持 SFT、DPO、GRPO 以及视觉、语音、OCR 等多模态训练,API 兼容 Unsloth。
面向 Apple Silicon 的本地语音工具箱,用 MLX 和 CoreML 在 iOS/macOS 上跑语音识别、语音合成、语音转换、VAD 和说话人分离,全程端侧推理。
用 USB-C 把 iPhone 接到 Mac 上,让手机参与跑 27B 大模型,加快提示词读取并扩展上下文,适合本地推理场景。
把图片或提示词一键变成带贴图、骨骼和动画的游戏角色,本地跑在 Apple Silicon 或 NVIDIA 上,适合独立游戏开发者和 3D 美术。
红果短剧的桌面客户端,支持 M 系列和 Intel Mac 以及 Windows,能跨三个来源搜索、播放、下载短剧并追剧。
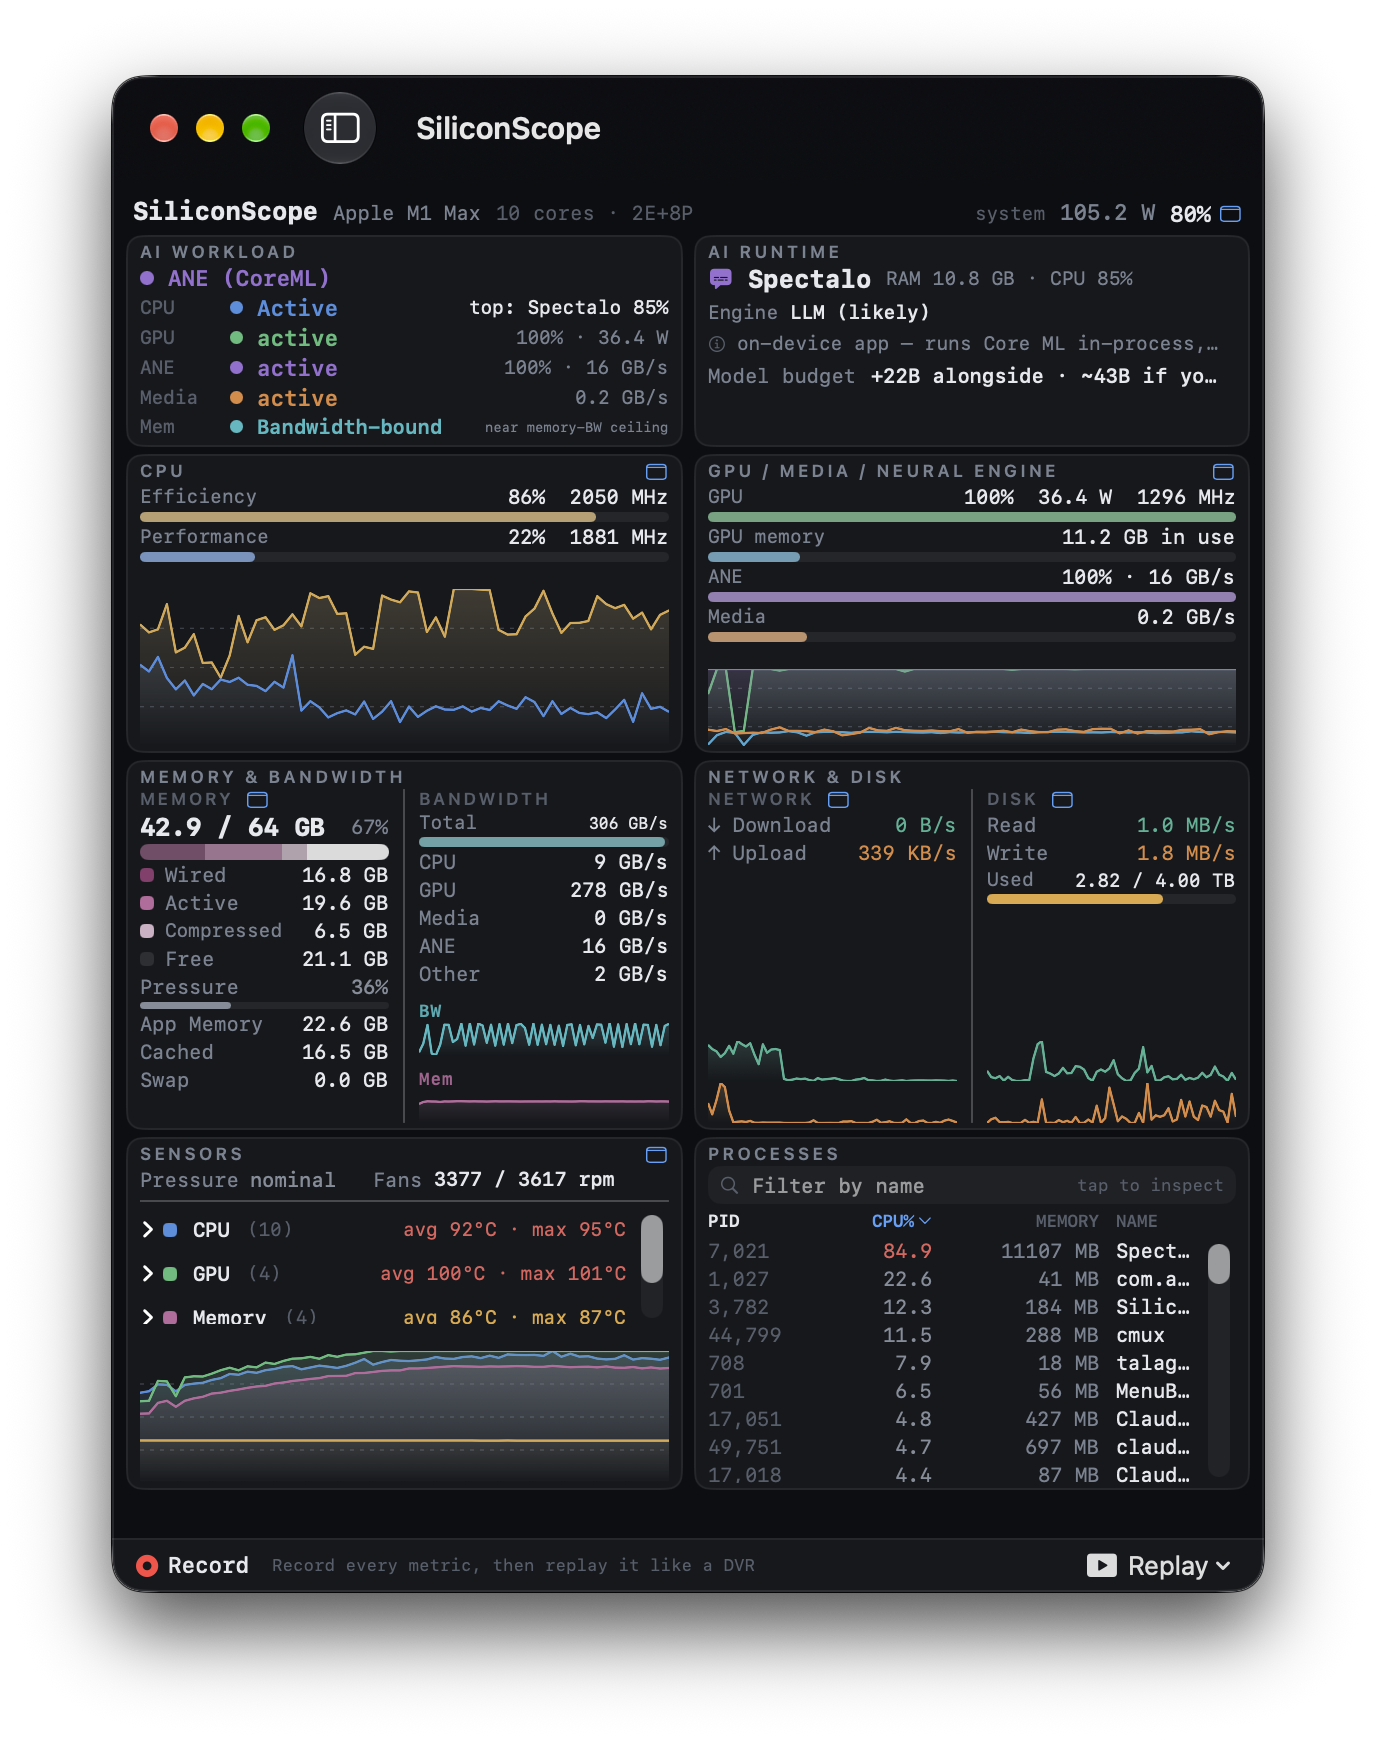
面向 Apple Silicon 的原生 SwiftUI 系统监控工具,无需 sudo 即可实时查看 ANE、媒体引擎和内存带宽占用,方便排查本地大模型推理时的硬件瓶颈。
macOS 菜单栏性能诊断工具,实时记录 CPU、内存、GPU、网络和电池数据,帮你定位卡顿和性能问题,无遥测、免费开源。
Spark-X2.6 是面向端侧设备的开源模型系列,主打把智能体能力压进本地运行的模型里,支持 llama.cpp、MLX 等推理后端。
面向流式和端侧场景优化的 Whisper 语音识别模型,支持 Apple Silicon、CoreML、MLX 和 NVIDIA GPU,可做实时转写与翻译。
面向 Mac 和 NVIDIA DGX Spark 的 AI 电影制作工作室,按剧组流程规划分镜,并用 Qwen-Image、FLUX、MiniMax 等模型生成带声音的画面与视频。

完全本地运行的私密语音转文字应用,支持多种模型后端、说话人分离和日历模式,覆盖 Windows、macOS 和 Linux。
在 Apple Silicon 上通过 MLX 原生实现 DeepSeek DSpark 与 DFlash 投机解码,让本地大模型推理最高提速 4 倍且无损,兼容 Gemma、Qwen、Nemotron 等模型。
在 16–64 GB 内存的 Apple Silicon Mac 上,从 SSD 流式加载 105 GB 的 4-bit 大模型跑推理,纯 Swift + MLX/Metal 实现,离线无需 Python。
基于节点的创意编程工具,用可视化连线搭建 3D 图形、图像处理和计算机视觉流程,灵感来自 Quartz Composer,适合实时渲染与多媒体实验。

自托管的 AI Agent 操作系统,把记忆、聊天、Agent 和文件都留在自己的硬件上,默认离线运行,还能把树莓派、Mac mini、游戏 PC 自动组集群。
把模型打包成 OCI 镜像来分发和运行,让任意 agent 都能跑在任意模型上,省去环境配置和模型管理的麻烦。
在 Apple 芯片 Mac 上本地运行的电脑操作代理,通过 macOS 无障碍 API 驱动,用 laya 做端侧决策、CUA-S1-FORMS 填表,无需云端。
一款原生 macOS 系统工具箱,提供真实有效的内存优化、深度清理找出真正占空间的大文件、风扇控制、防休眠和磁盘分析,适合想精细管理 Mac 系统资源的用户。
面向 macOS 的轻量级 Markdown 编辑器,原生 Objective-C 编写并适配 Apple Silicon,用来写和预览 Markdown 文档。
用 C++ 复刻 vLLM 的推理引擎,支持连续批处理、分页 KV 缓存,并额外提供 GGUF 加载、RadixAttention 和缓存感知调度,适合想在 C++ 环境跑大模型推理的场景。
在 Apple Silicon Mac 上本地跑 LTX-2 系列和 MiniMax H3 模型的视频生成应用,支持文生视频和图生视频,不用云端 GPU。
自托管的 DeepSeek-OCR-2 网页界面与 API,支持在 NVIDIA、Apple Silicon 和 CPU 上通过 vLLM 或 transformers 运行,提供逐页质量检查、PDF 流式处理和 MCP 接入。
面向 Apple Silicon Mac 的轻量系统监控工具,用一块可任意缩放的悬浮玻璃面板实时显示 CPU、GPU 等运行状态,替代 btop、htop 这类终端监控。
在 Apple Silicon Mac 上离线跑 LTX-2.5 和 MiniMax H3,做带声音的文本/图片转视频、对口型和角色 LoRA 训练,不用云端和 API key。
在 Apple Silicon 上做 W8A8/W4A8 量化推理,调用 M5 闲置的 INT8 TensorOps 让 LLM prefill 快 1.2–1.9 倍,并用类 FlashInfer 的 GQA 解码注意力加速 SDPA。
把 Mac 上运行的 Apple Foundation Models、MLX 模型等本地 AI 能力聚合成一个兼容 OpenAI 的 API 端点,支持服务模式和单次命令推理,还能通过管道调用。
轻量级 LLM 基础设施代理和负载均衡器,能在本地与远程推理后端之间做智能路由、自动故障转移和统一模型发现。
开源语音识别模型 Phonon-2 和 Phonon-1,提供命令行工具以及 CPU、CUDA 镜像,支持低比特量化和 MLX 加速,方便本地部署语音转文字。
macOS 菜单栏上的极简性能监测小工具,实时显示 CPU、GPU、内存和电池状态,适合想随时掌握机器负载又不想开活动监视器的用户。
面向 Apple Silicon 的本地大模型推理与微调框架,用 Rust 实现,支持 LoRA/QLoRA 微调、量化、模型服务和 MLX/Metal 加速。
一行代码把任意模型部署成兼容 OpenAI/Anthropic/Ollama 的 API,自带聊天界面和原生 MCP 支持,省去自建推理服务的胶水代码。
共 69 个,这里展示前 60 个。