评估 · 实验 · MLOps
262 个仓库验证模型到底行不行,并把实验、部署与线上表现管起来。
用 Python 对多目标跟踪器做基准评测,计算 CLEAR MOT 等标准指标,方便横向对比不同跟踪算法的效果。
Ruby 的类型安全数据校验库,用声明式 schema 和规则定义校验逻辑,支持类型强制转换,适合在数据入库前做结构化校验。
一个可直接用于生产的 MLOps Python 包模板,集成 MLflow、scikit-learn、Pydantic、Pandera 和 uv,帮你快速搭起带实验追踪与数据校验的机器学习工程骨架。
给 LLM 应用接入 OpenTelemetry 埋点,统一采集 OpenAI、LangChain、LlamaIndex 等框架的调用链路,方便做可观测和排障。
从任意文本自动抽取实体与关系并生成知识图谱的 Python 工具,附带基准测试,方便用 LLM 构建和评测图谱抽取流程。
Keep an eye on system resources
用逼真的合成对话模拟来诊断和优化 LLM Agent 的框架,帮助开发者在真实上线前发现并修复 Agent 的薄弱环节。
把 AI/ML 模型打包成可直接上线的推理服务,省去手写 Docker 和部署脚本的麻烦,一条命令就能跑起来。
自动扫描图像数据集,找出重复、模糊、曝光异常等质量问题,帮你在训练前把数据清洗干净。
向量数据库性能与性价比基准测试工具,支持多种向量库的统一压测和结果对比,方便选型时横向评估。

桌面版 MCP 客户端,把各家 LLM API 和 MCP 工具统一编排到一个界面里,方便快速试用和评估不同模型。
把电子表格变成 AI 流水线:在单元格里串联提示词和模型,实时对比 LLM 输出,多人协作迭代 AI 应用。
在内存中对 brotli、lz4、zstd、zlib 等开源压缩器做统一跑分对比,方便按速度和压缩比挑选合适的压缩算法。

Linux 系统和进程监控工具,能记录并回放 CPU、内存、磁盘、网络等资源使用情况,方便事后排查性能瓶颈。

面向智能体和 LLM 应用的编排框架,把 RAG、工具调用和多步推理流程串起来,方便搭建和运维生成式 AI 应用。
R 语言的数据质量校验工具,用简洁的断言语法检查数据框和数据库表,自动生成元数据报告,帮你在分析前发现脏数据。
一门讲高效深度学习系统的课程材料,覆盖 CUDA 编程、分布式训练和推理优化,帮你搞懂怎么把模型训得更快、跑得更省。

自包含的本地 AI 服务,开发者可将其嵌入并随应用分发,为软件快速添加目标检测、生成式 AI 等能力,无需自建模型部署流程。
一套从 Python 基础到生成式 AI 的数据科学实战教程,覆盖数据分析、深度学习、MLflow 与 Prefect 等 MLOps 工具链,适合系统学习并动手实践。
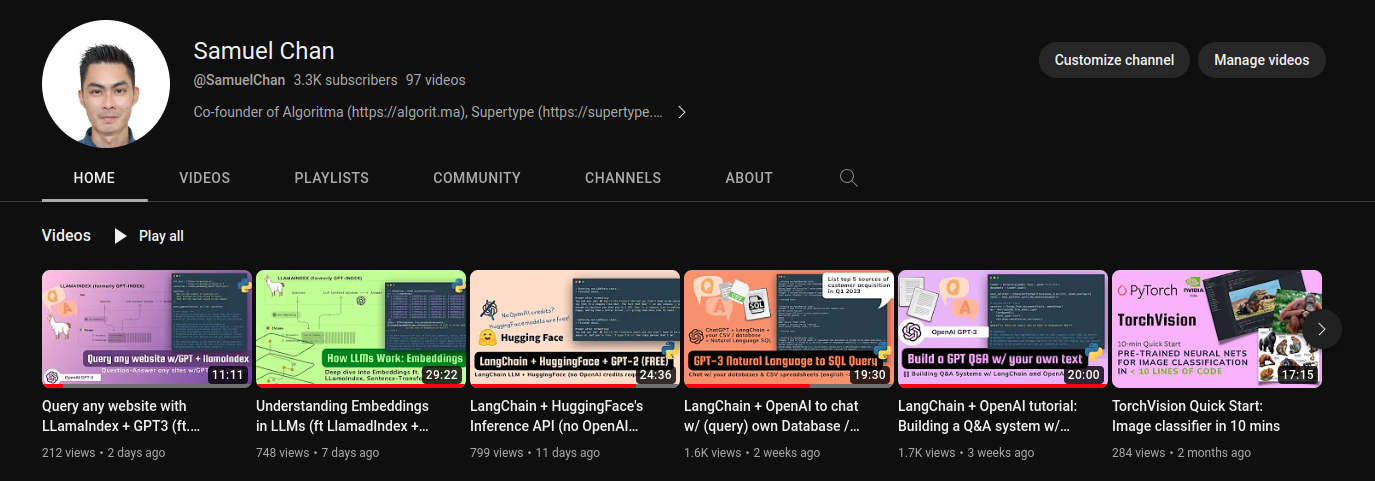
一套基于 Jupyter Notebook 的大模型实战教程和示例脚本,覆盖 LangChain、OpenAI、LlamaIndex、ChromaDB、Pinecone 等主流工具,帮你快速上手 LLM 应用开发。
持续基准测试平台,在 CI 中自动追踪代码性能变化,防止性能回归,适合关注代码质量的团队。
给 LLM 应用提供记忆与信息检索能力的服务端,用 Rust 实现,帮你在对话中持久化上下文并做检索,省去自己搭记忆层。
面向多模态机器学习的数据平台,支持图像标注、数据筛选与清洗,帮助团队管理训练数据并提升数据质量。
OpenCUA 提供构建电脑操作智能体(CUA)的开放基础,包含数据集、基础模型和评测基准,让 GUI 自动化智能体有可复现的训练与评估方案。