模型工具链
232 个仓库模型的转换、量化、编译与硬件适配。
把微软 ONNX Runtime 封装成 Go 库,让 Go 程序能直接加载和推理 ONNX 模型,省去跨语言调用的麻烦。
用 C++ 把 YOLOv8 模型部署到 TensorRT 上做高性能推理,适合需要低延迟目标检测的工程落地场景。
基于 YOLO12 的 AI 瞄准辅助,支持所有 FPS/TPS 游戏,通过 TensorRT、CUDA 或 DirectML 在 GPU 上推理,并配合 Arduino、KMBox 等硬件实现鼠标控制。
Hailo 官方预训练模型库,提供面向 Hailo-8 边缘 AI 加速器的模型、量化工具和完整评估环境,方便直接部署到端侧设备。
纯 C++ 实时单目多人 3D 全身重建,输出带手部 70 关节骨架的 BVH 动作捕捉数据,ONNX + ggml 推理无需 Python。
基于 MLIR 的开源编译器工具链,提供贴近硬件的 Python API,用来给 AMD Ryzen AI NPU(AI Engine)编写和编译算子程序。
Xilinx 官方运行时库,让 AIE 和 FPGA 加速卡在 Linux 上跑起来,提供驱动、用户态 API 和编译工具链,方便把 AI 负载卸载到 Versal、Ryzen AI 等硬件。
把 XGBoost、LightGBM、scikit-learn、CatBoost 和 ONNX 模型一键编译成原生 C99 推理代码,省去 Python 运行时开销,推理速度最高提升 336 倍。
纯 C 写的本地大模型推理引擎,靠 MoE 稀疏激活和 NVMe 流式加载,让 32GB 笔记本跑 80B 模型,速度全面超过 llama.cpp。
用纯 Go 直接调用 llama.cpp 做本地推理,支持 CUDA、Metal、ROCm 硬件加速,覆盖 Linux、macOS、Windows 和 WebAssembly,方便在 Go 应用里嵌入大模型。
离线文档全文检索工具,支持按正文而非文件名搜索 HWP、PDF、Office 等韩文文档,覆盖 Windows 和 macOS。
面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
把 Depth Anything V3 单目深度估计模型封装成 ROS2 节点,用 TensorRT 加速推理,从相机图像直接输出米制深度图和点云。
SINQ 是一种即插即用的 LLM 量化方法,能把任意大模型压小并尽量保住精度,适合显存吃紧时部署 DeepSeek、Qwen 等模型。
把 scikit-learn 训练好的模型和 Pipeline 转成 ONNX 格式,方便跨框架部署和推理加速。
基于节点的创意编程工具,用可视化连线搭建 3D 图形、图像处理和计算机视觉流程,灵感来自 Quartz Composer,适合实时渲染与多媒体实验。
面向单片机和微型计算机的轻量级深度学习库与推理框架,自带编译器,不绑定芯片厂商,可在 ESP32、Arduino 等边缘设备上跑模型。
把 Qwen3-VL、Florence-2、InternVL 等视觉语言模型接进 ComfyUI 的节点包,顺带支持开放词表检测、SAM 分割、视频时序推理和 GGUF 量化加载。
基于 TensorFlow Keras 的量化深度学习库,支持量化感知训练,方便把模型部署到 FPGA、ASIC 等硬件加速器上。
把 ONNX 模型转成 Keras 或 TFLite 的转换工具,方便将 PyTorch 训练好的模型部署到移动端和嵌入式设备,还支持量化。

一个 MCP 服务器,能统计各 AI 编程代理节省了多少 token、优化上下文,并在 16 种 CLI 客户端间共享本地实时知识图谱。
基于节点编辑器的图像处理应用,用拖拽连线的方式搭建和对比不同处理流程,适合做算法验证和效果比较。
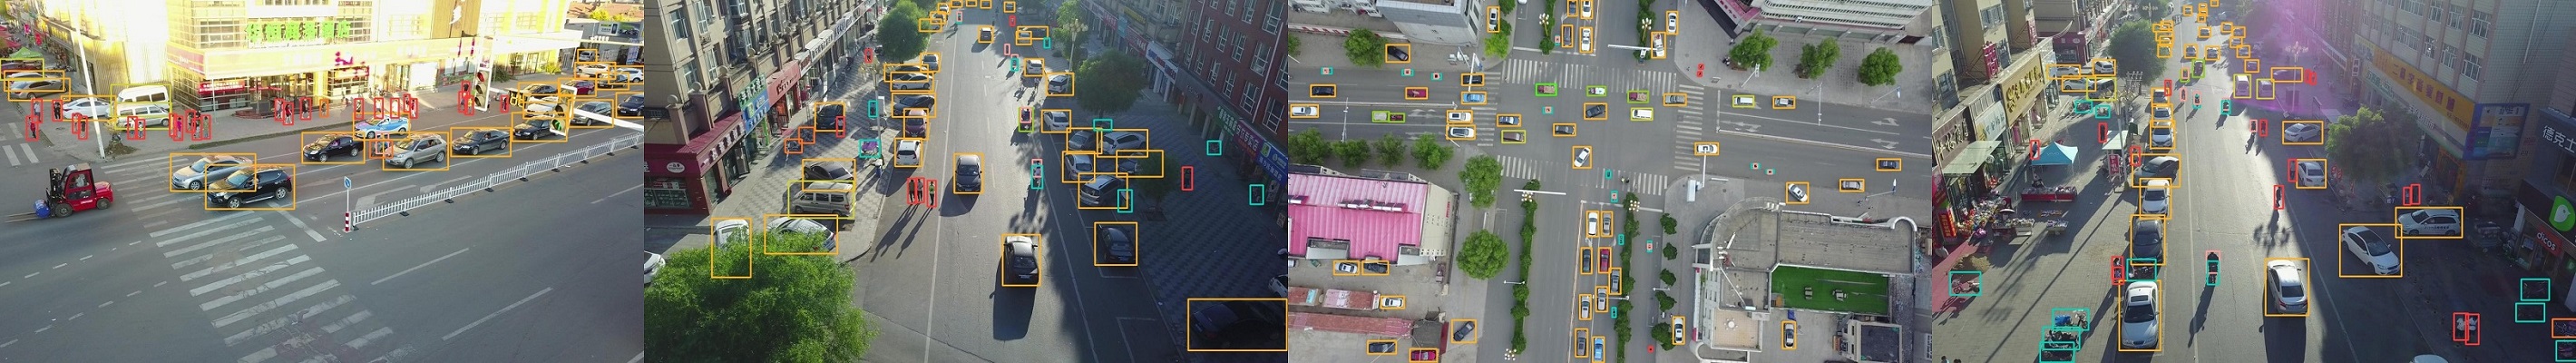
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。