多模态生成
434 个仓库图像、视频、语音与视觉语言模型。
基于 Gradio 的 Stable Diffusion 网页界面,把文生图、图生图、局部重绘等能力做成可视化操作面板,不用写代码就能跑图像生成。
基于节点图的扩散模型图形界面与后端,支持本地快速推理和 API 调用,方便搭建和调试图像生成工作流。
OpenAI 开源的通用语音识别模型,基于大规模弱监督训练,支持多语言转写、翻译和语种识别,开箱即用。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。

把 Claude、Cursor 等 AI 编程助手变成完整视频制作工作室,内置 12 条制作流水线和 100+ 工具,覆盖脚本、配音、图像生成到剪辑全流程。

把 Claude、Cursor 等 AI 编程助手变成完整的视频制作工作室,内置 12 条制作流水线和 100+ 工具,覆盖从生成到剪辑的全流程。
只需 1 分钟语音数据就能训练出高质量 TTS 模型,支持少样本音色克隆,适合快速定制个性化语音合成。
用 5 秒语音样本克隆音色,实时合成任意文本的语音,基于 PyTorch/TensorFlow 的说话人编码与声码器流水线。

无需分词器的多语言语音合成模型,支持创意音色设计和逼真声音克隆,可直接从文本生成自然语音。
输入一段文本就能生成带笑声、叹息等非语言声音和背景音乐的语音,效果自然,适合做创意配音和音频内容原型。
可自托管的个人 AI 第二大脑,能从网页和本地文档中检索答案,支持自定义智能体、定时自动化和深度研究,兼容多种在线或本地大模型。
5 秒克隆任意人声,实时合成任意语音,基于 PyTorch 的语音克隆与文本转语音工具。
基于 PyTorch 的扩散模型工具箱,统一加载和训练 Stable Diffusion、FLUX 等模型,做图像、视频、音频生成。
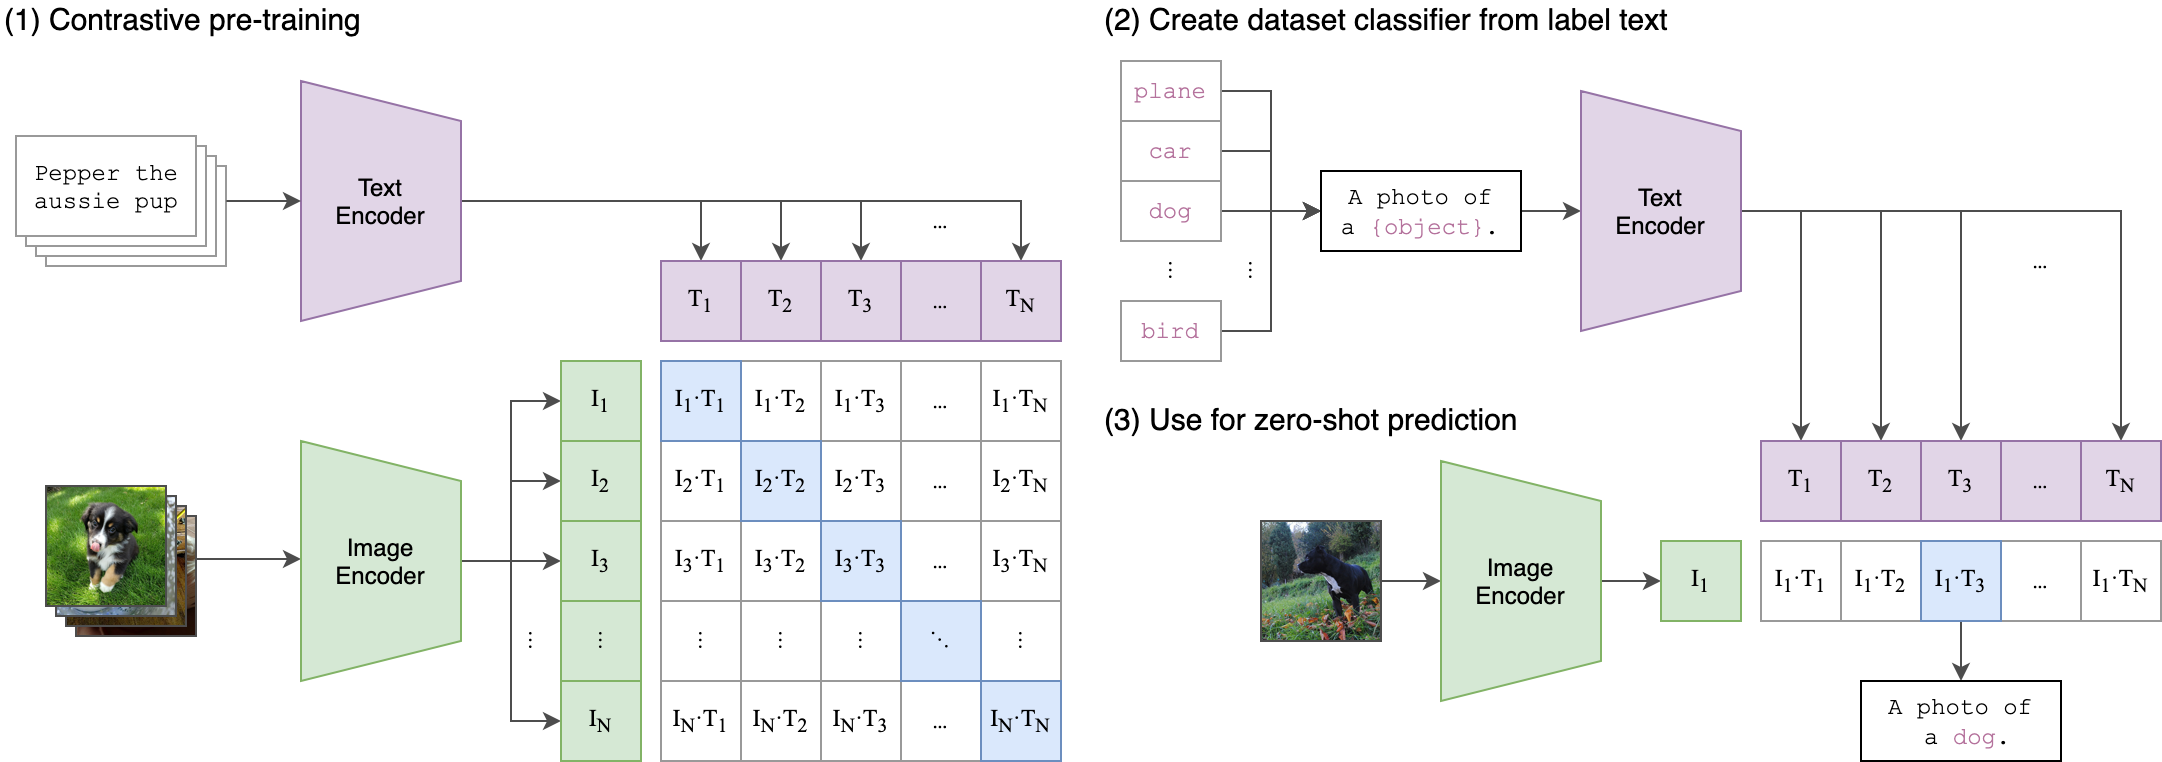
用对比学习把图像和文本映射到同一嵌入空间,实现零样本图像分类和图文匹配,是跨模态检索与多模态模型的经典底座。
自托管的多模型 AI 图像与视频生成工作台,聚合 Flux、Midjourney、Kling、Sora 等 600+ 模型,无内容过滤,可替代闭源视频平台。
开源的高质量语音合成模型,基于 VQGAN 和 Llama 架构,支持多语言文本转语音,效果达到 SOTA 水平。
基于 ComfyUI 的全自动短视频生成引擎,串联文生图、语音合成与视频生成,一条流水线把创意直接做成短视频。
开源视频生成模型,用高效架构和训练方案降低高质量视频制作门槛,让普通开发者也能训练和部署文生视频模型。
用 TypeScript 快速搭建 AI 应用和智能体的现代框架,内置工作流、对话机器人和评测能力,省去自己拼装 LLM 调用链的麻烦。
面向 Stable Diffusion 的专业图像生成引擎,提供行业领先的 WebUI,支持文生图、图生图、局部重绘和扩图,适合创作者与商业产品集成。

MiniCPM-V 是面壁智能开源的多模态视觉语言模型,能在手机、PC 等本地设备上完成看图、听音和对话交互,无需依赖云端。
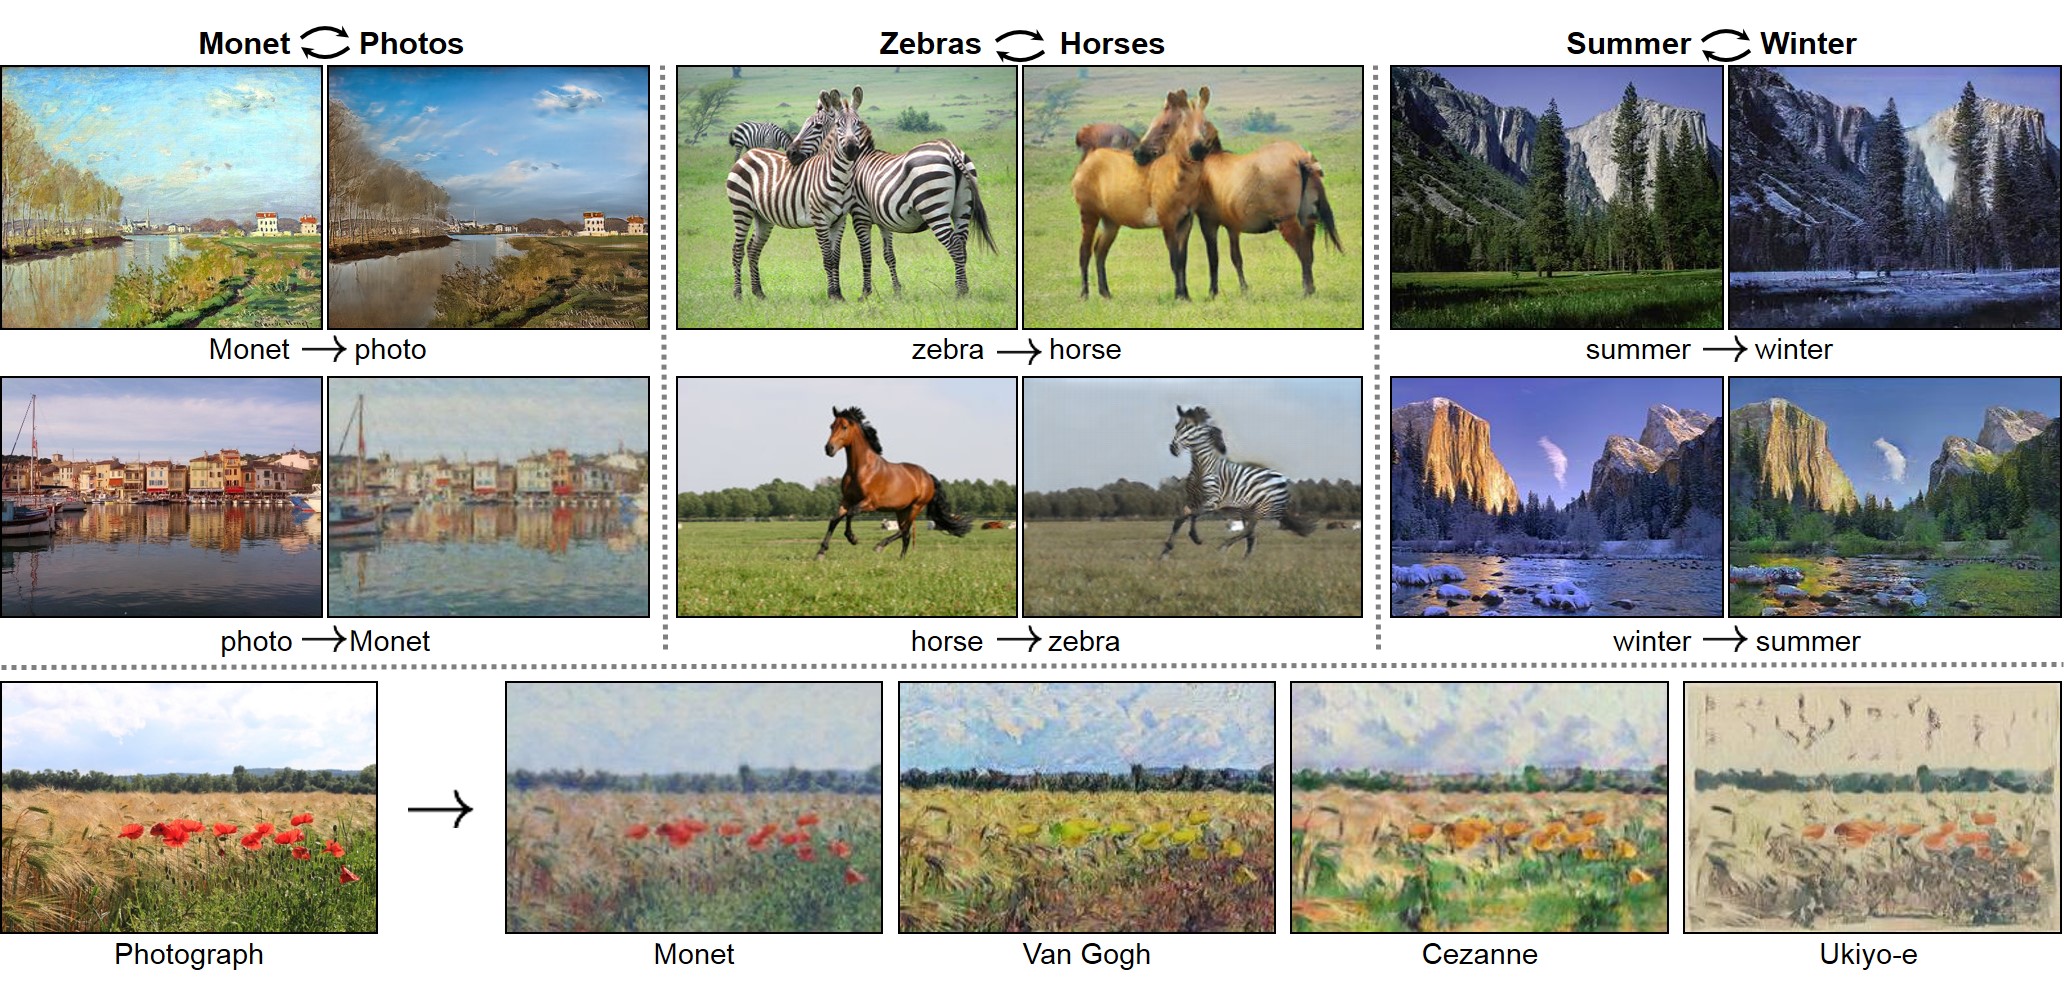
PyTorch 版 CycleGAN 与 pix2pix 实现,提供图像到图像翻译的完整训练与测试流程,支持无配对和有配对数据转换。

开源的多模态视觉指令微调模型,让 LLaMA 类大模型能看图对话,效果对标 GPT-4V,适合做图文问答和视觉助手。
工业级零样本语音合成系统,只需几秒参考音频就能克隆音色并跨语种合成,兼顾可控性与推理效率。