多模态生成

434 个仓库

图像、视频、语音与视觉语言模型。

Ditto
EzioBy·Python

基于扩散模型的指令式视频编辑方案,配套高质量合成数据集,解决视频编辑训练数据稀缺、难以规模化的问题。

视频编辑+4图像生成
634512026-06-01 08:32 UTC
nodetool
nodetool-ai·TypeScript

面向智能体的创意工作台,把图像生成、图像处理和动态图形等模型接入统一界面,方便在创作流程中直接调用多种多模态生成能力。

创意工作台+4图像生成
627+1290v0.8.122026-11-10 23:53 UTC
GPT-Image-2-Seedance-2.5-Workflow
Evolink-AI·Python

把 GPT Image 2 生成的图片接入 Seedance 2.5 做图生视频的工作流指南,含提示词与 API 调用示例,帮你快速跑通从出图到成片的流程。

图生视频+4视频生成
62184v1.0.02026-10-23 05:54 UTC
vibe-knowledge
andyhuo520·JavaScript

把单个知识点自动做成带旁白、逐句标注出处的知识短片,基于 Claude Code 技能,内置 44 套视觉风格,代码逐帧渲染成片。
知识短片+4视频生成
620+5893v1.0.02026-10-28 15:30 UTC
rai
RobotecAI·Python

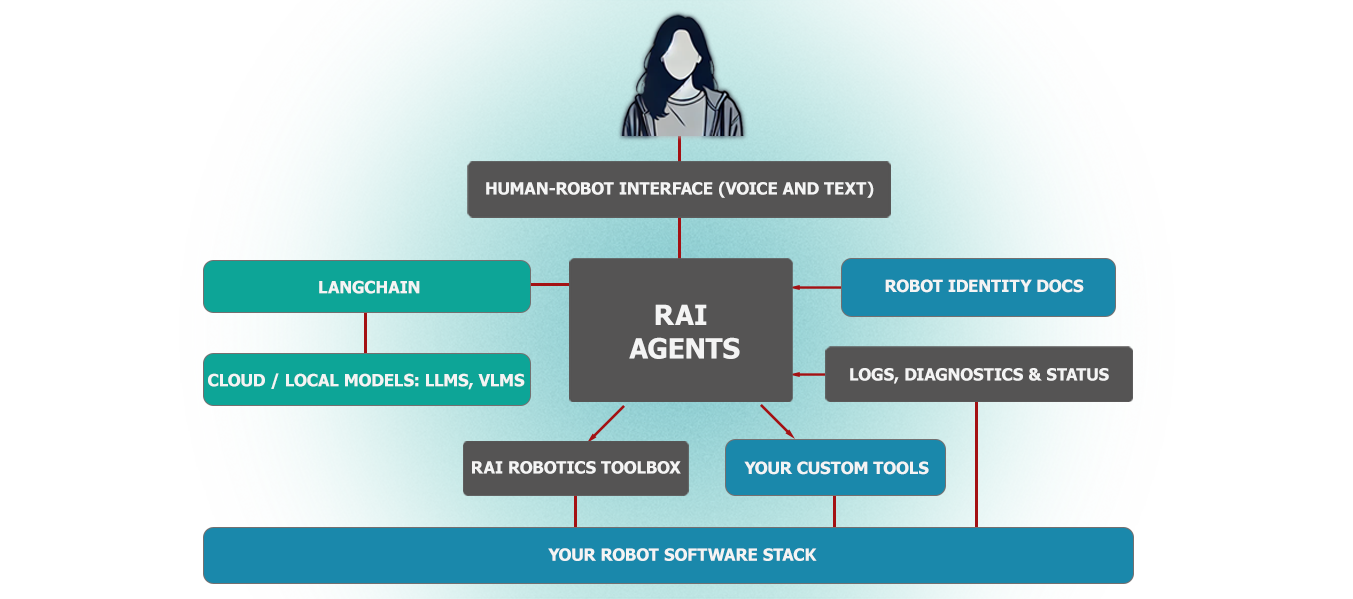
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
具身智能+4具身智能 / VLA
615+1792.12.42026-11-10 14:56 UTC
LAMDA-PILOT
LAMDA-CL·Python

基于预训练模型的持续学习工具箱,集成多种增量学习与终身学习算法,方便在视觉和视觉语言模型上做可复现的持续学习实验。

持续学习+4视觉语言模型
613692026-01-29 04:38 UTC
t2v_metrics
linzhiqiu·Python

用 VQAScore 给文生图、文生视频和文生 3D 模型打分的评测工具,基于视觉语言模型判断生成内容与文本提示是否匹配。

文生视频评测+4视觉语言模型
605752026-06-05 21:41 UTC
OmniChar
omnichar·Python

把角色的脸、身材、服装和声音打包进一个 .char 文件,让同一个角色在不同扩散模型和视频生成工具里保持一致,省去反复调参对齐的麻烦。

角色一致性+4图像生成
582+273v1.3.362026-10-29 10:15 UTC
awesome-gpt-image-2-5-prompts
youart-open-source·JavaScript

收录 150 条 GPT Image 2.5 社区提示词,覆盖 9 类使用场景,每条都标注原作者和出处,可直接拿来生成图片。

提示词库+4图像生成
573422026-09-11 10:50 UTC
LLaVA-Mini
ictnlp·Python

统一的多模态大模型,能高效理解图像、高分辨率图像和视频,用极少的视觉 token 完成多模态推理,适合显存和算力受限的场景。
多模态大模型+4视觉语言模型
573342025-06-29 07:56 UTC
cambrian-s
cambrian-mllm·Python

面向视频场景的空间超级感知多模态大模型,专注提升视觉语言模型对视频中空间关系的理解与推理能力。
多模态大模型+4视觉语言模型
573202026-04-03 14:59 UTC
ghostwriter
awwaiid·Rust

把 reMarkable2 电子纸平板变成视觉大模型的输入画板,手写或画图后直接发给 ChatGPT、Claude、Gemini 识别与对话。

电子纸平板+4视觉语言模型
573+245v2025.09.27-012026-11-06 00:08 UTC
ComfyUI-H3-FaceRefine
Carasibana·Python

在 MiniMax H3 生成的视频里逐帧追踪并裁剪小尺寸人脸,用 H3 精修后再拼回原画面,解决远景人脸模糊、细节丢失的问题。

人脸修复+4图像生成
56950v1.1.22026-09-13 03:23 UTC
Google-Colab_Notebooks
Isi-dev·Jupyter Notebook

一堆可直接在 Google Colab 上跑的生成式 AI 笔记本,覆盖 ComfyUI 工作流、Flux Kontext、混元、LTX 视频等图生图与图生视频玩法,省去自己配环境。

Colab 笔记本+4图像生成
568+41872026-11-10 18:34 UTC
payload-ai
ashbuilds·TypeScript

给 Payload CMS 装的 AI 插件,在后台直接做文本生成、AI 写作、翻译和图像生成,省去接第三方服务的麻烦。

内容生成+4图像生成
564+2684.2.02026-11-07 15:25 UTC
VideoTuna
VideoVerses·Python

一站式微调视频生成模型的工具库,支持文本到视频等扩散模型,方便做内容创作和视觉艺术定制。

视频生成+4视频生成
555292025-09-15 13:37 UTC
vlmrun-hub
vlm-run·Python

提供各行业专用的 Pydantic schema 集合,让视觉语言模型按统一结构输出 JSON,省去手写解析和字段对齐的麻烦。
视觉语言模型+4数据管道 / ETL
554252025-12-15 22:41 UTC
Awesome-Multimodal-Modeling
OpenEnvision·JavaScript

汇总多模态建模相关资源,覆盖多模态大模型(MLLM)、统一多模态模型(UMM)和原生多模态模型(NMM),方便快速查找论文与工具。
多模态建模+4视觉语言模型
551362026-10-18 16:58 UTC
shuixian-prompts
BaYue-SYJ·JavaScript

收录 5000+ 中文 AI 绘画提示词,按类别整理并支持检索和一键复制,覆盖 Midjourney、Stable Diffusion、Flux、即梦、可灵等主流生图模型,源码和数据集全部开源。
提示词库+4图像生成
549+790v1.0.72026-10-28 10:47 UTC
draw-ui
oil-oil·Python

给 Claude Code 和 Codex 用的 UI 设计与还原技能,能从截图生成设计稿,再把设计稿还原成可运行页面。

设计稿生成+4图像生成
545792026-10-04 14:54 UTC
awesome-aiart-pics-prompts
Jermic

收录 3000+ 条 Gemini Nano Banana Pro 高质量提示词与生成案例,覆盖摄影、设计、艺术、营销等领域,JSON 格式双语呈现,方便直接取用和二次整理。

提示词库+4图像生成
544502026-08-11 03:41 UTC
forge-film
F-R-L·Python

把影视生成的场景依赖建成 DAG,用关键路径法调度多模型并行出片,让原本逐个生成的镜头同时跑,缩短整片制作时间。
影视生成+4视频生成
540162026-03-26 11:38 UTC
UniTok
FoundationVision·Python

统一视觉分词器,把图像同时编码成适合生成和理解任务的离散 token,解决生成与理解模型各用一套 tokenizer 的割裂问题。

视觉分词器+4图像生成
536162025-11-14 23:44 UTC
visionary
Visionary-Laboratory·Python

基于 WebGPU 的高斯泼溅渲染平台,可在浏览器里跑 3DGS/4DGS 和神经渲染,用来做三维场景与数字人展示。

高斯泼溅+4图像生成
535+1362026-10-15 04:12 UTC