训练与微调
505 个仓库从预训练到微调再到后训练:框架、并行策略、参数高效方法与 RLHF。

跨平台高性能推理与训练加速引擎,可直接加载 ONNX 模型,兼容 PyTorch、TensorFlow 等框架导出,解决模型在不同硬件上高效部署的问题。
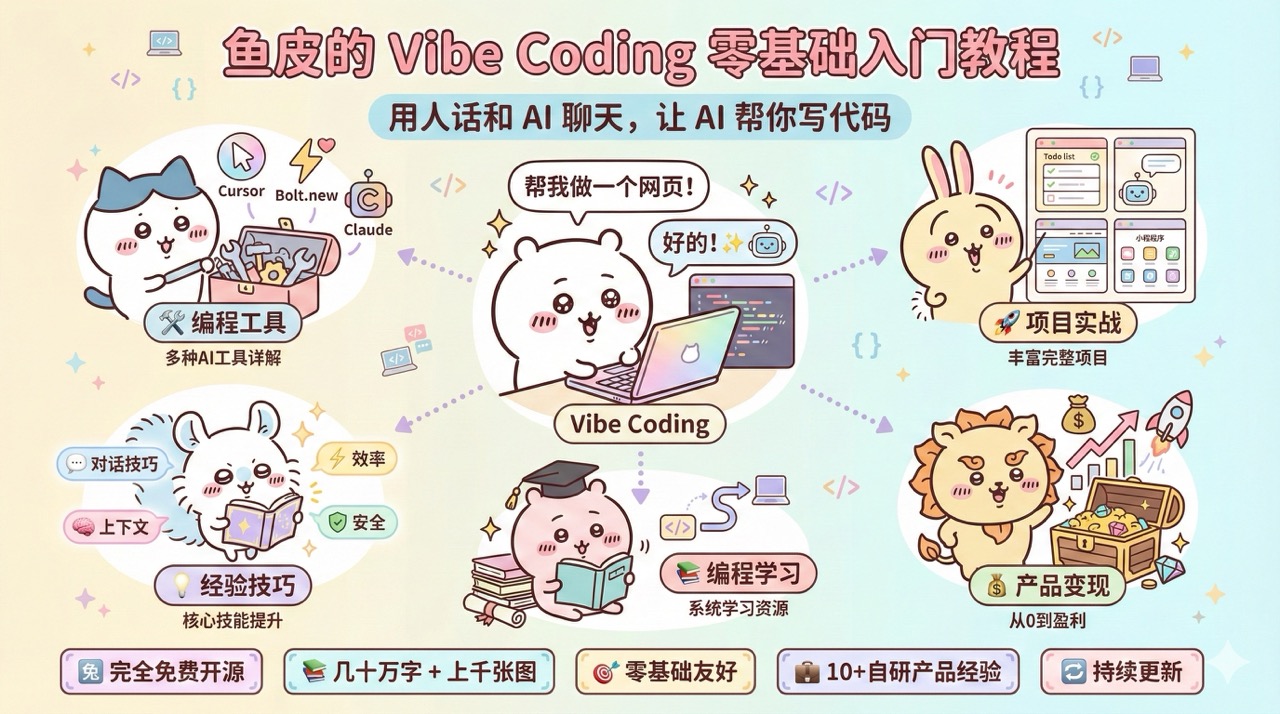
程序员鱼皮整理的 AI 资源大全与零基础教程,涵盖大模型玩法、Prompt 提示词、AI 编程工具和开发框架,帮新手快速上手 AI 技术。
微软出品的推荐系统实践库,提供从数据准备、模型训练到部署上线的完整示例和最佳实践,帮算法工程师快速搭建推荐与排序模型。
用 LoRA、Adapter 等少量参数微调大模型和扩散模型,大幅降低显存与训练成本,是 Hugging Face 生态里做参数高效微调的标准库。
高性能分布式图数据库,专为实时查询场景设计,支持知识图谱等大规模关联数据的存储与毫秒级检索。

ONNX 是开放的机器学习模型交换格式标准,让 PyTorch、TensorFlow、Keras 等框架训练出的模型能互相转换、跨平台部署。
开源金融大语言模型,提供训练好的模型和微调流程,用于金融情感分析、智能投顾等场景。
一份精选的机器学习生产化开源工具清单,覆盖模型部署、监控、版本管理和规模化扩展,帮你快速找到 MLOps 各环节的趁手工具。
用强化学习训练 Transformer 语言模型的全流程库,覆盖 SFT、奖励建模到 PPO/DPO 等 RLHF 算法,省去自己拼训练管线。

一套纯 Markdown 的轻量技能包,让 Claude Code、Codex 等 LLM 智能体在无人值守时自主完成机器学习研究:跨模型评审、想法发现与实验自动化。
在 LLaMA/Alpaca 基础上扩充中文词表并做中文增量预训练,提供可本地 CPU/GPU 部署的中文大模型及 LoRA 微调、量化方案。
用深度学习快速准确地识别文件真实类型,不依赖扩展名,支持 MIME 检测,Rust 实现,可嵌入各类应用做内容安全与文件分类。
Llama 官方示例手册,手把手教你在推理、微调、RAG 等场景中落地 Llama 系列模型,并覆盖多家云服务商的端到端方案。
NVIDIA 的大规模 Transformer 训练框架,支持张量并行、流水线并行等模型并行策略,用来在成百上千张 GPU 上高效预训练大语言模型。

面向企业私有化部署的 AI 平台,可搭建智能体、助手和文档检索问答,支持多模型接入、深度研究与 API 连接。
汇总 GitHub 上 PyTorch 相关的模型、实现、辅助库和教程,帮你在一个清单里快速找到需要的深度学习资源。
用 PyTorch 从零实现的轻量级 vLLM,代码精简易读,适合学习大模型推理引擎的调度、KV Cache 和 PagedAttention 等核心机制。
Rust 写的张量库和深度学习框架,兼顾灵活性与效率,支持自动微分、跨平台后端和内核融合,可训练和部署神经网络。
一站式大模型训练框架,支持 600+ 纯文本大模型和 300+ 多模态大模型的 CPT、SFT、DPO、GRPO 等训练,可用 LoRA 等 PEFT 方式或全参数微调。
在 Google Colab 上一键跑起 Stable Diffusion WebUI 的笔记本合集,省去本地显卡和环境配置,直接在线出图、图生图、训练 LoRA 和 DreamBooth。
把 PDF、DOCX、图片等复杂文档解析成干净结构化数据,方便喂给语言模型做 RAG 和检索。
DataTalks.Club 出品的免费 MLOps 实战课程,覆盖模型部署、监控和工作流编排,帮你把机器学习模型从实验推到生产环境。
Fast and flexible image augmentation library. Paper about the library: https://www.mdpi.com/2078-2489/11/2/125
开源平台,用于构建和部署基于 GPT/LLM 的对话式 Agent,集成提示词编排、工具调用与多渠道发布,省去从零搭建对话机器人的重复工作。