检索与 RAG
共 321 个仓库 · 近 4 个月有推送
UNet++ 的官方实现,通过嵌套密集跳跃连接缩小编码器与解码器之间的语义鸿沟,提升医学图像分割精度,提供 Keras 和 PyTorch 版本。
轻量级文档管理系统,支持 OCR、文件共享和自托管,用 Docker 部署即可获得企业级 DMS 的完整功能。
给编码智能体用的零依赖 C++23 命令行工具和 MCP 服务器,像 ripgrep 一样快速检索代码上下文,还能评估改动影响范围、该跑哪些测试和质量变化。

开源的风险决策基础设施与数据编排平台,把 KYC/KYB、身份核验、欺诈检测和合规审核流程串起来,帮风控团队统一管理案件与后台运营。

macOS 原生截图、录屏与视频编辑工具,提供截图工作台、75+ 自定义快捷键、URL Scheme 自动化和自托管云分享,可替代 CleanShot X 和 Loom。
LandingAI 官方命令行工具,在终端里解析 PDF 等文档,并按自定义 schema 抽取结构化数据,省去写代码调接口的麻烦。

把扫描件、邮件附件等来源的杂乱文档集中管理,自动做 OCR 和 NLP 分析并打标签归类,减少手工整理成本。
用 Rust 写的高性能 GraphRAG 引擎,灵感来自 LightRAG,把文档转成知识图谱,让检索和生成效果更好。
本地优先的求职智能工作台,自动抓取招聘岗位、按匹配度排序,并生成定制化的申请材料。

用 Python 在知识图谱上做表示学习,把实体和关系训练成向量,方便做链接预测和关系推理。
给 Obsidian 笔记库加一个开箱即用的全文搜索引擎,支持 PDF 和图片 OCR 内容检索,不用折腾配置就能快速定位笔记。
把 NestJS 的控制器直接变成类型安全的 API 和 LLM 函数调用工具,省去手写 DTO 与校验,适合快速搭建 AI 聊天机器人后端。
用 Cython 封装的 Tesseract OCR Python 库,可直接调用底层 API 做文字识别,比命令行调用更高效、控制更细。
开箱即用的开源 RAG 平台,内置引用溯源、深度研究和分区隔离,支持 22+ 文件格式与 MCP 服务,帮团队快速搭出可落地的检索增强应用。
为 AI Agent 提供持久化长期记忆的 MCP 服务,支持 LangGraph、CrewAI、AutoGen 和 Claude,通过 REST API、知识图谱和自主整合让智能体跨会话记住上下文。
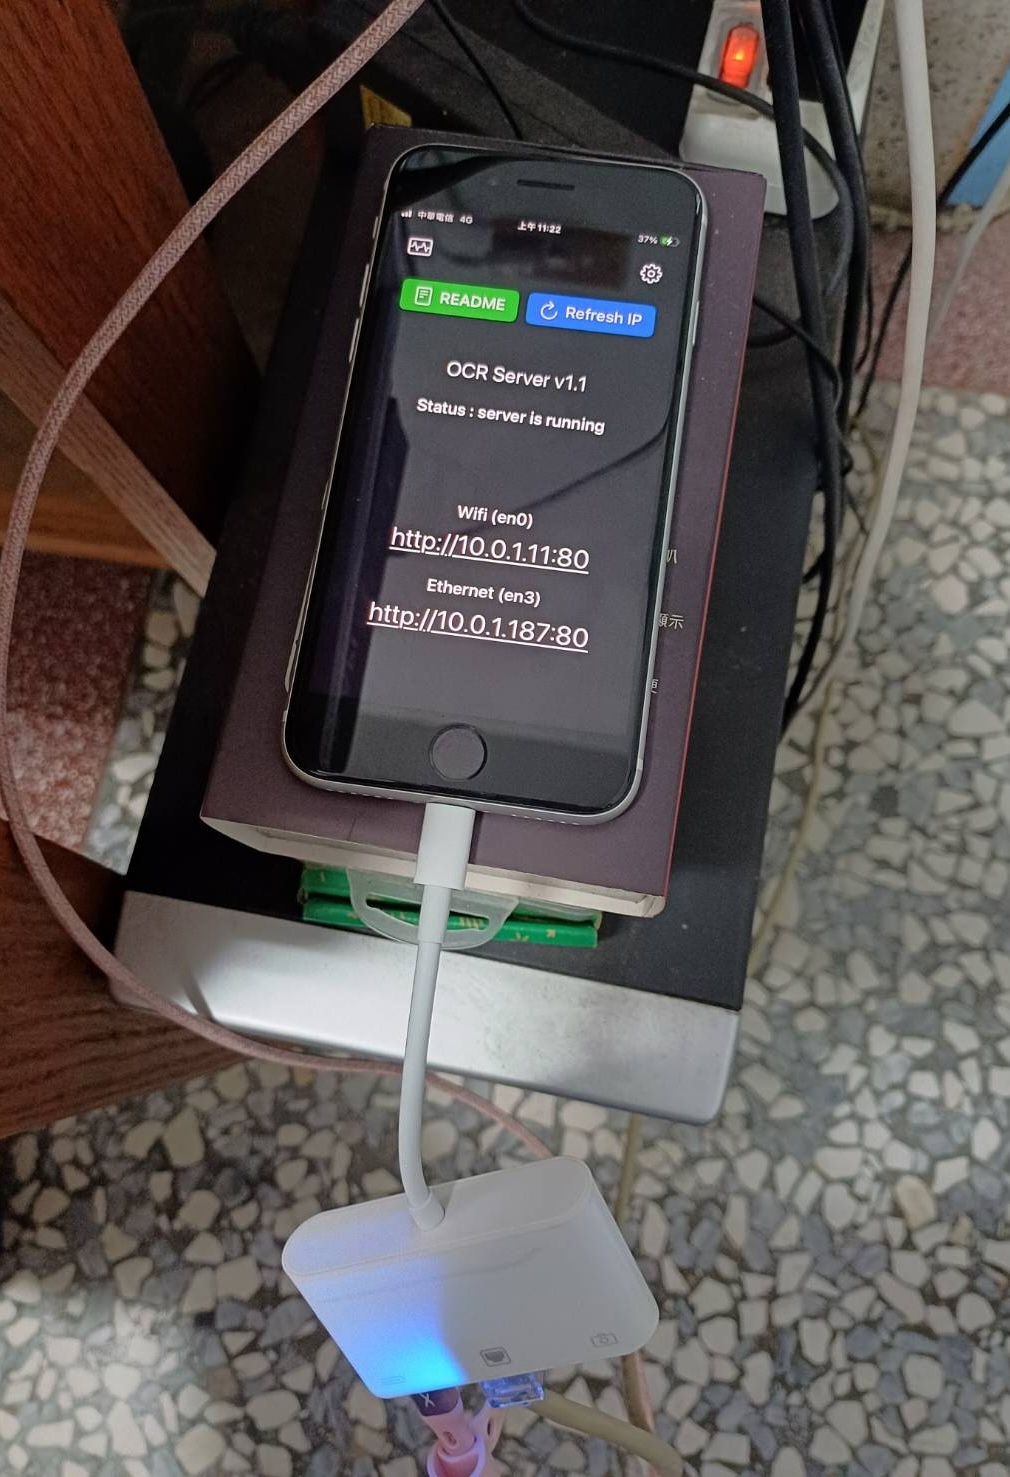
把 iPhone 变成 OCR 服务器,基于 Apple Vision 框架提供 HTTP 接口,让局域网内其他设备直接调用 iOS 的离线文字识别能力。

AI 原生 HTAP 数据库,内置向量检索和 Git-for-Data 数据版本管理,可作为智能体与 AI 应用的数据和记忆底座。
面向 AI 编程助手和 IDE 的高性能代码智能引擎,基于图结构索引 257 种语言和多个仓库,通过 CLI、MCP 和 API 只暴露必要代码信息,把 token 消耗最多降低 50 倍,且完全本地运行。
基于 Tesseract 的图形界面 OCR 工具,支持扫描仪输入和 PDF 文档处理,方便把图片和扫描件转成可编辑文本。
汇集各类 RAG(检索增强生成)框架、项目和资源的社区清单,方便快速找到并对比检索增强生成生态里的现成方案。
汇总联邦学习领域的论文、框架、数据集、教程和研讨会信息,帮研究者快速跟进最新进展。

基于 TiddlyWiki 的本地优先知识管理桌面应用,支持自动 Git 云备份、隐私保护、部署为博客,并通过 REST API 与 Anki 等工具连接。
把原始文档编译成结构化、本地优先的 wiki 知识库,用可读可维护的编译式方案替代传统 RAG,支持自管理自改进。
基于 GPU 加速的视频分析智能体参考架构,用视觉语言模型、LLM 和 RAG 实现长视频的实时告警、视觉问答与自动报告生成。