Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 28 / 43 页把 ONNX 模型一键转成 TFLite、TensorFlow、PyTorch 原生代码或 TorchScript,省去跨框架部署时手写转换脚本的麻烦。

基于 Wiktionary 构建的通用多语言及单语词典,可打包用于 Kindle、Kobo、KOReader 等电子书阅读器和手机、桌面应用。
面向开发者的 AI 学习路线图,系统梳理大模型训练、推理、强化学习与 Agent 等核心方向的概念、主流技术和前沿趋势,帮助从理论走到落地。
基于 OWASP MASVS 框架的 Android 应用静态代码分析工具,帮开发者和安全测试人员快速发现并修复代码中的安全漏洞。
基于视觉语言模型的无解析 RAG 方案,直接把文档当图片做检索和生成,省去 OCR 和版面解析环节,减少信息损失。
一个 Python 包集成 30 种协议蜜罐,覆盖 SSH、MySQL、Redis、SMB 等常见服务,用来诱捕攻击、记录凭据并辅助恶意软件与网络流量分析。

一款多功能的系统监控工具,能实时查看 CPU、内存、磁盘、GPU、网络、传感器和进程等运行状态,适合排查性能问题。
把 Meta 的 Segment Anything 打包成开箱即用的视频目标分割工具,配合 YOLOv5~v8 做检测后分割,省去自己搭环境的麻烦。
用大模型从文本中自动抽取实体与关系,构建带时间维度的知识图谱,适合做 RAG 检索和结构化知识沉淀。
汇总 ICCV 2023–2025 三届顶会的计算机视觉论文,附代码链接,方便快速追踪 3D 重建、人脸识别等方向的最新研究。
GLaMM 是首个能把自然语言回答和物体分割掩码无缝结合的多模态大模型,让模型在对话中直接指出并分割出提到的物体。
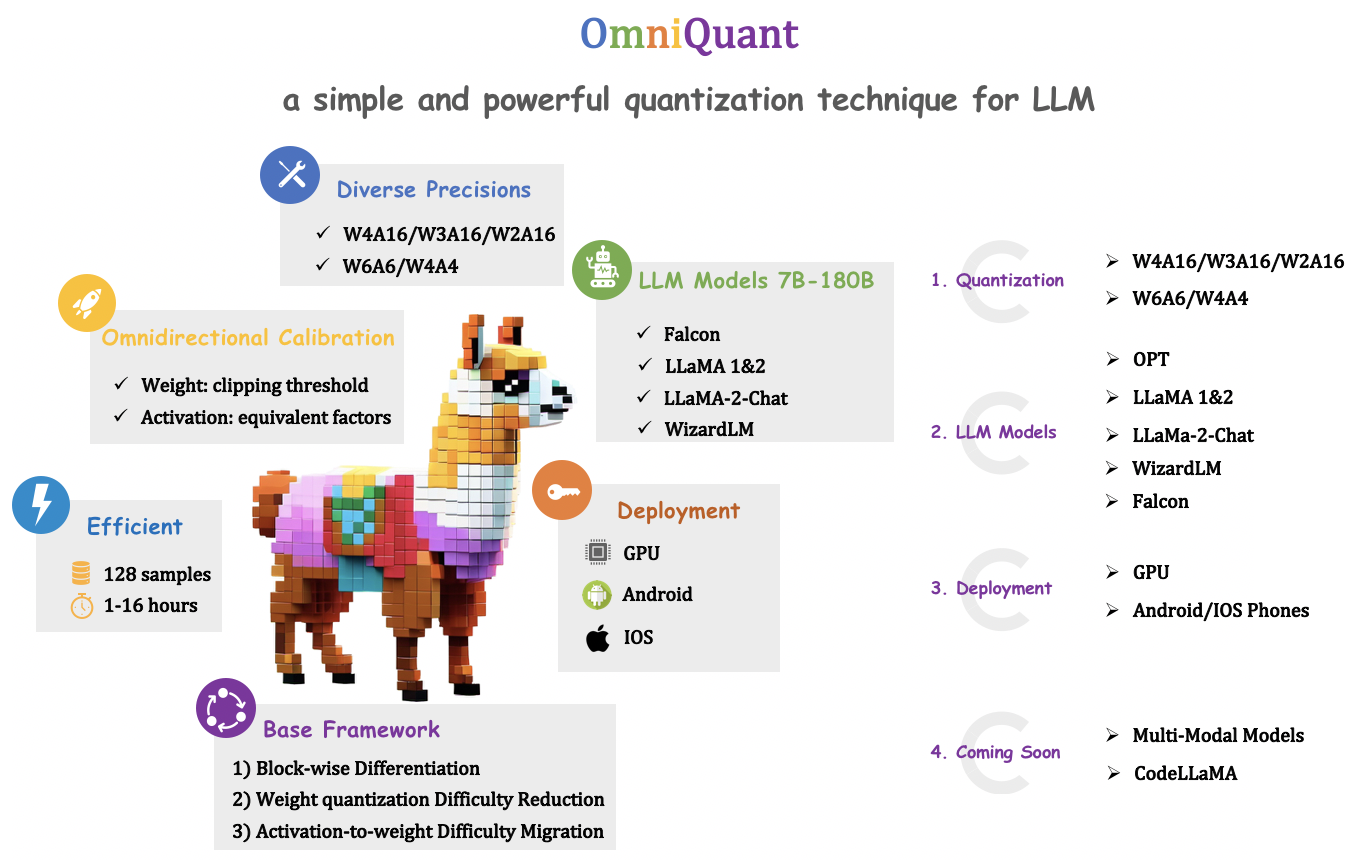
一种简单又强大的大模型量化技术,通过可学习权重裁剪和等价变换,在保持精度的同时把 LLM 压到低比特,方便部署推理。
把 Scenario 的 AI 生图、视频、3D 与 PBR 材质生成直接搬进 Blender 视口,并内置本地 MCP 服务器供智能体调用。
汇总音频 AI 领域的论文、开源模型、基准和数据集,覆盖音频大模型、语音识别、TTS、音乐与音频生成,方便按方向查找资料。
HQQ 是一种无需校准数据的大模型量化方法,官方实现支持几行代码把 LLM 压到低比特,省显存还能保持精度。
用自托管 Whisper 配合 WebSocket 做近实时语音转写,Python 后端加 JS 前端,适合自己搭一套低延迟的语音识别服务。
用 Python 封装 Mastodon 的 REST API,方便开发者在脚本或应用里发帖、读取时间线、管理账号,不用自己拼 HTTP 请求。
面向自动驾驶场景的 3D 目标检测开源实现,基于深度学习的点云与图像融合方法,可用于训练和评测车辆、行人等目标的立体检测模型。
用多查询生成和倒数排名融合(RRF)提升 RAG 检索质量,附带 NFCorpus/BEIR 评测脚本,方便对比不同检索策略的效果。
无需训练的长篇故事可视化迭代框架,通过多轮迭代生成保持角色与情节一致的故事配图,解决长文本生成图像时前后不一致的问题。
用 Python 写的透明 RAG 参考实现,把 FAISS 向量检索和 BM25 关键词检索做混合召回再重排,配 Gradio 界面和 FastAPI 接口,方便本地搭文档问答。
一款便携 USB 嗅探硬件,集成 CC1352、SX1262 和 RP2040,用于抓包、通信和攻击 BLE、LoRa、Zigbee 等物联网无线协议。
用 Rust 直接实现 Chrome DevTools 协议,为 Python 和 Node 提供与 Playwright 一致的浏览器自动化 API,省去 driver 子进程,启动和调用更轻快。

面向 AI Agent 的 trace 原生 CI/CD:给生产链路打分、聚类失败样本,冻结成可回放的回归测试,并拦截会让效果退化的 PR,支持自托管。
命令行工具,从 Spotify 批量下载歌曲、播客和视频,支持 AAC、OGG Vorbis 等格式,适合离线收藏音乐内容。
基于 todo.txt 格式的命令行待办事项管理工具,支持过滤、排序和自定义命令,适合习惯在终端里管理任务的人。
用 Python 做点击流和事件日志分析的工具包,支持用户旅程、行为分群、A/B 测试和马尔可夫链模拟,还能让 AI 代理复现并交叉验证分析结果。
开箱即用的自托管离线转录与说话人分离服务,集成 WhisperX 和本地 LLM 自动生成会议摘要,数据不出内网。
把 PDF 等非结构化文档转成经过校验、可查询的知识图谱,方便做 RAG 和文档关系分析。
用 Python 写的 MangaDex 漫画下载命令行工具,支持按章节批量抓取并保存到本地,省去手动逐页保存的麻烦。
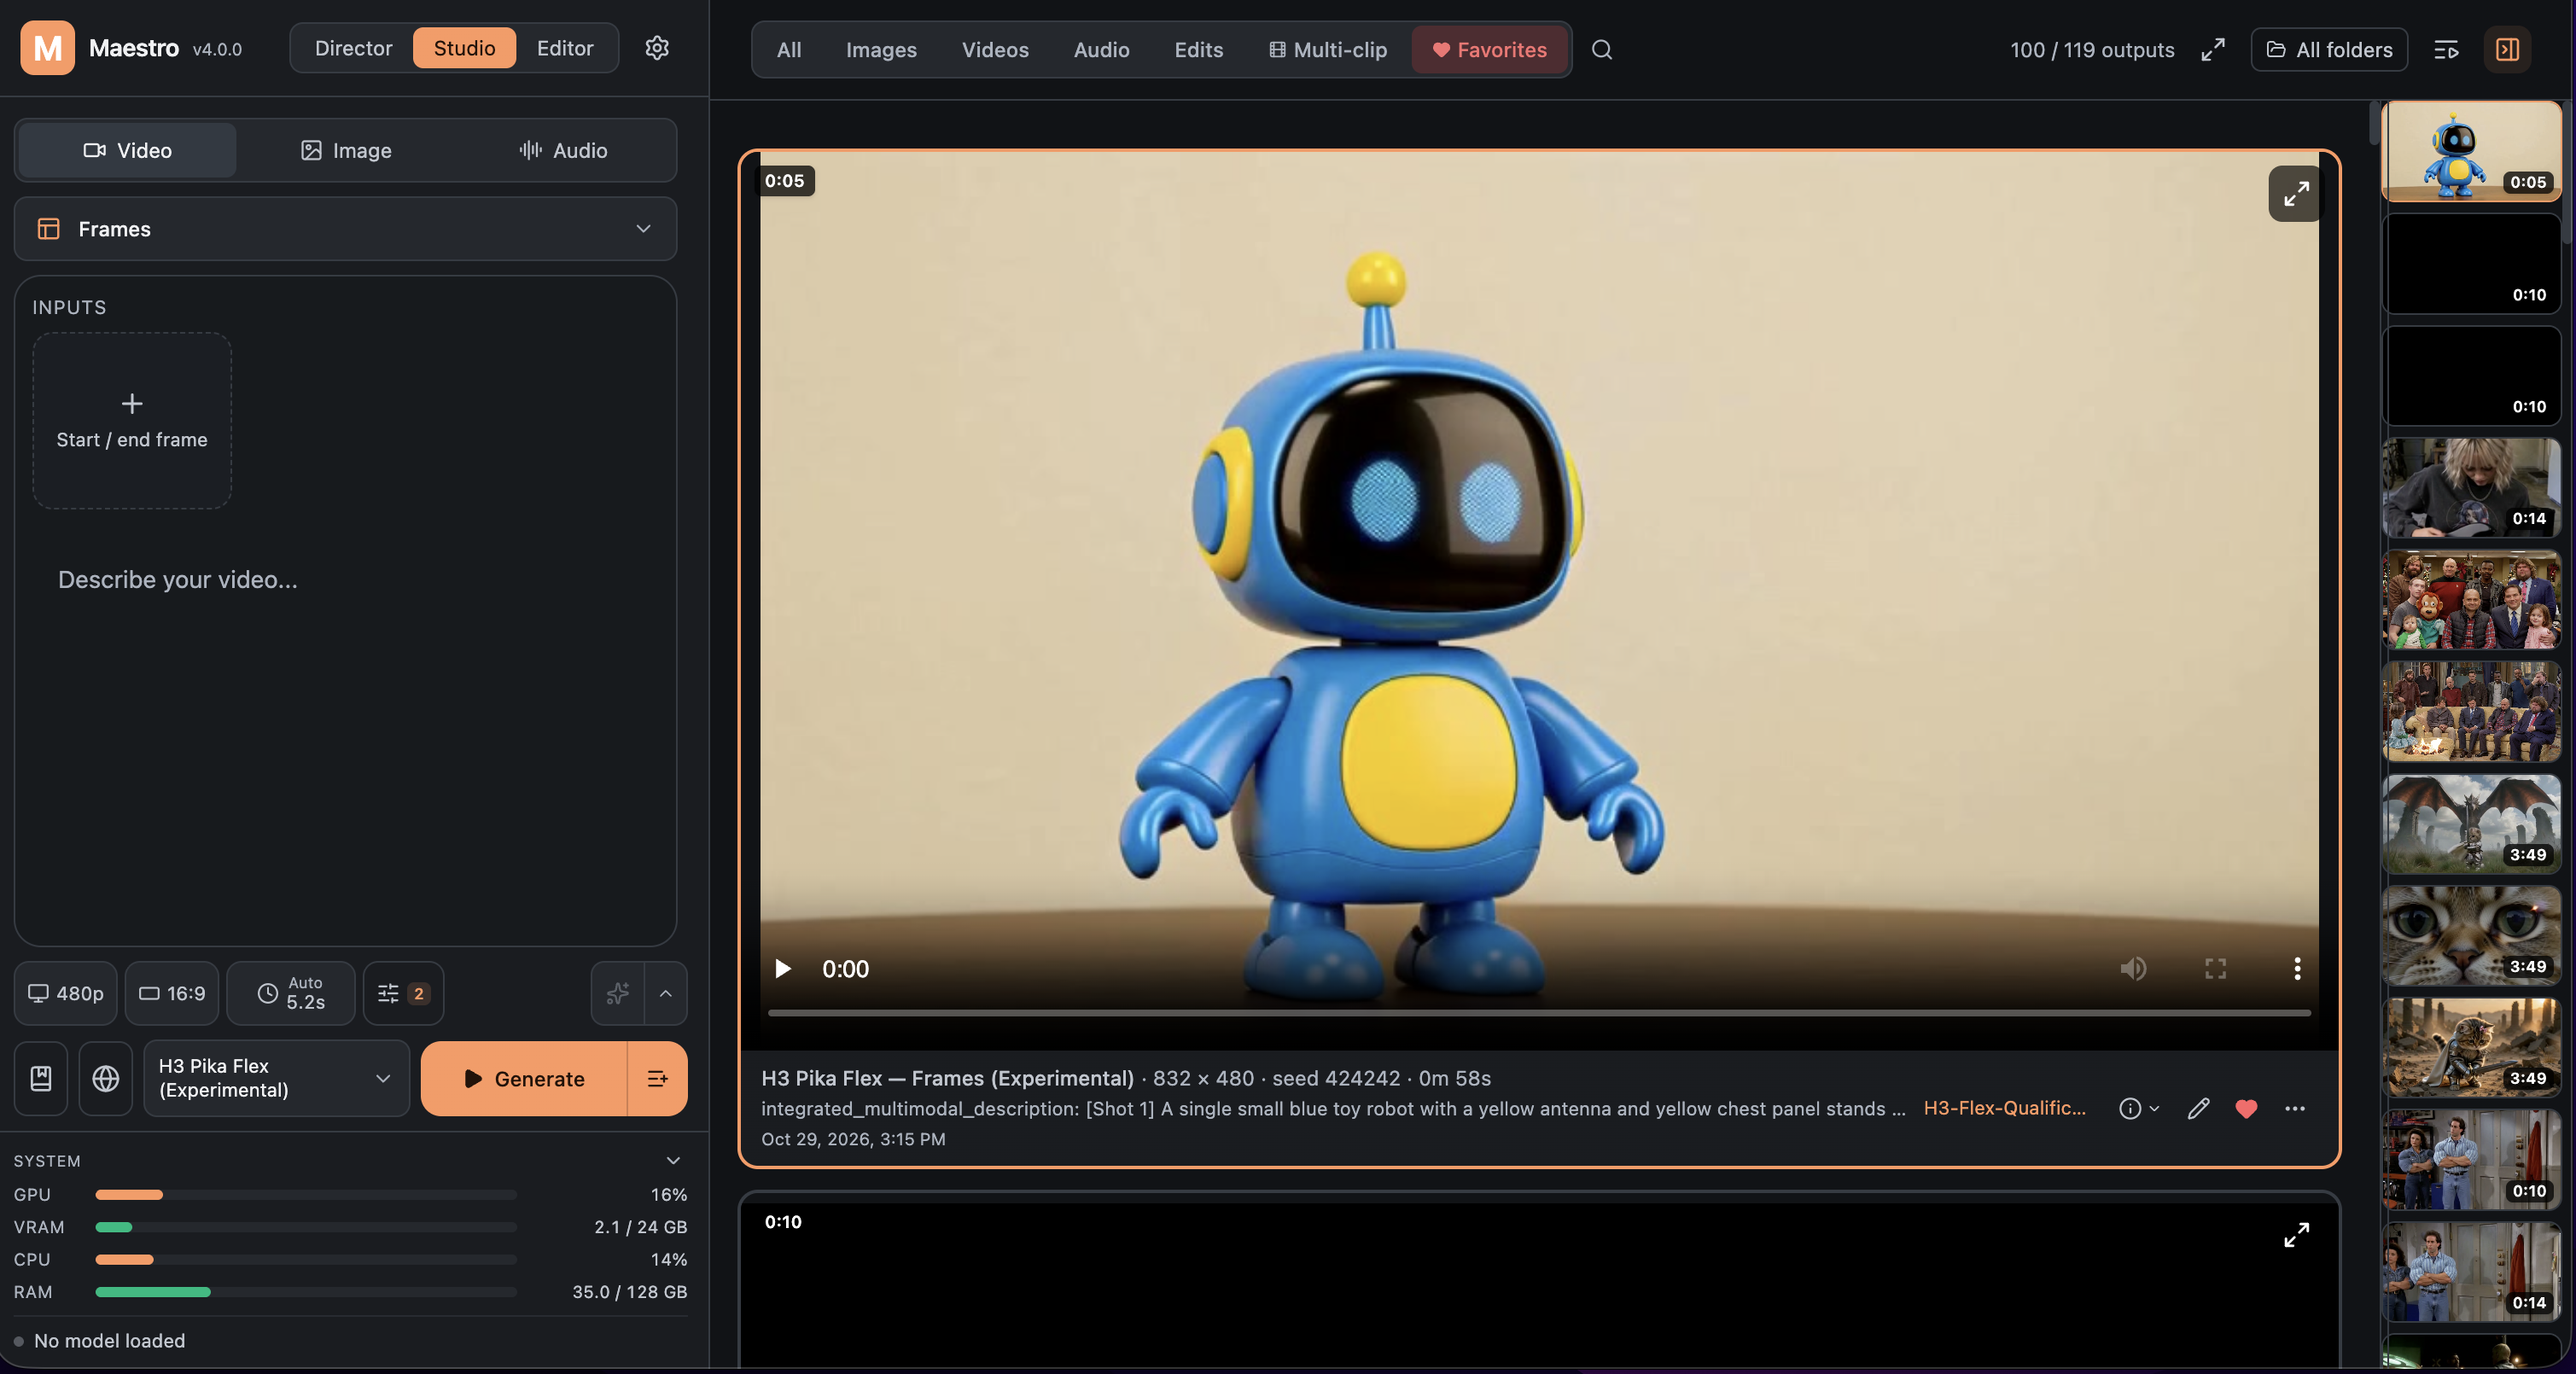
一站式本地 AI 影音工作室,输入一句提示词就能规划完整音乐视频和短片,涵盖视频、图像与音乐生成,基于 WanGP 流水线并通过 Pinokio 安装。
FasterViT 是 NVIDIA 提出的高效视觉主干网络,通过分层注意力机制在 ImageNet 分类、COCO 检测和 ADE20K 分割上兼顾精度与推理速度。
自托管的本地视频压缩 WebUI,基于 FFmpeg 和 GPU 加速,把大视频压到指定体积,适合需要批量处理又不想上传云端的人。
给 AI Agent 配一个真实浏览器,关键步骤可人工接管,基于 MCP 协议、可自托管运行。
从零训练原生视觉语言模型的开源系列,去掉独立视觉编码器,让多模态理解与生成在统一架构里完成。
基于 FastAPI 的 RAG 服务,用 LangChain 对接 PostgreSQL 和 pgvector,按 ID 管理知识库,方便快速搭建检索增强生成后端。
给 AI 编程助手装一个本地长期记忆库,精确记住你说过的每句话和工作习惯,兼容 Cursor、Claude Code、Codex 等工具。
基于 TensorFlow 的端到端数据压缩库,用神经网络实现图像等数据的压缩与解压,适合研究学习式压缩算法。
让 HuggingFace 上的 Transformers 和 Diffusers 模型无缝跑在昇腾 MindSpore 上,省去手动迁移适配的麻烦,并支持加速。
基于 CNN 的音频分割工具包,能自动切分语音、音乐和噪声片段,并识别说话人性别,适合大规模按性别统计发言时长的研究。
面向长时程视频世界模型的开源数据集与可扩展训练方案,支持扩散模型和图像到视频生成,可用于实时交互式游戏引擎等场景。
基于 PyTorch 的医学图像分割非官方实现,支持 2D 和 3D 数据,方便快速搭建和训练分割模型。
爬取网页或读取 PDF、DOCX、TXT 并抽取正文,再用向量检索让 ChatGPT 基于内容回答问题或生成摘要。
把 KeePass、1Password 等主流密码管理器里的数据迁移到 pass 密码库的命令行扩展,省去手动逐条搬运的麻烦。
微软推出的可扩展 Windows 操作系统平台,用于测试和基准评测多模态 AI 智能体在真实桌面环境中的表现。
面向人的深度学习实用工具库,封装了 3D 目标检测、分割、传感器融合和视频合成等常用功能,省去重复造轮子。
基于微调 Whisper 模型提供语音转文字 API,支持用户级权限控制,方便把 ASR 能力接入自己的应用。
基于 Diffusers 的实时扩散模型演示应用,用潜在一致性模型把文生图做到近乎即时的出图,并通过 MJPEG 推流展示生成过程。