Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 34 / 43 页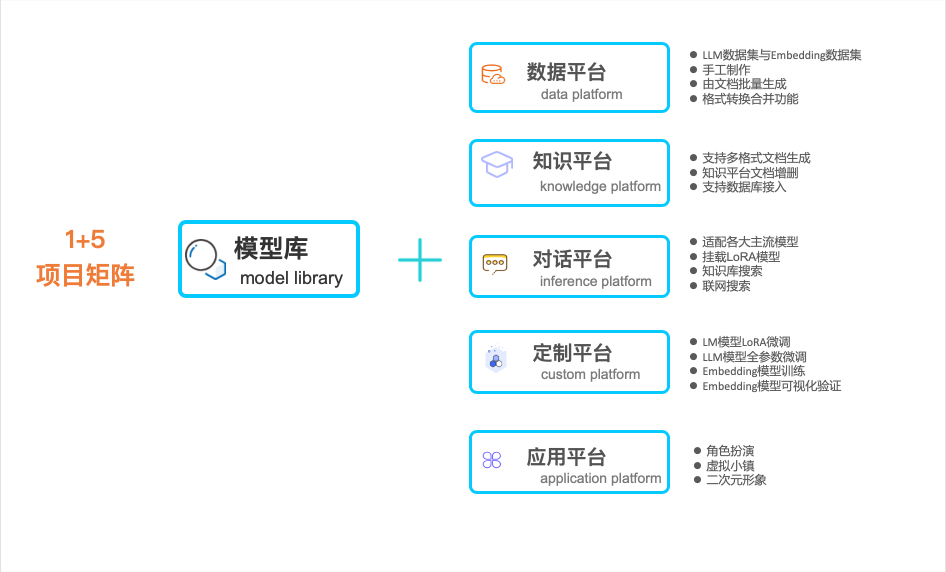
把主流大模型 API 和开源模型统一到一个 WebUI 里,覆盖知识库、数据库、角色扮演、文生图、LoRA 微调、数据集制作等全流程工具。
一站式微调视频生成模型的工具库,支持文本到视频等扩散模型,方便做内容创作和视觉艺术定制。
基于层次化知识图谱的 Graph RAG 系统,把文档组织成分层结构来提升检索增强生成的召回与准确度,开箱即用。
为 Claude Code、Codex 等编码智能体提供 55 个严谨技能包,覆盖代码审查、安全审计、功能开发、前端设计、MCP 工具和 Hugging Face 模型训练。
命令行驱动的 AI 编码代理编排工具,能并行运行多个代理和模型、对比原始回答,并协调代码审查与实现流程。
提供各行业专用的 Pydantic schema 集合,让视觉语言模型按统一结构输出 JSON,省去手写解析和字段对齐的麻烦。
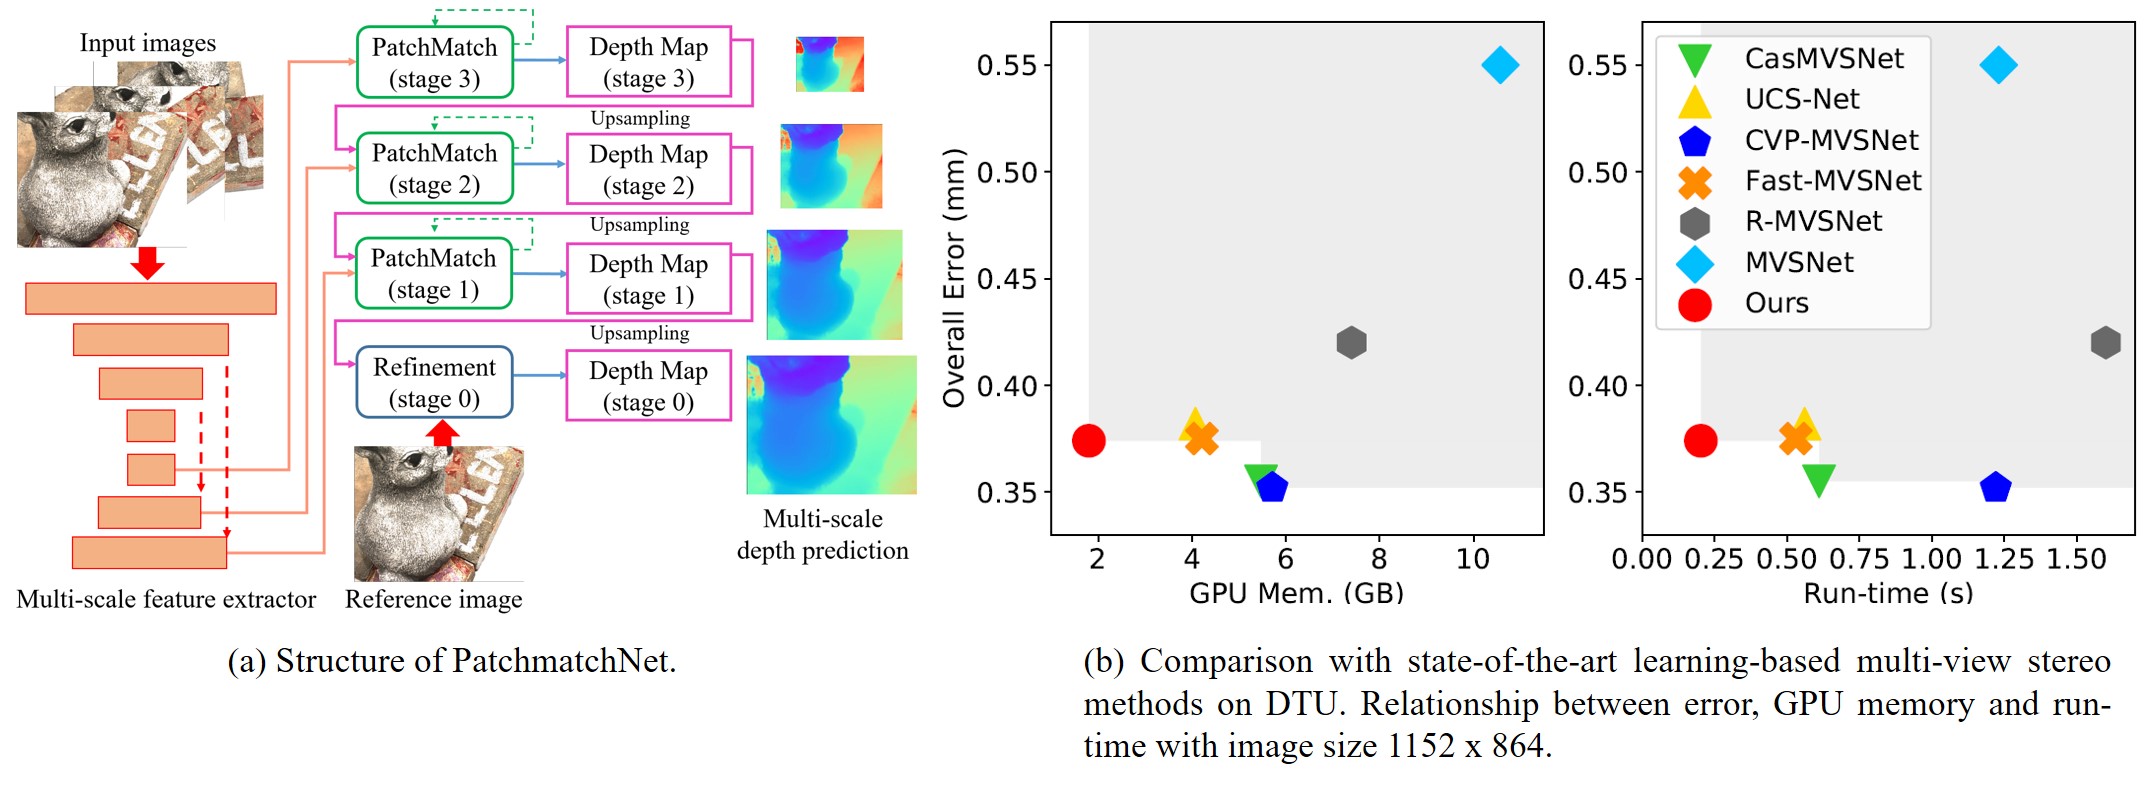
PatchmatchNet 是 CVPR 2021 Oral 的官方实现,用可学习的 Patchmatch 做多视图立体匹配,从多张图片重建稠密三维点云。
从单张图片生成多视角一致图像,进而重建完整三维场景,解决单视图场景重建中视角覆盖不足的问题。
自动从互联网公开资源采集并整合直播源、台标 Logo 和 EPG 节目单,格式化输出适配 IPTV、电视盒子与手机直播 APP,省去手动找源和测速的麻烦。
法语本地语音助手,可接 Claude 或离线 Ollama,用语音控制 Hue 灯、OBS、日程、浏览器和 Twilio 电话,并自带 MCP 服务端。
面向大规模场景的可扩展测试时训练 3D 重建方案,通过在线自适应提升深度估计与重建精度,适合处理超长序列和大范围场景。
开箱即用的 LiDAR SLAM 系统,用 Python 实现,能直接完成激光雷达建图与定位,省去繁琐配置。
把 Substack 免费和付费文章批量下载成 Markdown,并生成 HTML 界面按作者浏览排序,方便本地归档和阅读。
给 Claude Code 和 Codex 用的 UI 设计与还原技能,能从截图生成设计稿,再把设计稿还原成可运行页面。
一个可完全复现、从零起步的自我进化智能体系统,让智能体在开放式任务中边执行边自我迭代,无需预置经验即可持续提升能力。
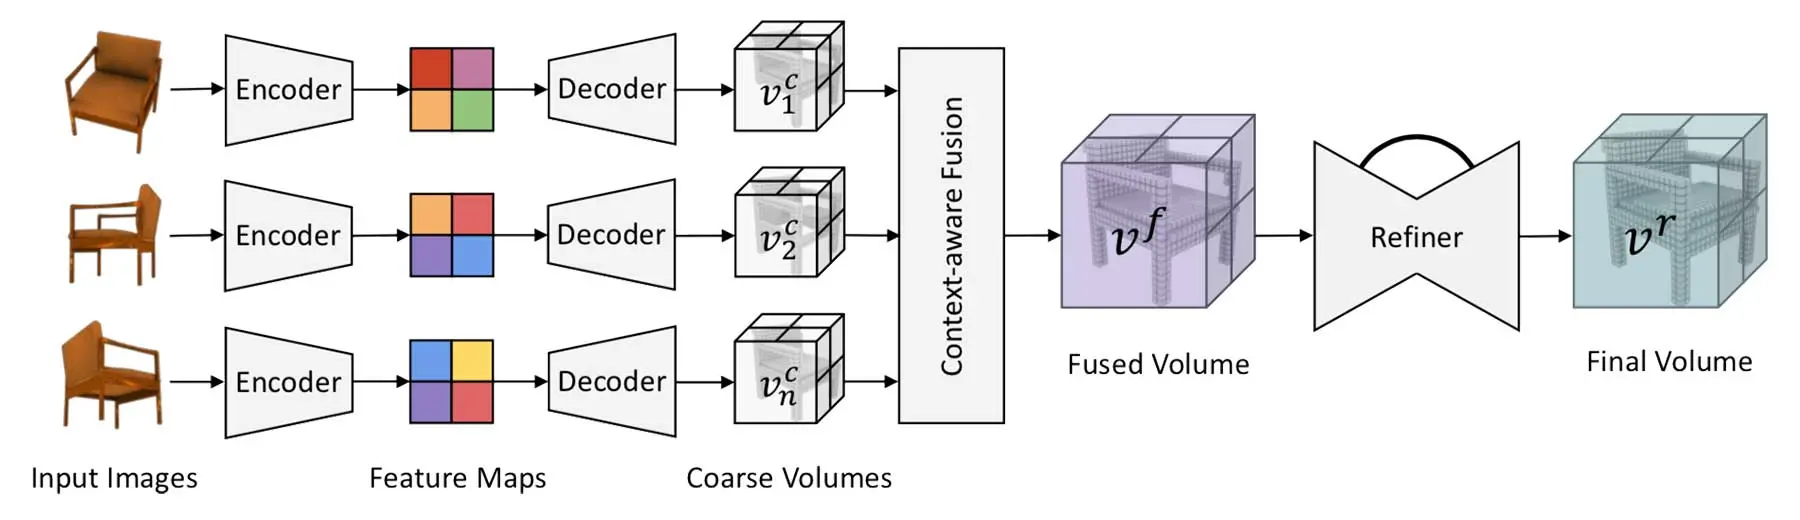
从单张或多视角图片重建三维体素模型的官方实现,基于 ICCV 2019 论文,用上下文感知融合提升重建精度。
面向 AI 场景的命令行网页抓取工具,可并行运行,把网页内容转成高质量 Markdown,方便喂给大模型或做知识库。
开放词表目标计数模型,基于视觉语言基础模型,能按任意文本描述统计图像中物体数量,无需针对新类别重新训练。
MILo 是 SIGGRAPH Asia 2025 的官方实现,把网格优化嵌进 3D 高斯泼溅流程,从多视角图像重建出细节丰富又轻量的表面网格。
把影视生成的场景依赖建成 DAG,用关键路径法调度多模型并行出片,让原本逐个生成的镜头同时跑,缩短整片制作时间。
给 Hermes、Claude Code、Codex 等编码 Agent 提供本地长期记忆,用单个 SQLite 库存储,支持带来源回溯的混合检索,并能查看、纠正或删除记忆内容。
通过 SSH 在终端里直接显示并操作完整的远程桌面,无需额外客户端或图形转发,适合在纯命令行环境下远程控制图形界面。
用 Python 调用华为 LTE 路由器(LAN/WAN)的接口,读取信号、流量、设备状态等信息,省去自己抓包逆向的麻烦。
用 Python 统一调用 OpenAI、Claude、Gemini 等大模型 API 的轻量客户端,想用更简单的方式替代 LangChain 和 LangGraph 处理常见场景。
基于 asyncio 和 aiohttp 的异步 Docker API 客户端,让 Python 应用以非阻塞方式管理容器、镜像和网络。
用 GPT 嵌入和向量检索引擎处理海量公开情报数据,把零散 OSINT 信息变成可语义搜索的知识库。
统一视觉分词器,把图像同时编码成适合生成和理解任务的离散 token,解决生成与理解模型各用一套 tokenizer 的割裂问题。
基于 WebGPU 的高斯泼溅渲染平台,可在浏览器里跑 3DGS/4DGS 和神经渲染,用来做三维场景与数字人展示。
面向大语言模型的低延迟、高吞吐推理服务引擎,基于 PyTorch 和 Transformer 架构,适合部署 Llama 等模型对外提供在线推理服务。
用 Python 抓取 Google Maps 上商户的评论数据,适合做口碑分析和竞品调研时批量采集评论。
基于曼哈顿世界假设的神经隐式三维重建方法,利用场景中互相垂直的平面结构约束,从多视角图像重建室内房间的稠密几何。
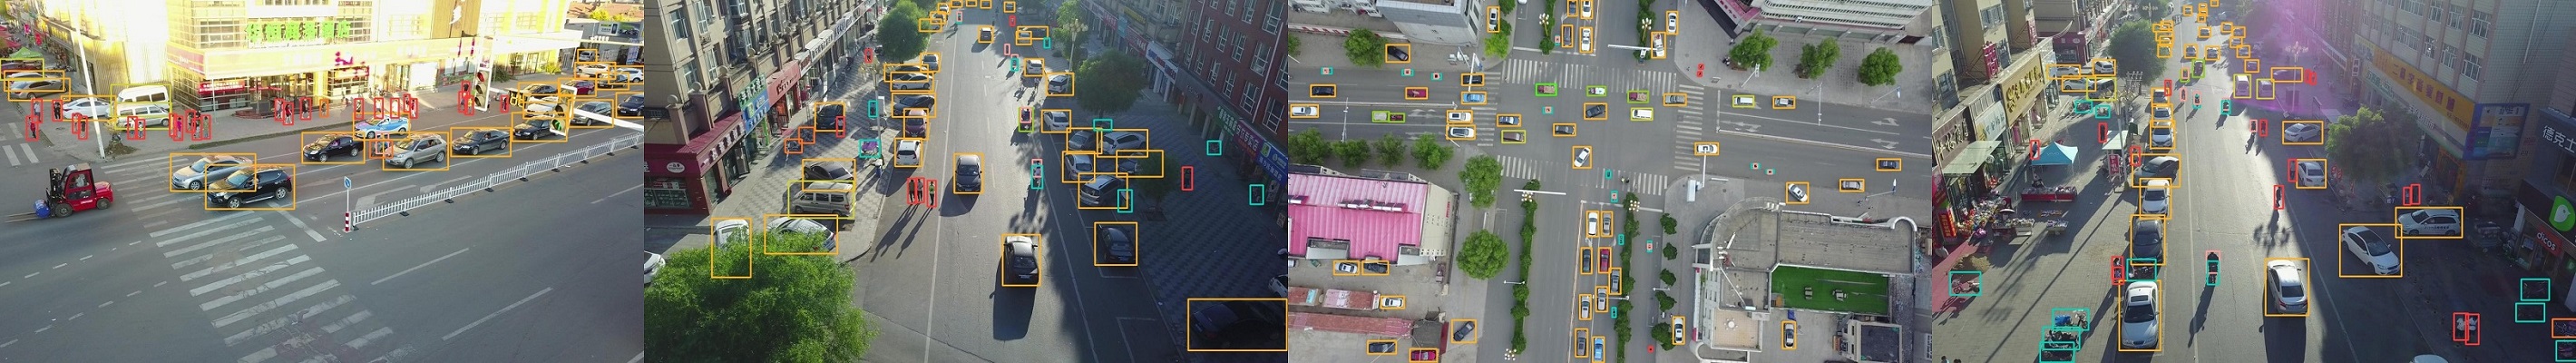
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。

ARCTIC 数据集官方工具链,提供下载、预处理、可视化和模型训练脚本,用于手物交互与手部追踪研究。
把日常电脑操作录成结构化工作流,让 AI 代理通过 MCP 在本地直接复现执行,全程数据不出本机。
把向量检索、知识图谱和交叉编码器重排揉在一起的混合 RAG 系统,支持 Docling 解析文档、图片表格理解、流式对话和行内引用,可接 Gemini 或本地 Ollama。
用稀疏视角图像在几秒内重建大规模三维场景,把体素与高斯泼溅结合成 VoxSplats 表示,适合快速生成可渲染的城市场景。
本地优先的全栈 AI 创作工作站,集成对话、漫画、漫剧、写作和知识学习五大模块,支持 vLLM、llama.cpp 等多引擎本地推理与显存智能调度。
在终端里搜索、观看和下载动漫的命令行工具,基于 Python 抓取 Gogoanime 等站点资源,也可作为 API 调用。
用 Python 流式生成 ZIP 文件,边写边发,不用把整个压缩包读进内存,适合大文件或内存紧张的场景。
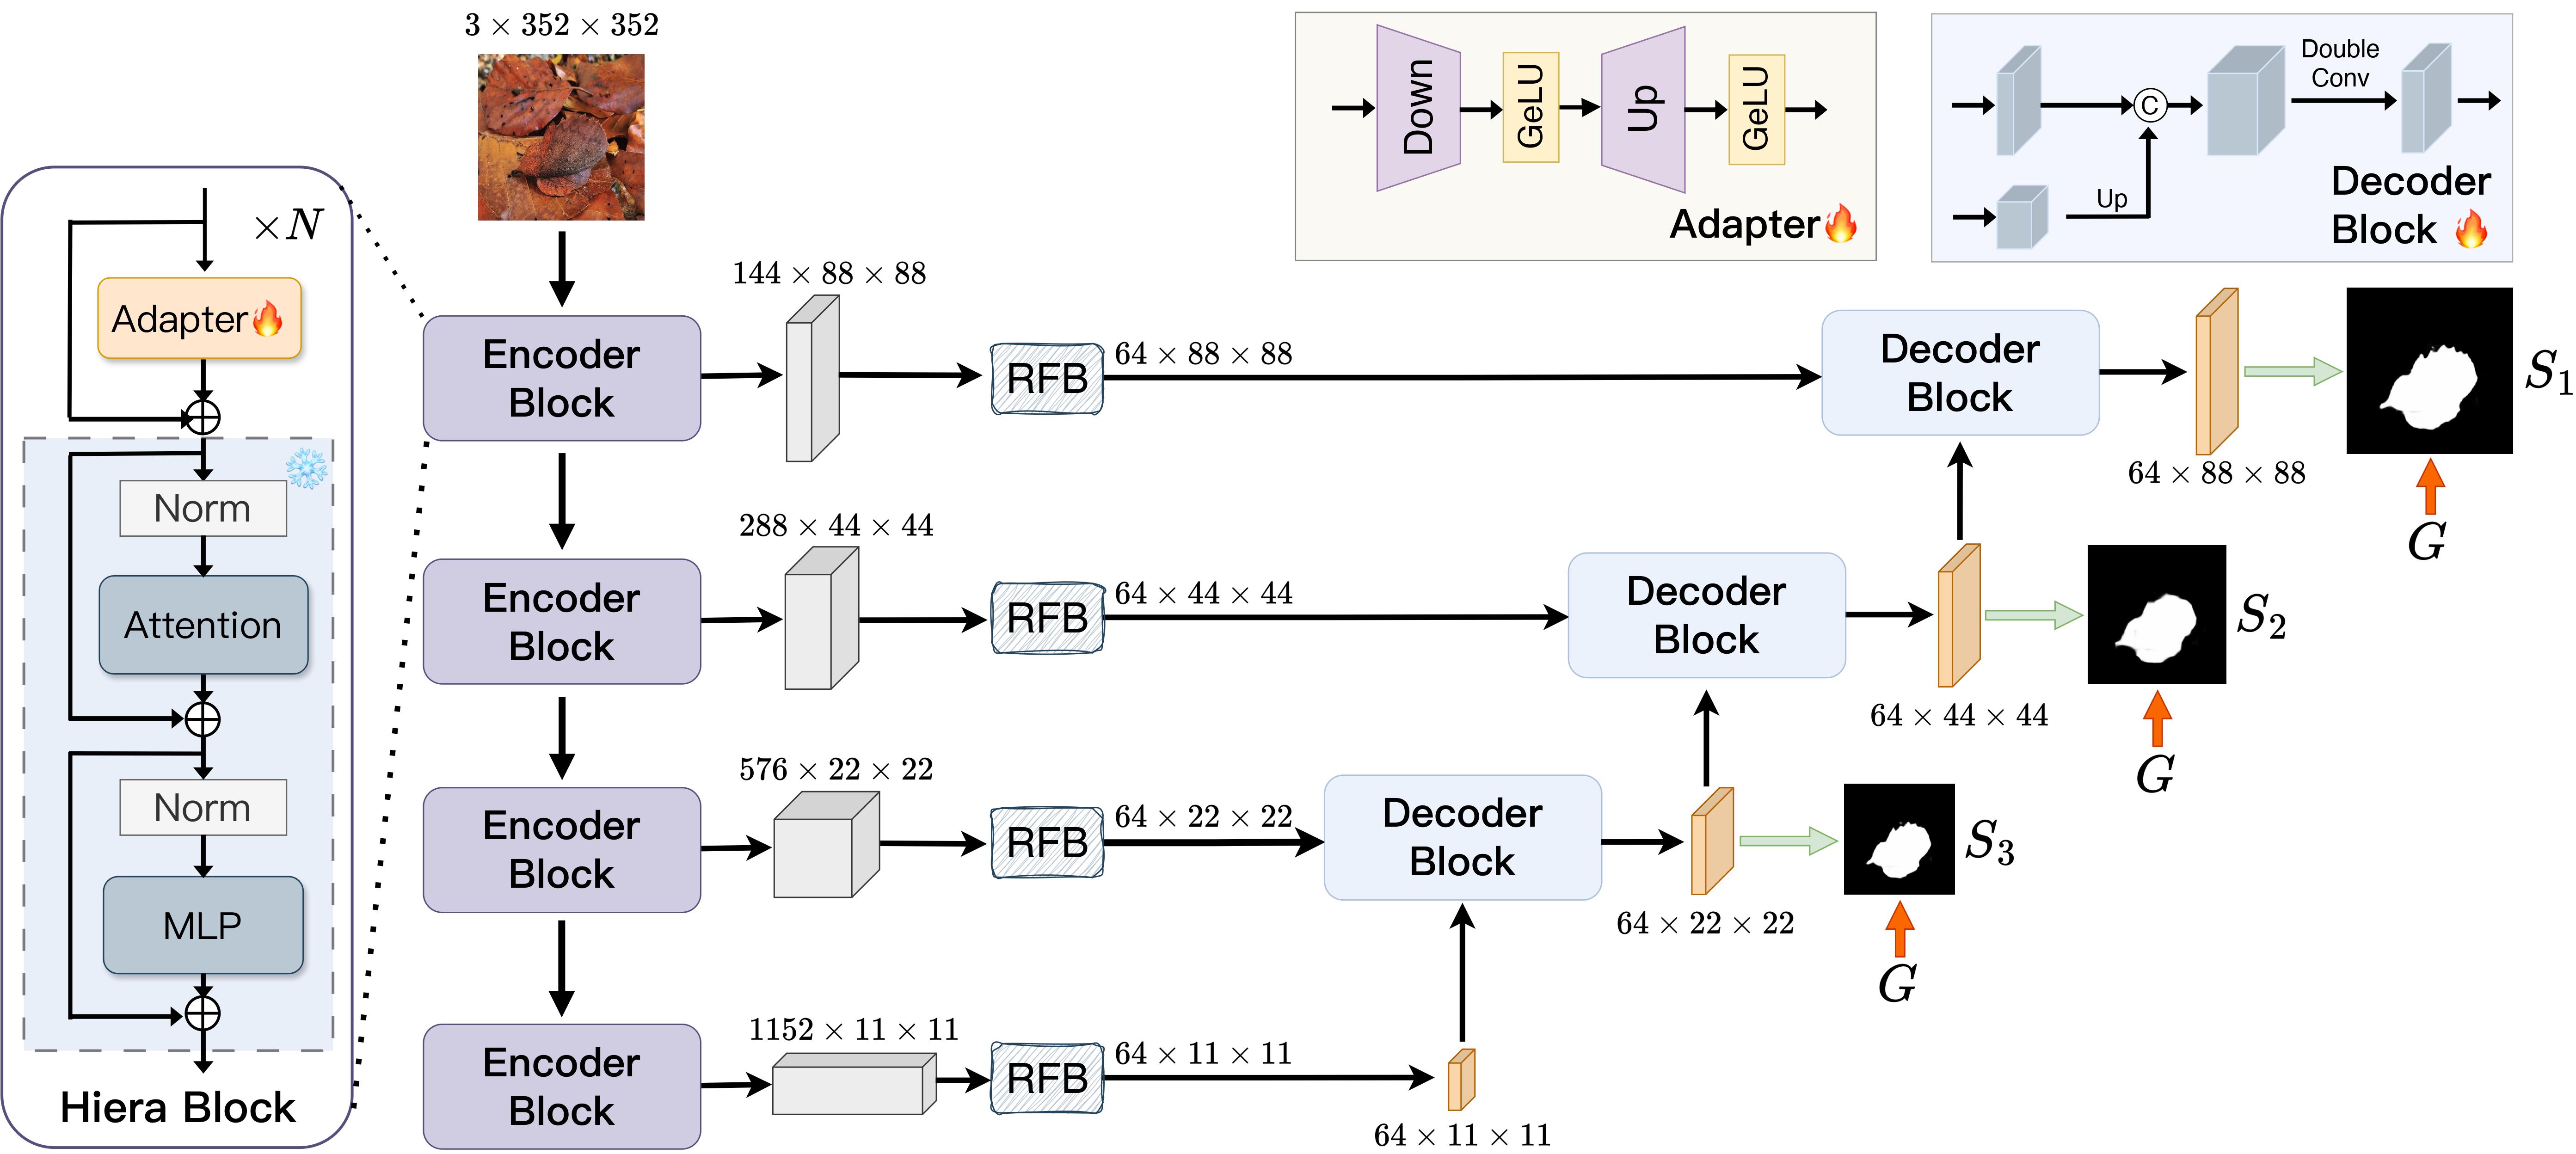
把 Segment Anything 2 当作强编码器接上 U-Net 解码器,做自然图像和医学图像分割,覆盖伪装目标、息肉、海洋动物等场景。
QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。
基于 LangGraph 的电商数仓智能问数 Agent,把自然语言转成 SQL 并流式展示查询结果,配套教程适合系统学习大模型应用落地。
用 Python 抓取 YouTube 频道、播放列表和搜索结果,绕开官方 API 限制获取视频数据。
把一句想法扩写成可直接投喂 Sora、可灵、Veo、Seedance 的电影级视频提示词,内置 21 种类型模板和五段式结构,省去反复调 prompt 的功夫。
一款 ONNX 模型优化工具,通过精简计算图和冗余节点来减小模型体积、提升推理速度,适合部署前做模型瘦身。
面向多轮视觉语言模型智能体的世界模型强化学习框架,让 VLM Agent 在交互中通过 RL 训练提升多轮决策能力。

给 AI Agent 加上屏幕录制与记忆检索能力,让它能回看你的历史操作并真正记住个人上下文,从而做出更贴合你的回应。
面向 LLM 应用的数据驱动评估框架,提供多种指标,重点覆盖 RAG 与信息检索场景,帮助在开发中持续量化效果。