Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 37 / 43 页无需训练即可从视频中恢复人体网格模型,结合 SAM-3、Diffusion-VAS 和 SAM-3D-Body 实现 4D 人体重建,适合快速做视频人体建模。
面向 OCR 流程的文档版面分析工具,能自动切分页面区域、检测文本行并做二值化,为后续文字识别和 RAG 检索提供干净的结构化输入。
一款颜值高、开箱即用的终端文件管理器,基于 Python 和 Textual 构建,支持 Linux、macOS 和 Windows,让你在命令行里也能高效浏览和管理文件。
用一次性智能体集群执行网页自动化操作,用完即弃,避免行为被追踪归因,适合隐私敏感的抓取与浏览任务。

HUGS 用高斯泼溅从单目视频重建可动画的人体三维模型,能同时还原人体和场景,方便做数字人渲染。
OSWorld 2.0 是一个评测基准,专门衡量计算机操作智能体在长周期真实任务中的表现,帮研究者检验模型能否连续完成多步桌面操作。
一个能自我进化的照片编辑智能体,通过编辑器和评估器协同优化,让多模态大模型学会像修图师一样自动调色和修图。
让视觉语言模型在推理时生成连续视觉 token 作为中间思考步骤,提升看图与推理表现,附带 ECCV 2026 论文官方实现。
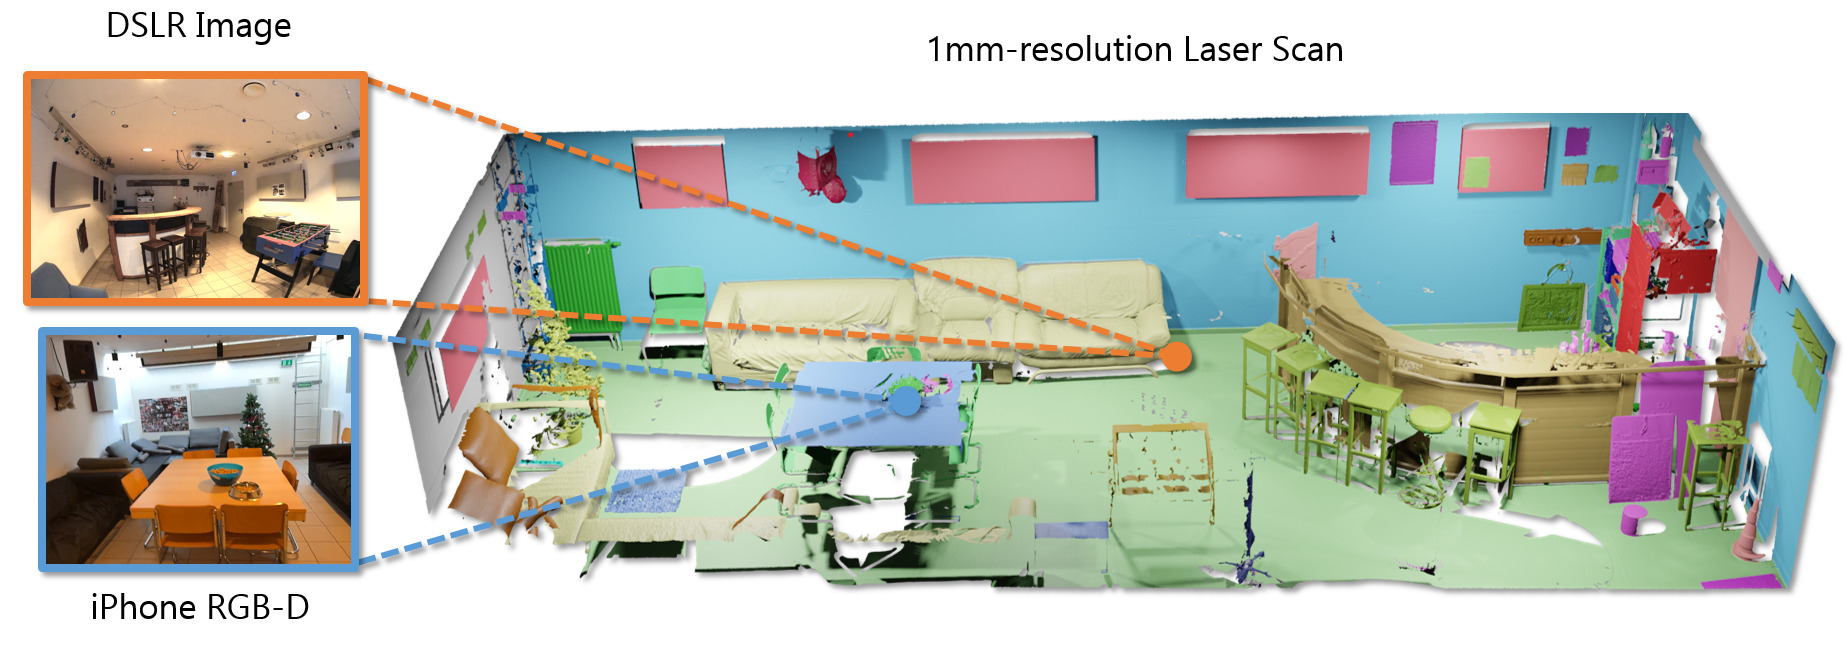
ScanNet++ 是一个高保真 3D 室内场景数据集,提供配套工具,支撑三维重建、语义与实例分割、新视角合成等研究。
为 Hugging Face diffusers 提供注意力图提取与可视化工具,方便查看 Stable Diffusion 文生图时文本如何影响图像区域。
MagicBrush 是 NeurIPS'23 发布的人工标注指令引导图像编辑数据集,为训练和评测文本指令驱动的图像编辑模型提供高质量数据。
Stable Flow 是 CVPR 2025 论文的官方实现,利用扩散模型中的关键层实现免训练的图像编辑,无需微调即可对生成图做可控修改。
用多个大模型做行情分析、Python 确定性代码做风控、对接 OKX 执行的自主加密货币量化交易系统,让 LLM 决策有硬性风控兜底。

给 Minecraft 智能体提供开放世界技能的开源方案,通过微调大语言模型让智能体在游戏中自主完成多样化任务。
从 YouTube 直播频道抓取 m3u 播放列表,方便导入 IPTV 播放器观看直播。
在 NVIDIA GPU 上为 StartLux-Decision 模型提供快速精确推理,支持 int8 和 4-bit 量化的 GGUF 权重,延迟比 vLLM FP8 低至 5.3 倍且答案逐位一致。
统一训练、微调和评测世界动作模型(WAM)的框架,面向具身智能与机器人研究,支持 LoRA 微调并内置基准测试。

压缩 3D 高斯泼溅模型,减少存储占用并加速新视角合成渲染,适合在资源受限设备上部署 3DGS 场景。
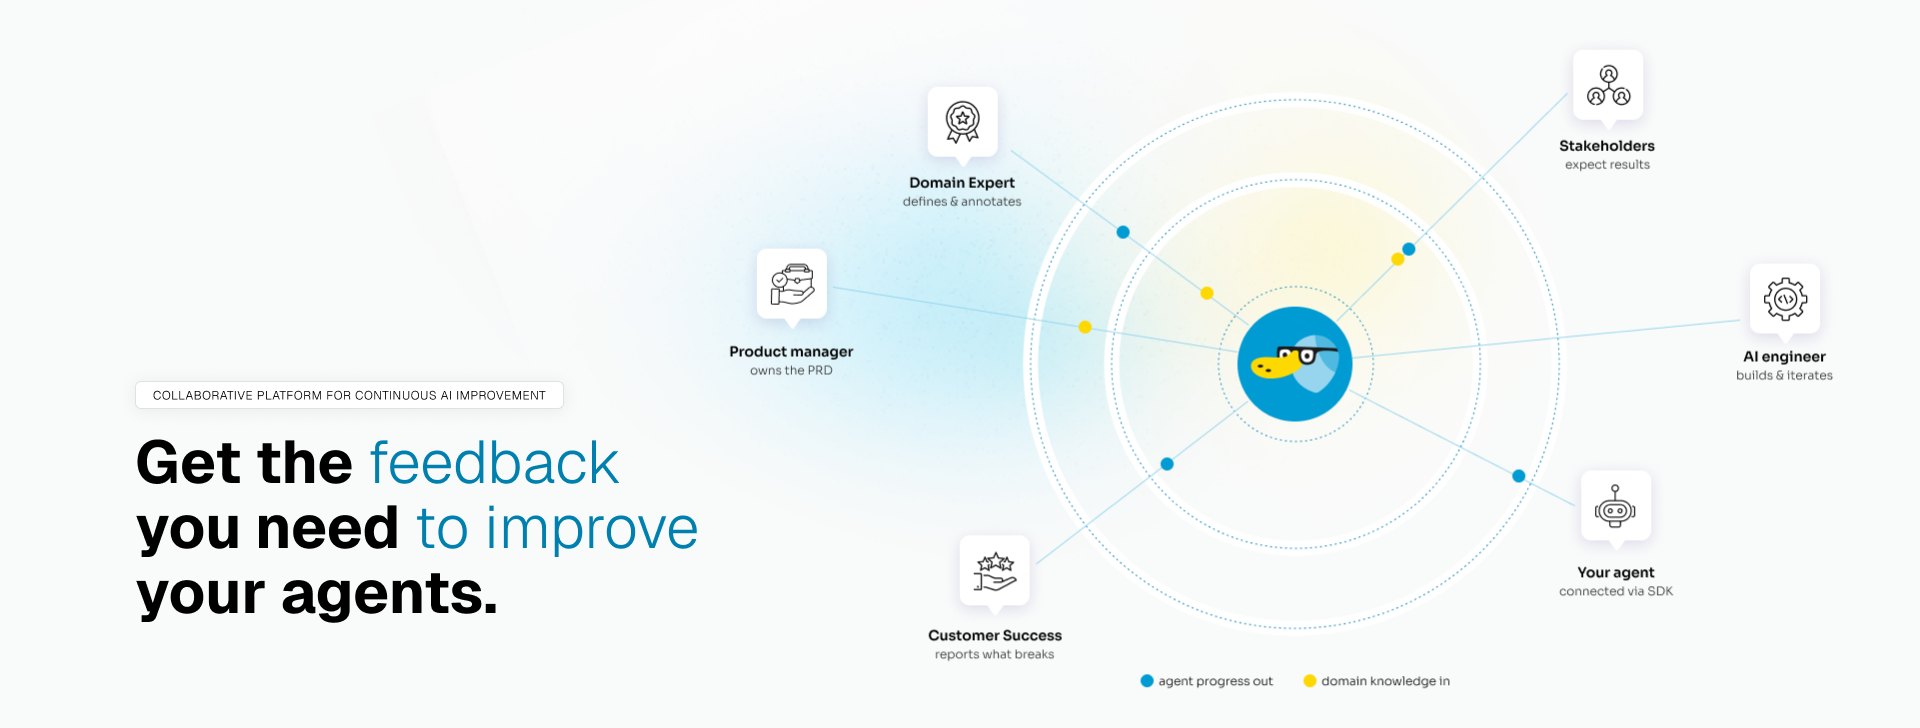
面向 AI Agent 开发团队的协作平台,支持测试、模拟和追踪 Agent 运行,让领域专家标注行为、工程师据此迭代改进。

把视频流转化为整体 3D 空间智能的 ICML 2026 Oral 工作,配套基准用于评测视觉语言模型的空间理解能力。
VideoPrism 是 DeepMind 开源的视频理解基础视觉编码器,用自监督学习预训练,可直接抽取视频特征,支撑分类、检索、问答等下游任务。
自托管的 AI 代码审查工具,能对 PR 做索引化审查、生成变更讲解、扫描漏洞、绘制依赖图,还支持自定义规则和从反馈中持续学习。
带标签、评分和 LLM 摘要的自托管 RSS 新闻阅读器,帮你从海量订阅里筛出真正值得读的内容。
基于 Python 的 Git 工作流工具,一次提交即可生成多个相互关联的 PR,并支持补丁版本追踪和 rebase 检测,让代码评审更高效。
用 torchao 和 diffusers 优化扩散模型的端到端教程,覆盖推理加速和 FP8 训练,帮你在 Flux 等文生图模型上省显存、提速度。
一份 DevOps/SRE 工程师从零基础到架构师的完整学习路线图,覆盖 Linux、Docker、K8s、CI/CD、Prometheus 与云原生,中英双语并汇集 500+ 学习资源。
Stream-Omni 是一个类 GPT-4o 的多模态对话模型,支持文本、图像、语音任意组合的实时交互,可用于语音问答和多模态聊天场景。
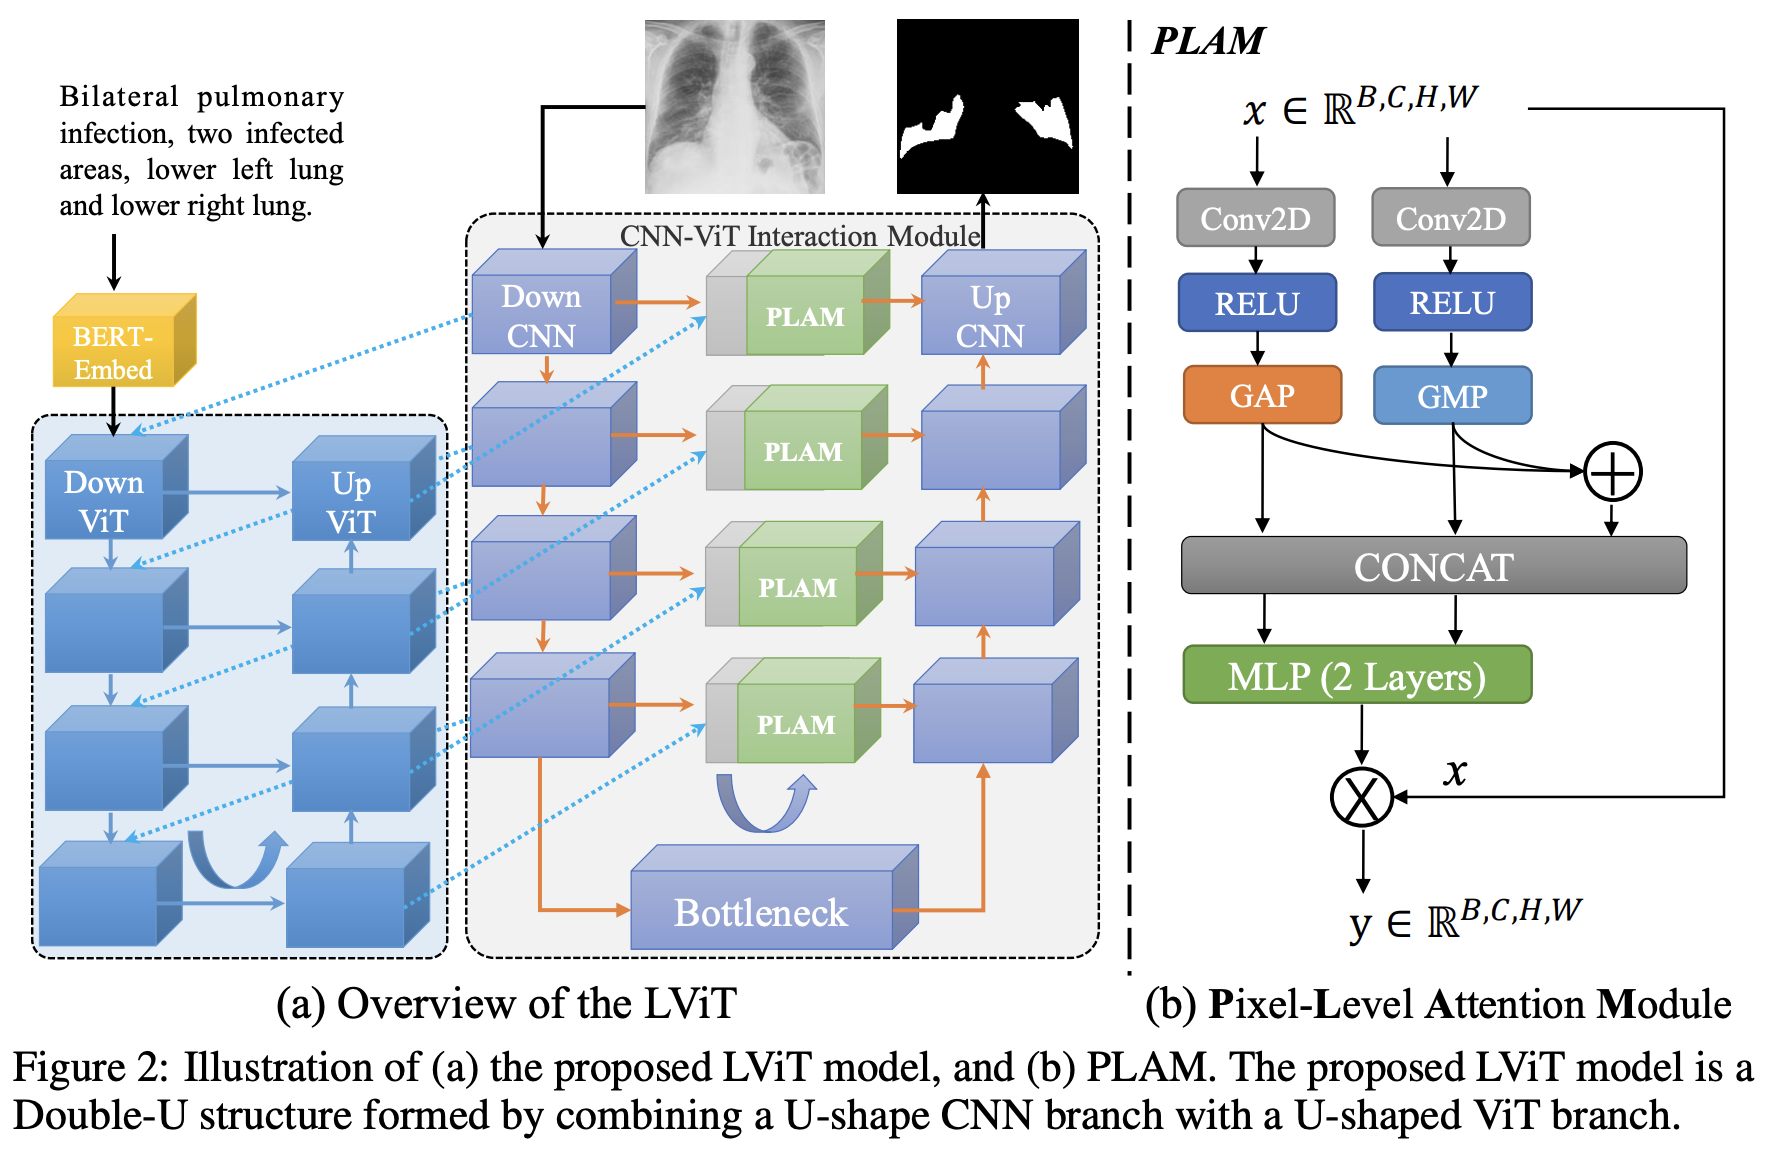
LViT 把文本描述引入视觉 Transformer,做医学图像分割,用语言信息弥补标注数据不足,提升分割精度。
把 SAM 的分割能力扩展到任意分割任务的多模态大模型,支持文本指令驱动的通用图像分割。
给 AI Agent 加一层行为管控,拦截它自作主张的操作,支持人工介入和审计留痕,防止越权执行你没要求的动作。
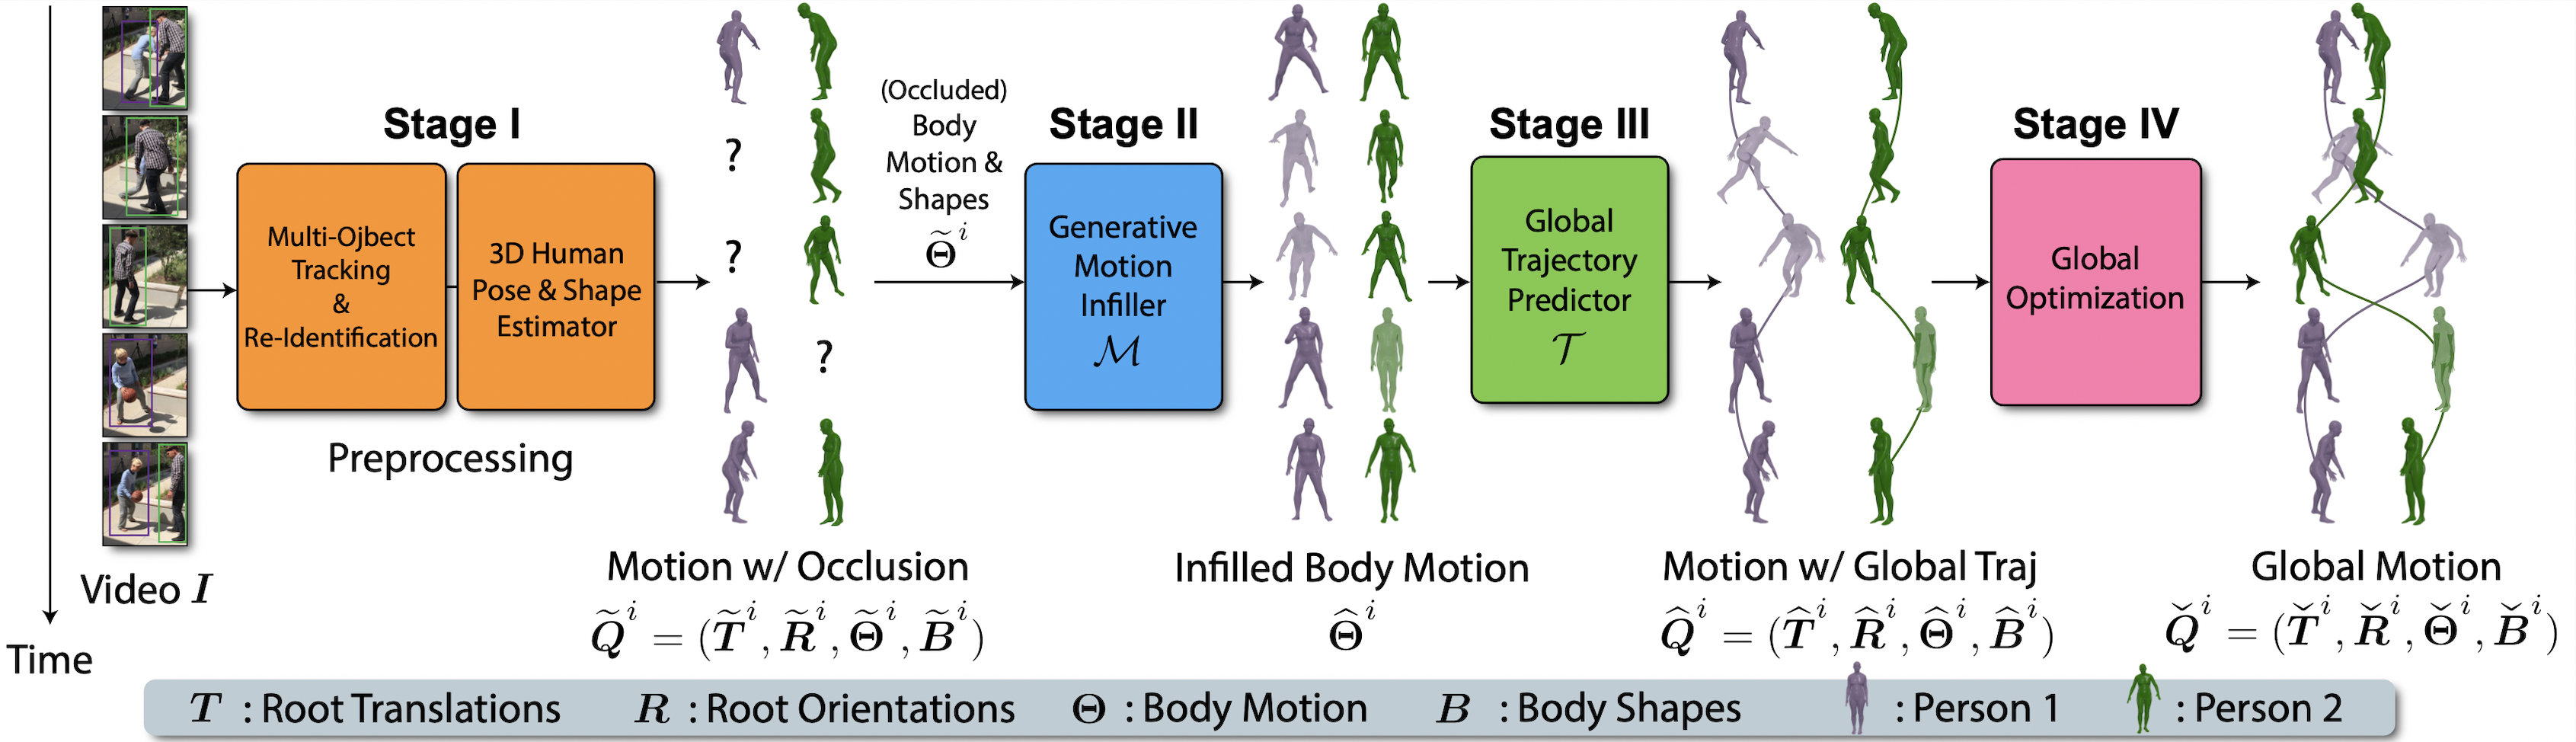
从动态相机拍摄的视频中恢复人体网格,能处理遮挡和全局轨迹,适合做人体动作捕捉与三维重建研究。
从多视角图像生成三维网格模型,通过形变网络逐步细化网格顶点,解决单视图重建细节不足的问题。

把 LLM 应用从原型推进到生产环境的框架,集成了 LangChain、MLflow、OpenAI 和 Vertex AI,方便管理提示词与模型部署。
把 Stable Diffusion 等扩散模型用 BentoML 打包成可部署的推理服务,支持 LoRA 微调权重和 Kubernetes 部署,省去自己搭服务框架的麻烦。
Neural network model repository for highly sparse and sparse-quantized models with matching sparsification recipes
把视觉能力做成 LoRA 插件直接挂到语言模型上,无需额外视觉编码器就能做多模态理解,省显存也省部署成本。
RISE 用组合式世界模型让机器人策略自我进化,通过生成模型与价值学习提升操作任务表现,适合研究机器人学习与 VLA 的团队。

用 SfM 引导的单目深度估计做多视角三维重建,把稀疏重建的相机位姿和单目深度先验结合起来,提升复杂场景下的重建精度。
给 AI 编程助手加一层本地长期记忆,自动捕获对话并自动召回,全部存在单个 SQLite 文件里,不依赖云端,兼容 Claude Code、Cursor 等 CLI 工具。

基于 3D 高斯泼溅的高动态范围新视角合成方法,用高斯表示重建 HDR 场景,比 NeRF 类方案快约 1000 倍。
把训练好的 sklearn、XGBoost 等 ML 模型直接暴露成 LLM Agent 可调用的工具,省去自己写胶水代码,让 Agent 能调用传统模型做预测。
通过部署恶意流水线,从 Azure DevOps、GitHub、GitLab 的 CI/CD 环境中提取密钥,用于红队评估流水线配置的泄露风险。

面向基础模型训练的多模态数据流水线,把数据清洗、筛选和质量评估串成可扩展流程,解决大规模图文数据难治理的问题。

OmniVGGT 是 CVPR 2026 提出的多模态视觉几何 Transformer,把图像、深度、点云等不同模态统一进一个空间基础模型,用来做 3D 重建和几何理解。
用单张图片自监督重建三维场景,基于神经辐射场实现新视角合成与深度估计,无需三维标注数据。
轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。
用生成模型合成带标注的肝脏肿瘤 CT 图像,无需人工标注即可训练分割模型,缓解医学影像标注成本高的问题。
命令行驱动 Google Flow 批量生成 Veo 视频和 Imagen 图片,支持脚本化流水线,并内置 MCP 服务器让编码智能体也能直接调用。