Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 36 / 43 页Auditable code review skill for Claude Code and Codex: four independent probes, evidence-backed findings, and a JSON-derived merge gate.
用 LLM 做 GitHub 代码审查的 CLI 工具,只报高置信度的安全漏洞、Bug 和可维护性问题,减少噪音干扰。
基于 Keras 的神经符号语言模型框架,把 LM 与符号推理、强化学习结合,支持上下文学习和测试时自适应。
面向长视频理解的可插拔检索增强框架,无需训练即可为多模态大模型补充视觉对齐的检索证据,提升长视频问答效果。
把 Claude Code 变成 7×24 小时常驻的浏览器自动化代理,通过 Browser Use Cloud 和 Telegram 远程操控真实浏览器,跑在你自己的机器上。
VisionZip 是 CVPR 2025 提出的视觉语言模型加速方案,通过压缩视觉 token 减少冗余计算,在保持多模态任务精度的同时显著提升推理效率。

基于 PyQt5 的图形界面工具,用 YOLO 系列模型做目标检测、跟踪、实例分割和人体姿态估计,支持图片、视频和摄像头输入。
用 OpenAI 的 CLIP 引导扩散模型,把文字描述直接生成图片,提供命令行工具和 Python 模块两种用法。
Pinecone 向量数据库的官方 Python SDK,方便在 Python 项目里直接接入向量存储和相似度检索,搭建 RAG 应用时不用自己封装 API。
统一多模态模型,把图文理解、文生图和图像编辑整合进同一套框架,省去为不同任务分别部署模型的麻烦。

基于证据的开源仓库审计命令行工具,内置确定性扫描器、MCP 服务器和实时看板,还能通过 GitHub Action 在 PR 里直接贴出差异结果。
OpenRCA 是 ICLR'25 提出的基准,用来评测大语言模型和 LLM Agent 能否在软件故障中定位根因,为根因分析能力提供统一测试标准。
在 Mac 上用 MLX 本地跑视觉和文本嵌入模型的 Python 包,方便给 RAG 和检索应用生成向量,不用依赖云端 API。
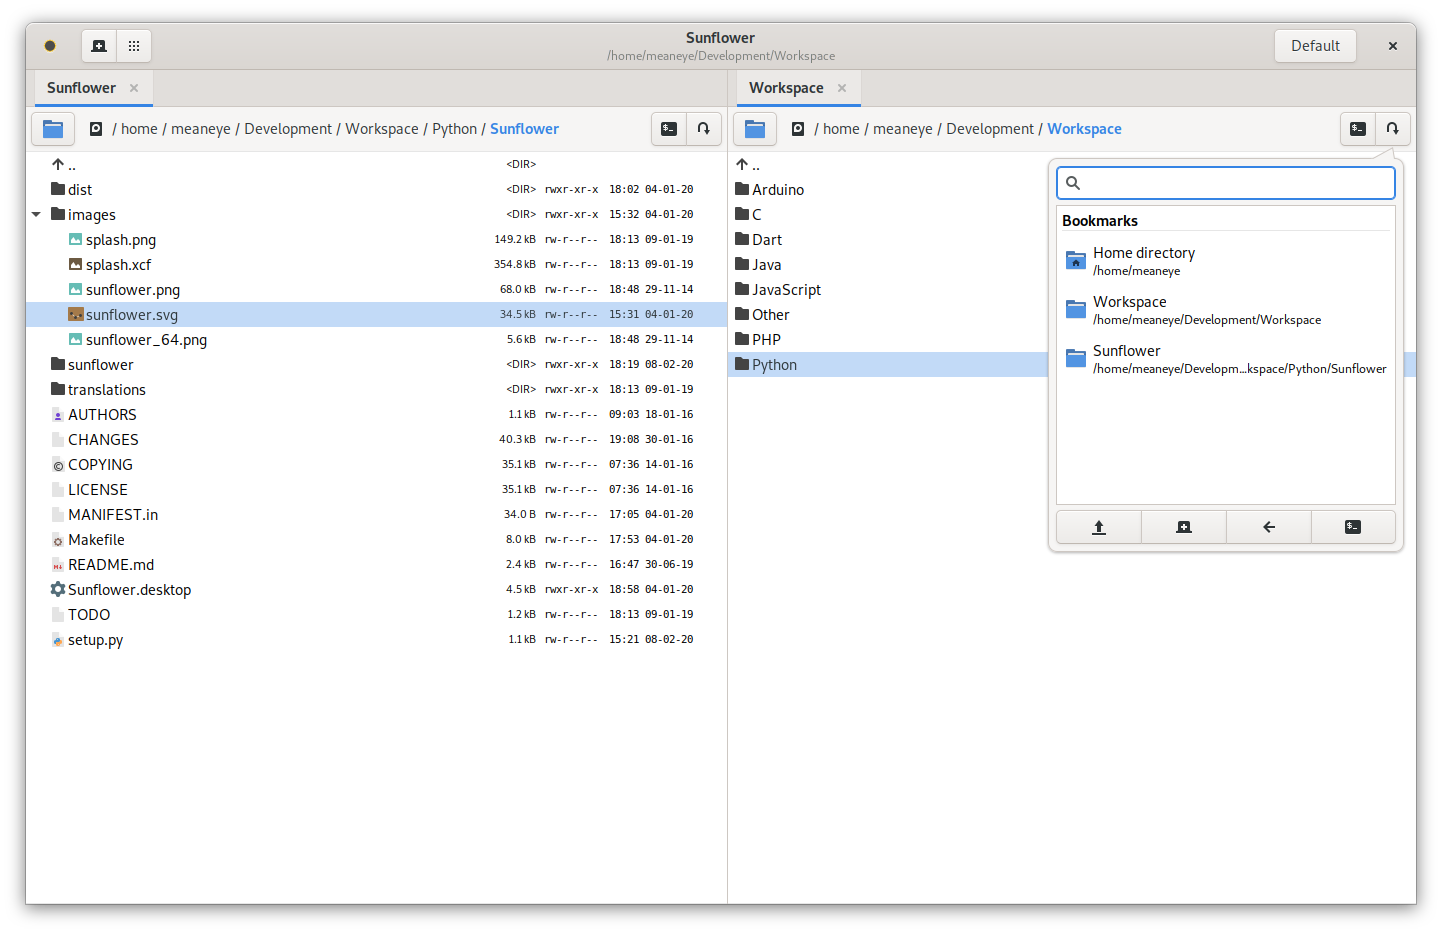
Linux 上的轻量双面板文件管理器,界面高度可定制,支持插件扩展,适合习惯 Norton Commander 式操作的用户。
面向边缘受限硬件的神经网络压缩工具包,提供量化感知训练和训练后量化等高级量化压缩能力,帮研究者把模型高效部署到资源紧张的设备上。
面向嵌入式设备的开源 AI 模型训练与部署工具,支持在 ESP32、Jetson、树莓派等硬件上完成图像分类、目标检测等任务的训练与推理。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。
跨平台计算机视觉标注工具,集成 Grounding DINO 与 SAM 实现自动预标注,支持目标检测和旋转框标注,大幅减少手工画框工作量。
用统一接口调用 Anthropic、Cohere 等多家大模型,省去分别对接各家 API 的麻烦,适合快速搭建 LLM 应用。

自托管的 AI 网关与推理防火墙,为 Agent 提供身份与访问管理,拦截提示注入并审计调用,防止 LLM 被滥用。

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。
免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。
基于 9262 例 CT 体积和 25 个标注类别预训练的 3D 医学影像模型,可直接用于腹部器官分割等下游任务,省去从零训练。
基于 OpenPifPaf 人体姿态估计模型做跌倒检测,结合目标跟踪分析视频中的人体关键点,判断是否发生摔倒,可在 CPU 或 GPU 上运行。
面向 Redis 的 AI 原生 Python 客户端,把向量检索、缓存和 RAG 所需的数据操作封装成简单接口,省去自己拼装底层命令。
把 SAM、MobileSAM、EfficientSAM、SAM 2/2.1 和 SAM 3 导出成 ONNX 模型,方便在任意平台跑可移植的图像分割,不用绑死原始框架。
QGIS 插件,用 Segment Anything Model 在地理栅格影像上快速分割和勾绘地貌,省去手工描边的麻烦。
用大模型自动给科研论文打标注,结合向量检索定位相关内容,省去人工逐篇阅读和整理文献的功夫。
基于 Real-ESRGAN 的图片与视频 AI 超分工具,带图形界面,支持 N 卡、A 卡和 Intel GPU,可降噪并去除压缩伪影。
把生成模型里隐含的 3D 先验知识迁移到场景理解任务上,让视觉语言模型在空间推理时更懂三维结构。
面向超长视频理解的深度研究式问答智能体,能自动拆解问题、检索视频片段并给出答案,省去人工逐帧翻看的麻烦。
把多模态大模型变成能调度各类计算机视觉任务的通用路由器,用指令调优统一处理检测、分割等任务,免去为每个任务单独建模。
系统梳理大模型推理中 KV Cache 优化的综述仓库,按系统与架构视角归纳显存占用和吞吐瓶颈的各类优化方法,适合做推理加速选型时查阅。
轻量级卡尔曼滤波 Python 库,用于视觉定位、里程计和 SLAM 中的状态估计与传感器数据融合。
基于零样本分割模型实现任意图像抠图,无需针对特定类别训练即可提取前景透明通道,适合快速落地通用抠图需求。
在任意操作系统上构建、签名并发布 iOS 应用,无需 Mac 和 Xcode,还能由 AI agent 驱动完成整个流程。
单张图片一次前向即可重建画面中多人的 SMPL-X 三维人体网格与姿态,提供 PyTorch 推理代码和预训练模型,适合做多人姿态估计与人体重建的落地验证。
给 Claude Code 和 Codex 用的可审计代码审查技能,通过四个独立探针交叉检查,每条结论都有证据支撑,并用 JSON 结果做合并门禁。
用 Markdown 文件搭建个人 Wiki,支持知识图谱、LaTeX 公式和 Pandoc 转换,可 Docker 部署,适合替代 Obsidian 做自托管文档库。
基于属性解耦表示学习实现通用 SDR 到 HDR 视频转换,来自 AAAI-26 oral 论文,可把普通视频提升为高动态范围画面。
用 Python 编写推理引擎的实验性库,面向 LLM 服务场景,支持 CUDA/GPU 加速,方便快速搭建和试验自己的推理后端。
面向 ASIC、FPGA 和 NPU 的加速器设计与编程框架,用 Python DSL 描述硬件,再经编译器生成高性能硬件实现。
整理 Azure OpenAI 与大模型(含 RAG、Agent)的学习资源和实践笔记,按月更新,适合想系统上手云上 LLM 应用开发的人查阅。
无需人工标注标准答案就能评估 RAG 系统,通过自动生成问题和判断相关性来量化检索与生成质量。
用大模型做主题建模的提示词框架,自动从文本语料中生成可读的主题描述并分配文档标签,替代传统 LDA 类方法。
一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。
端到端 SLAM 系统,把相机标定、单目先验和 3D 高斯泼溅稠密渲染串成一条流水线,让单目视觉同时完成跟踪与高质量三维重建。
RecA 用自监督学习让多模态模型在生成图像时借助自身的视觉理解能力,提升文生图和图像编辑的效果,可接入 ComfyUI 使用。