Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 40 / 43 页
用大语言模型当超启发式,通过反思式进化自动生成和迭代优化组合优化算法,省去人工设计启发式的功夫。
管理 LLM Agent 技能全生命周期的治理工具,覆盖技能收集、推荐到演化,帮团队把 Agent 技能库管得更有条理。
给 LLM Agent 即插即用的长期记忆模块,让智能体跨会话记住历史信息,不用自己搭记忆系统。
在单张消费级显卡上跑 PPO、GRPO 和同策略蒸馏的轻量 RL 训练框架,让普通玩家也能做 LLM 对齐后训练。
基于 openhop_core 的轻量级 LoRa 中继守护进程,用 Python 实现,跑在 SX1262 硬件上,帮 MeshCore 网络扩展信号覆盖范围。
把本地 OpenAI 兼容服务(llama.cpp、vLLM、Ollama 等)接入 Home Assistant,让智能家居助手用上自托管大模型做对话。
用 FP8/INT8 低精度做强化学习训练的 rollout 推理,在 vLLM 上跑出更快采样速度且不掉点,适合想压低 RL 训练推理成本的大模型团队。
一行代码把任意模型部署成兼容 OpenAI/Anthropic/Ollama 的 API,自带聊天界面和原生 MCP 支持,省去自建推理服务的胶水代码。
用 Rofi 菜单快速检索 Bitwarden 密码库,选中后自动复制密码或 TOTP 验证码,省去打开浏览器插件的步骤。
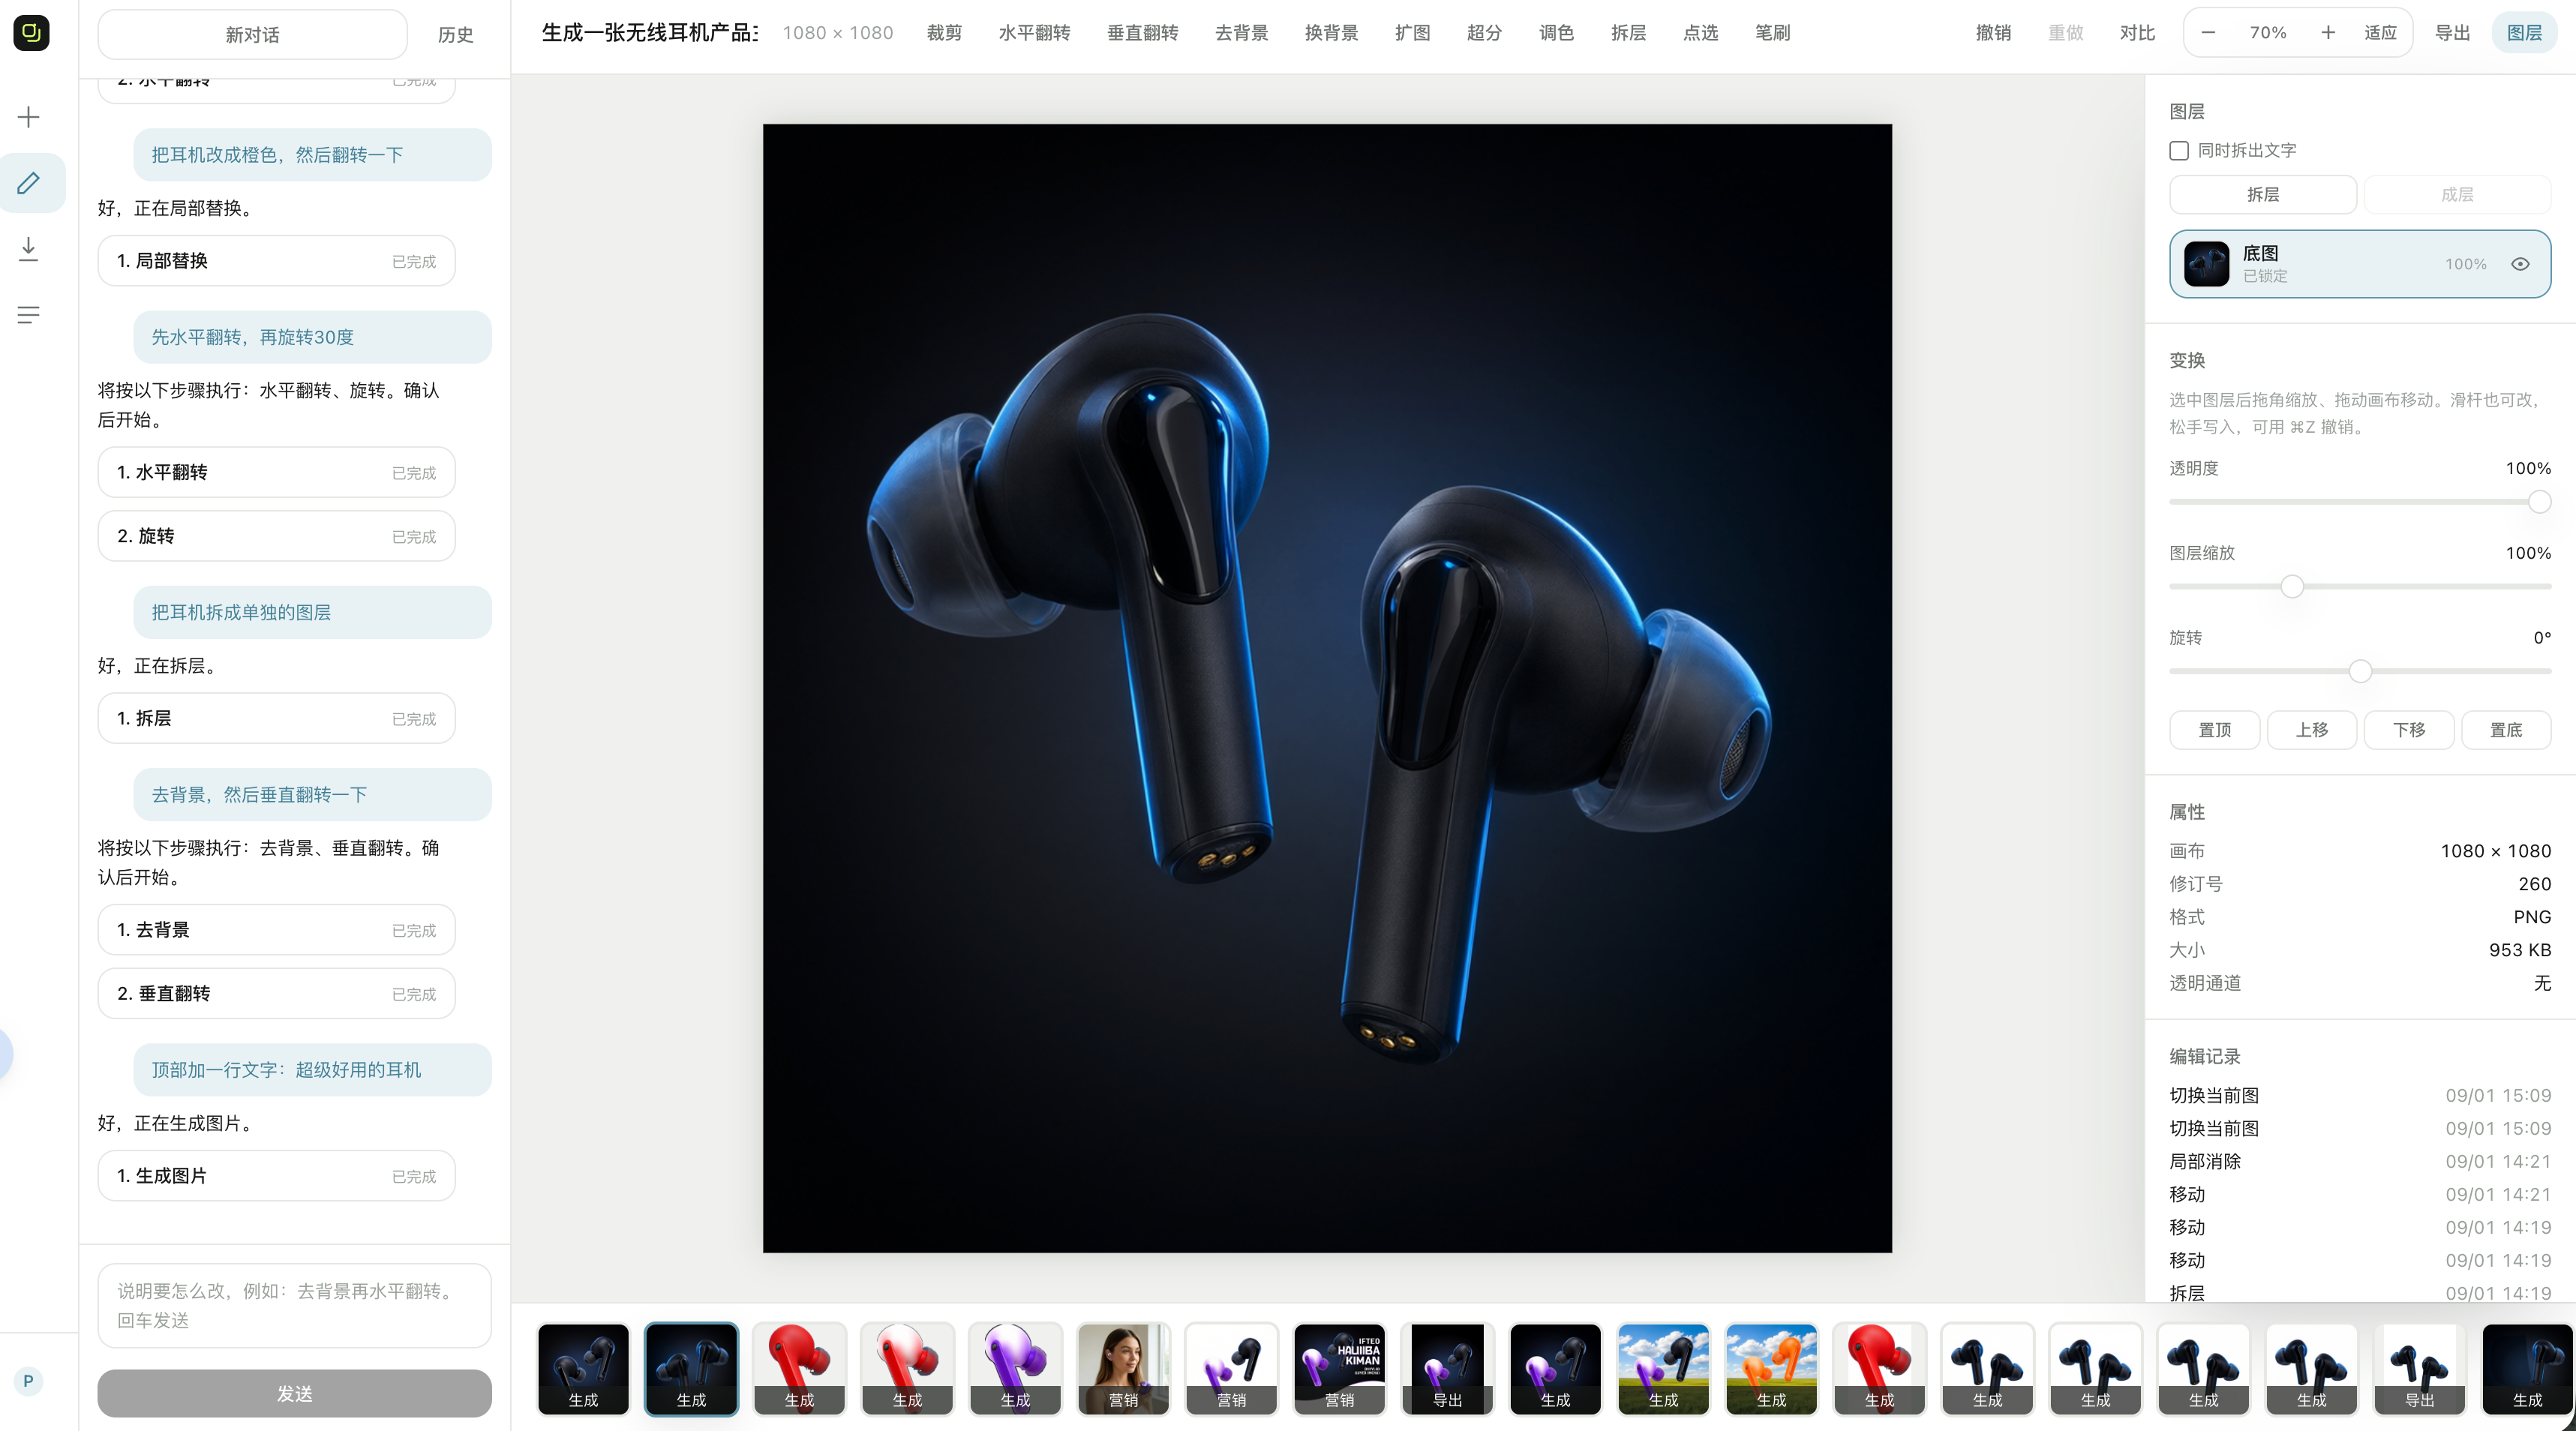
基于 React 19 + FastAPI + LangChain/LangGraph 的 AI 修图智能体,用自然语言驱动 21 种编辑工具完成抠图、图层拆分、区域编辑和文生图,配套教程带你一周掌握 AI Agent 全栈开发。
让视觉语言模型在推理时生成隐式视觉 token 做「脑内想象」,无需输出真实图像就能增强多模态空间推理能力。
面向物理 AI 的命令行工具,把 VLA、VLM、WAM 等机器人多模态模型串起来,方便在 NVIDIA、Nebius 环境里做模型部署和对话机器人调试。
把前沿 Transformer 模型接入机器人技术栈的 Python 库,支持多模态与扩散模型,帮具身智能开发者快速搭建可感知、可决策的智能体。
用 Python 给 LLM 生成的回答跑评测的 SDK,内置多种评测指标,方便在 LLMOps 流程里量化模型输出质量。
SPARF 是 CVPR 2023 的官方实现,用稀疏且带噪声的相机位姿训练神经辐射场,同时优化位姿,实现新视角合成。
基于 FLUX 的身份保持图像生成 ComfyUI 原生节点,可在换脸、图像编辑时稳定保留人物面部特征。
面向强化学习实验的 GPU 调度与训练编排系统,让多个 RL 实验共享 GPU 资源、减少排队等待,支持 LoRA 微调与 LLM 训练。
NoneCap 的官方 Python 客户端,调用 API 自动破解 hCaptcha 验证码,省去手动对接接口的麻烦。
面向空间组学的技术无关分析流水线,能处理 Xenium、Visium HD、MERSCOPE 等多种平台数据,扩展到百万级细胞规模。
YooMoney(原 Yandex.Money)支付 API 的 Python 客户端,同时支持同步和异步调用,用 Pydantic 模型保证类型安全,方便在 Python 项目里接入俄罗斯钱包支付。
从文本、图像或 3D 条件生成 3D 内容的扩散模型,通过检索增强引入参考模型,提升生成质量与可控性。
用 Python 计算多边形中心线的工具,基于 Voronoi 图把面状地物(如河流、道路)提取成线状结构,支持 shapefile 等空间数据,也可命令行调用。
轻量级结构感知视觉 Mamba 模型,专门做建筑结构裂缝分割,在保持低计算量的同时提升裂缝边缘和细长结构的识别精度。
对本地大模型服务做并发压力测试,自动跑多轮请求并生成性能报告,方便对比 Ollama、vLLM 等推理后端的吞吐和延迟表现。

把 NeRF 表示成输入点云的三角剖分,用光线追踪做三维重建,训练和渲染更快,适合从点云直接生成高质量新视角。
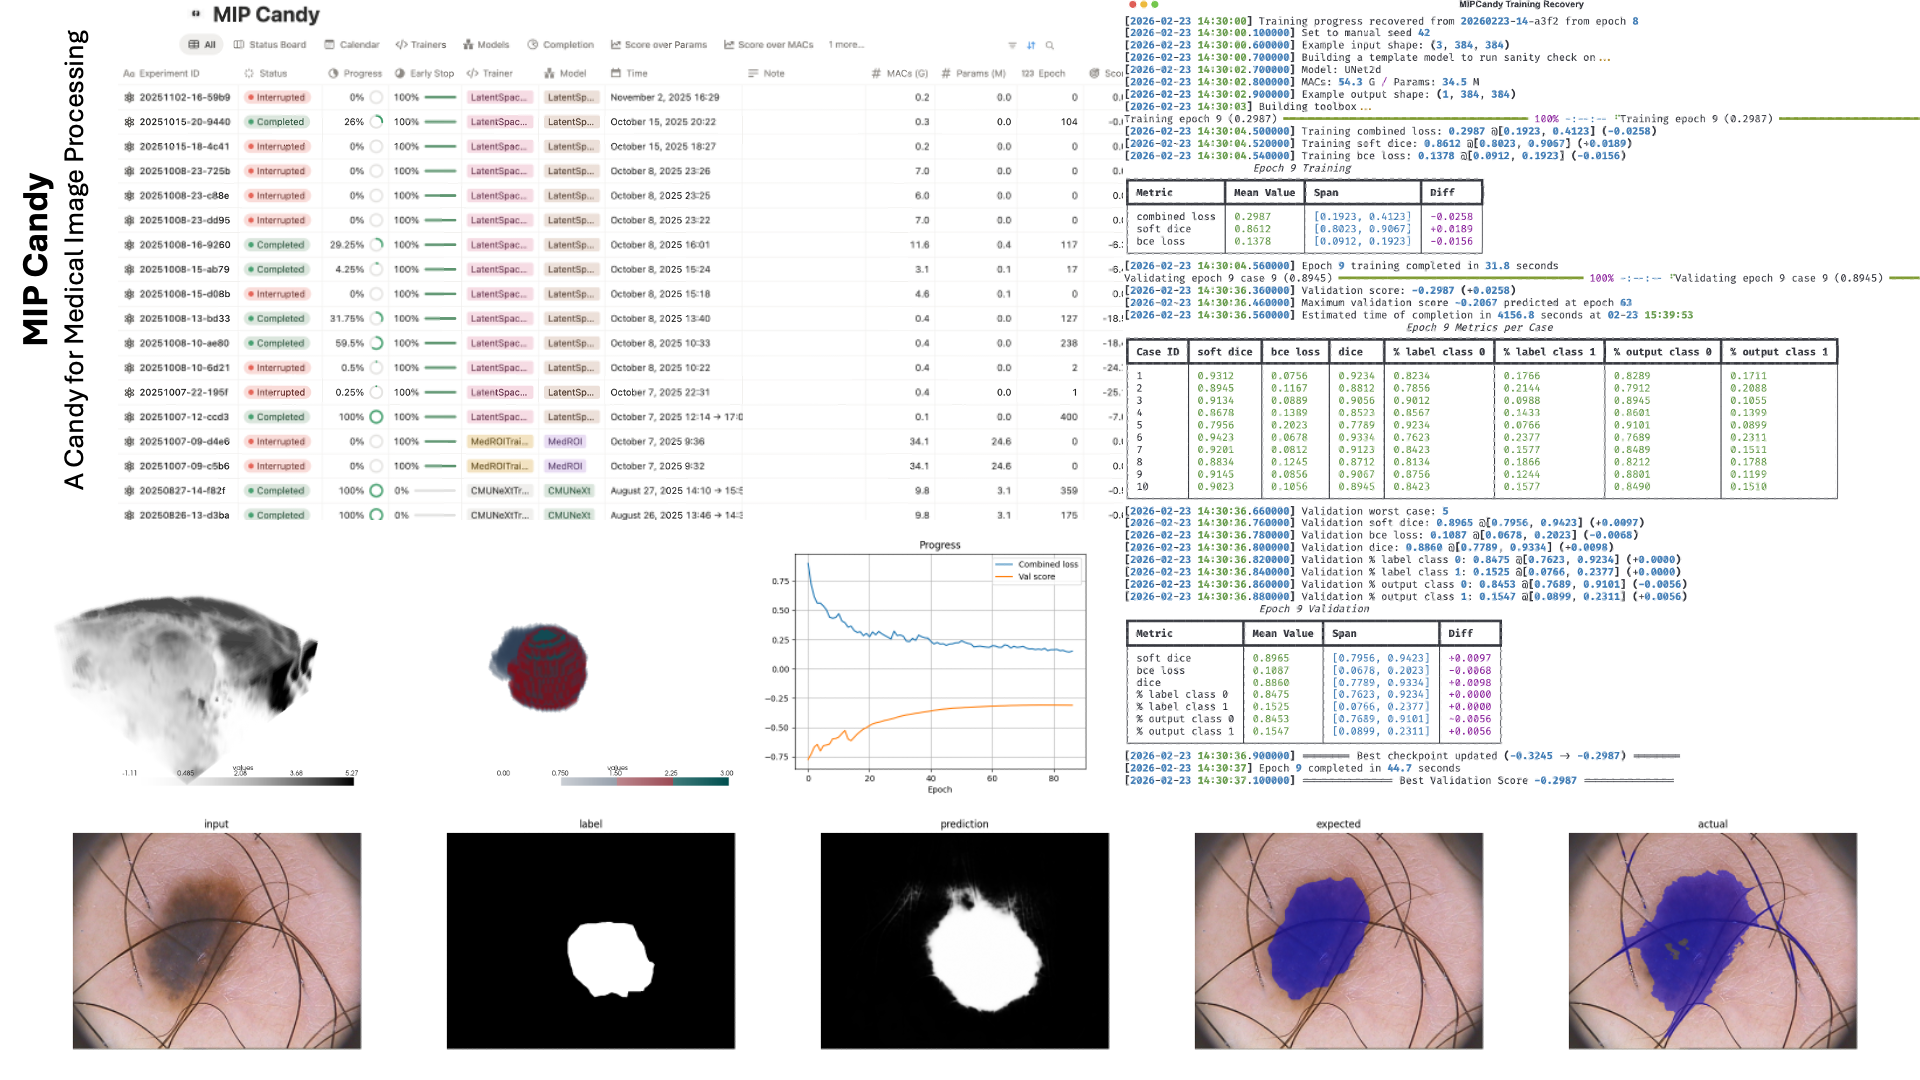
十秒内为 PyTorch 医学影像模型搭好完整实验流水线,覆盖分类、检测、分割等任务,省去重复搭建训练流程的麻烦。
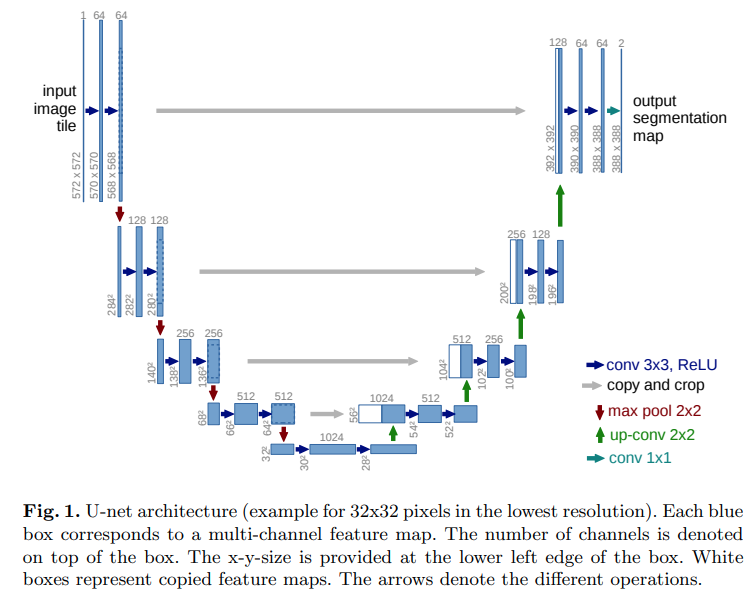
实现带高效注意力的 U-Net,并融合最新研究改进,适合图像生成和分割任务的训练与微调。
一套完全开源的强文本到图像扩散模型训练配方,提供 JAX 和 PyTorch 实现,方便复现和二次开发。
提供 ChatGPT(GPT-3.5) 和 GPT-4 的真实工作负载 trace 数据集,用来评估和优化 LLM 推理服务系统的调度与资源分配。
无需训练就能把故事文本转成富有表现力的分镜图,基于扩散模型直接生成,省去微调成本。
用 NVIDIA Warp 和 Python 从零实现 3D 高斯泼溅,代码简洁,CPU/GPU 都能跑,适合边动手边学现代图形学。

聚合多个上游广告与恶意域名规则,统一合并后输出 mihomo MRS、sing-box SRS、Clash 等格式,省去手动维护多套规则集的麻烦。
面向 NVIDIA GPU 的深度学习推理调优工具包,帮助把训练好的模型调优并部署到 TensorRT、ONNX Runtime 等推理后端上跑得更快。
面向视觉-语言-动作模型(VLA)的可复现开源研究项目,聚焦目标跟踪类 VLA,提供训练与评测代码,方便复现和对比实验结果。
SparseVLM 是 ICML'25 与 TPAMI'26 论文的官方实现,通过稀疏化视觉 token 来降低视觉语言模型的计算开销,提升多模态推理效率。
全自动纯协议批量注册 ChatGPT 与 Grok 账号,支持 OAuth、邮箱接码、账号池和代理轮换,并对外提供 OpenAI/Anthropic 兼容 API 网关。

自动化调整大模型对齐行为的工具,支持直接干预、LoRA 和 MoE 专家级消融,并用 Optuna 多目标搜索调参。
一个通用图像生成框架,用上下文学习统一处理多种域内任务,并能泛化到未见过的任务,已合入 diffusers 官方流水线。
整理 IPTV 直播源和体育赛事频道,输出 m3u/m3u8 播放列表与 EPG 节目单,方便在播放器里直接导入观看。
用大语言模型做科学方程发现和符号回归的官方实现,把公式搜索交给 LLM 智能体,从数据里自动找出可解释的数学表达式。
面向流式视频场景的空间智能框架,用测试时训练让多模态大模型持续理解三维空间关系,解决长视频中空间推理能力退化的问题。

一站式 Web Agent 后训练框架,点几下就能搭建并评测基于大模型的网页智能体。
把提示词生成可编辑、可验证的 HTML/CSS 信息图,用图像生成器提供审美指导,通过解耦跨模态奖励的强化学习让代码更美观。
一份边缘机器学习资源清单,汇总了研究论文、推理引擎、竞赛、书籍和线下活动,方便快速找到在嵌入式与移动端部署模型的相关资料。
ViDoRe 是评估视觉文档检索的基准与评测代码,配套 ColPali 论文,用于衡量多模态检索模型在图文文档上的检索效果。
把多智能体协作中积累的能力蒸馏进单个 LLM Agent,让一个模型就能跑出多智能体系统的效果,省去多路调用的开销。
面向 AI Agent 的 GPU 性能分析器,能追踪 GPU 内核执行和推理过程,帮开发者定位性能瓶颈、优化显存与算力使用。
把家里已有的多台电脑组网成 AI 内网,统一跑大模型推理和微调训练,兼容 OpenAI 接口,适合本地部署和 homelab 场景。