关键词:语音识别

描述或关键词里包含「语音识别」的项目,共 125 个。找不到想要的?试试完整搜索。

用搜索引擎找 →
whisper
openai·Python

OpenAI 开源的通用语音识别模型,基于大规模弱监督训练,支持多语言转写、翻译和语种识别,开箱即用。

语音识别+4语音进阶
112444+30714kv202506252026-08-31 17:19 UTC
whisper.cpp
ggml-org·C++

OpenAI Whisper 语音识别模型的 C/C++ 移植版,无需 Python 和 GPU 依赖,在普通 CPU 上就能跑语音转文字。

语音识别+4语音推理进阶
55091+1046.3kv1.9.52026-11-10 12:09 UTC
faster-whisper
SYSTRAN·Python

基于 CTranslate2 重实现的 Whisper 语音转文字推理引擎,通过量化与高效推理大幅提速并降低显存占用,适合本地部署转录。

语音识别+4语音推理进阶
26661+892.2kv1.2.12026-11-10 10:13 UTC
whisperX
m-bain·Python

基于 Whisper 的语音识别工具,能给出词级时间戳并支持说话人分离,适合做字幕对齐和会议转写。

语音识别+4语音推理进阶
25212+652.5kv3.8.62026-10-22 14:53 UTC
FunASR
modelscope·Python

开源语音识别工具包,覆盖训练、推理、流式 ASR、VAD、标点恢复和说话人分离全流程,并提供 OpenAI 兼容与 MCP 服务接口。

语音识别+4语音推理进阶
20997+402.1kv1.4.242026-11-11 06:56 UTC
pyvideotrans
jianchang512·Python

把视频从一种语言翻译成另一种语言,自动生成配音和字幕并嵌入视频,适合做视频本地化和跨语言内容分发。

视频翻译+4语音推理进阶
19707+392.4kv4.182026-11-11 09:11 UTC
Speech
NVIDIA-NeMo·Python

面向语音 AI 的可扩展生成式框架,覆盖语音识别、语音合成、说话人分离与语音翻译,方便研究和开发人员训练部署语音模型。

语音识别+4语音推理硬核
18731+183.7kv3.0.02026-11-11 03:02 UTC
sherpa-onnx
k2-fsa·C++

基于新一代 Kaldi 和 onnxruntime 的离线语音工具包,一套搞定语音识别、合成、说话人分离、降噪、声源分离和 VAD,可跑在嵌入式、手机和服务器上。

语音识别+4语音推理进阶
15882+681.9kv2.0.12026-11-11 02:07 UTC
kaldi
kaldi-asr·Shell

Kaldi 是经典的语音识别工具库,提供声学建模、解码和说话人识别等完整流程,适合搭建语音转文字与说话人验证系统。

语音识别+4语音推理硬核
15514+45.3k2025-09-22 07:06 UTC
vosk-api
alphacep·Jupyter Notebook

离线语音识别 API,支持 Android、iOS、树莓派和服务器,提供 Python、Java、C#、Node 多语言绑定,适合注重隐私、不依赖云端的语音转文字场景。
离线语音识别+4语音推理进阶
15243+111.8kv0.3.502026-10-15 08:36 UTC
subtitleedit
SubtitleEdit·C#

一款用 C# 开发的开源字幕编辑器,支持字幕的创建、编辑、时间轴调整和格式转换,还能借助语音识别自动生成字幕。

字幕编辑+4字幕工具进阶
14951+541.4kv5.4.02026-11-11 11:05 UTC
PaddleSpeech
PaddlePaddle·Python

开箱即用的语音工具包,覆盖流式语音识别、语音合成、声纹识别、语音翻译和关键词唤醒,自带标点恢复与文本前端,适合快速搭建语音推理服务。

语音识别+4语音推理硬核
12705+12.0kr1.5.02026-08-12 01:07 UTC
speechbrain
speechbrain·Python

基于 PyTorch 的开源语音工具包,覆盖语音识别、说话人识别与分离、语音增强等任务,提供预训练模型和训练流程,方便快速搭建语音系统。
语音工具包+4语音推理进阶
11933+51.8kv1.1.22026-10-14 23:12 UTC
moonshine
moonshine-ai·C++

超低延迟的语音转文字、意图识别和语音合成工具,用来搭建语音助手和语音交互界面,响应快、适合实时对话场景。

语音识别+4语音推理进阶
11473+45658v0.1.62026-11-10 23:51 UTC
WhisperLiveKit
QuentinFuxa·Python

本地跑实时语音转文字,带流式识别、说话人分离和翻译,还兼容 OpenAI/Deepgram 接口,适合自建低延迟转写服务。

实时语音识别+4语音推理进阶
11233+121.2kv0.2.272026-11-08 01:22 UTC
silero-vad
snakers4·Python

预训练的企业级语音活动检测(VAD)模型,能精准切分音频中的说话段与静音段,支持 ONNX 和 PyTorch 部署,适合语音识别、语音指令等场景的前置处理。

语音活动检测+4格式转换进阶
10636+23888v6.2.32026-10-22 02:02 UTC
espnet
espnet·Python

端到端语音处理工具箱,覆盖语音识别、合成、翻译、增强、分离和说话人日志等任务,基于 PyTorch 提供统一训练与推理流程。
语音识别+4翻译硬核
10012+22.4kv.2026112026-11-09 17:59 UTC
SenseVoice
QwenAudio·C

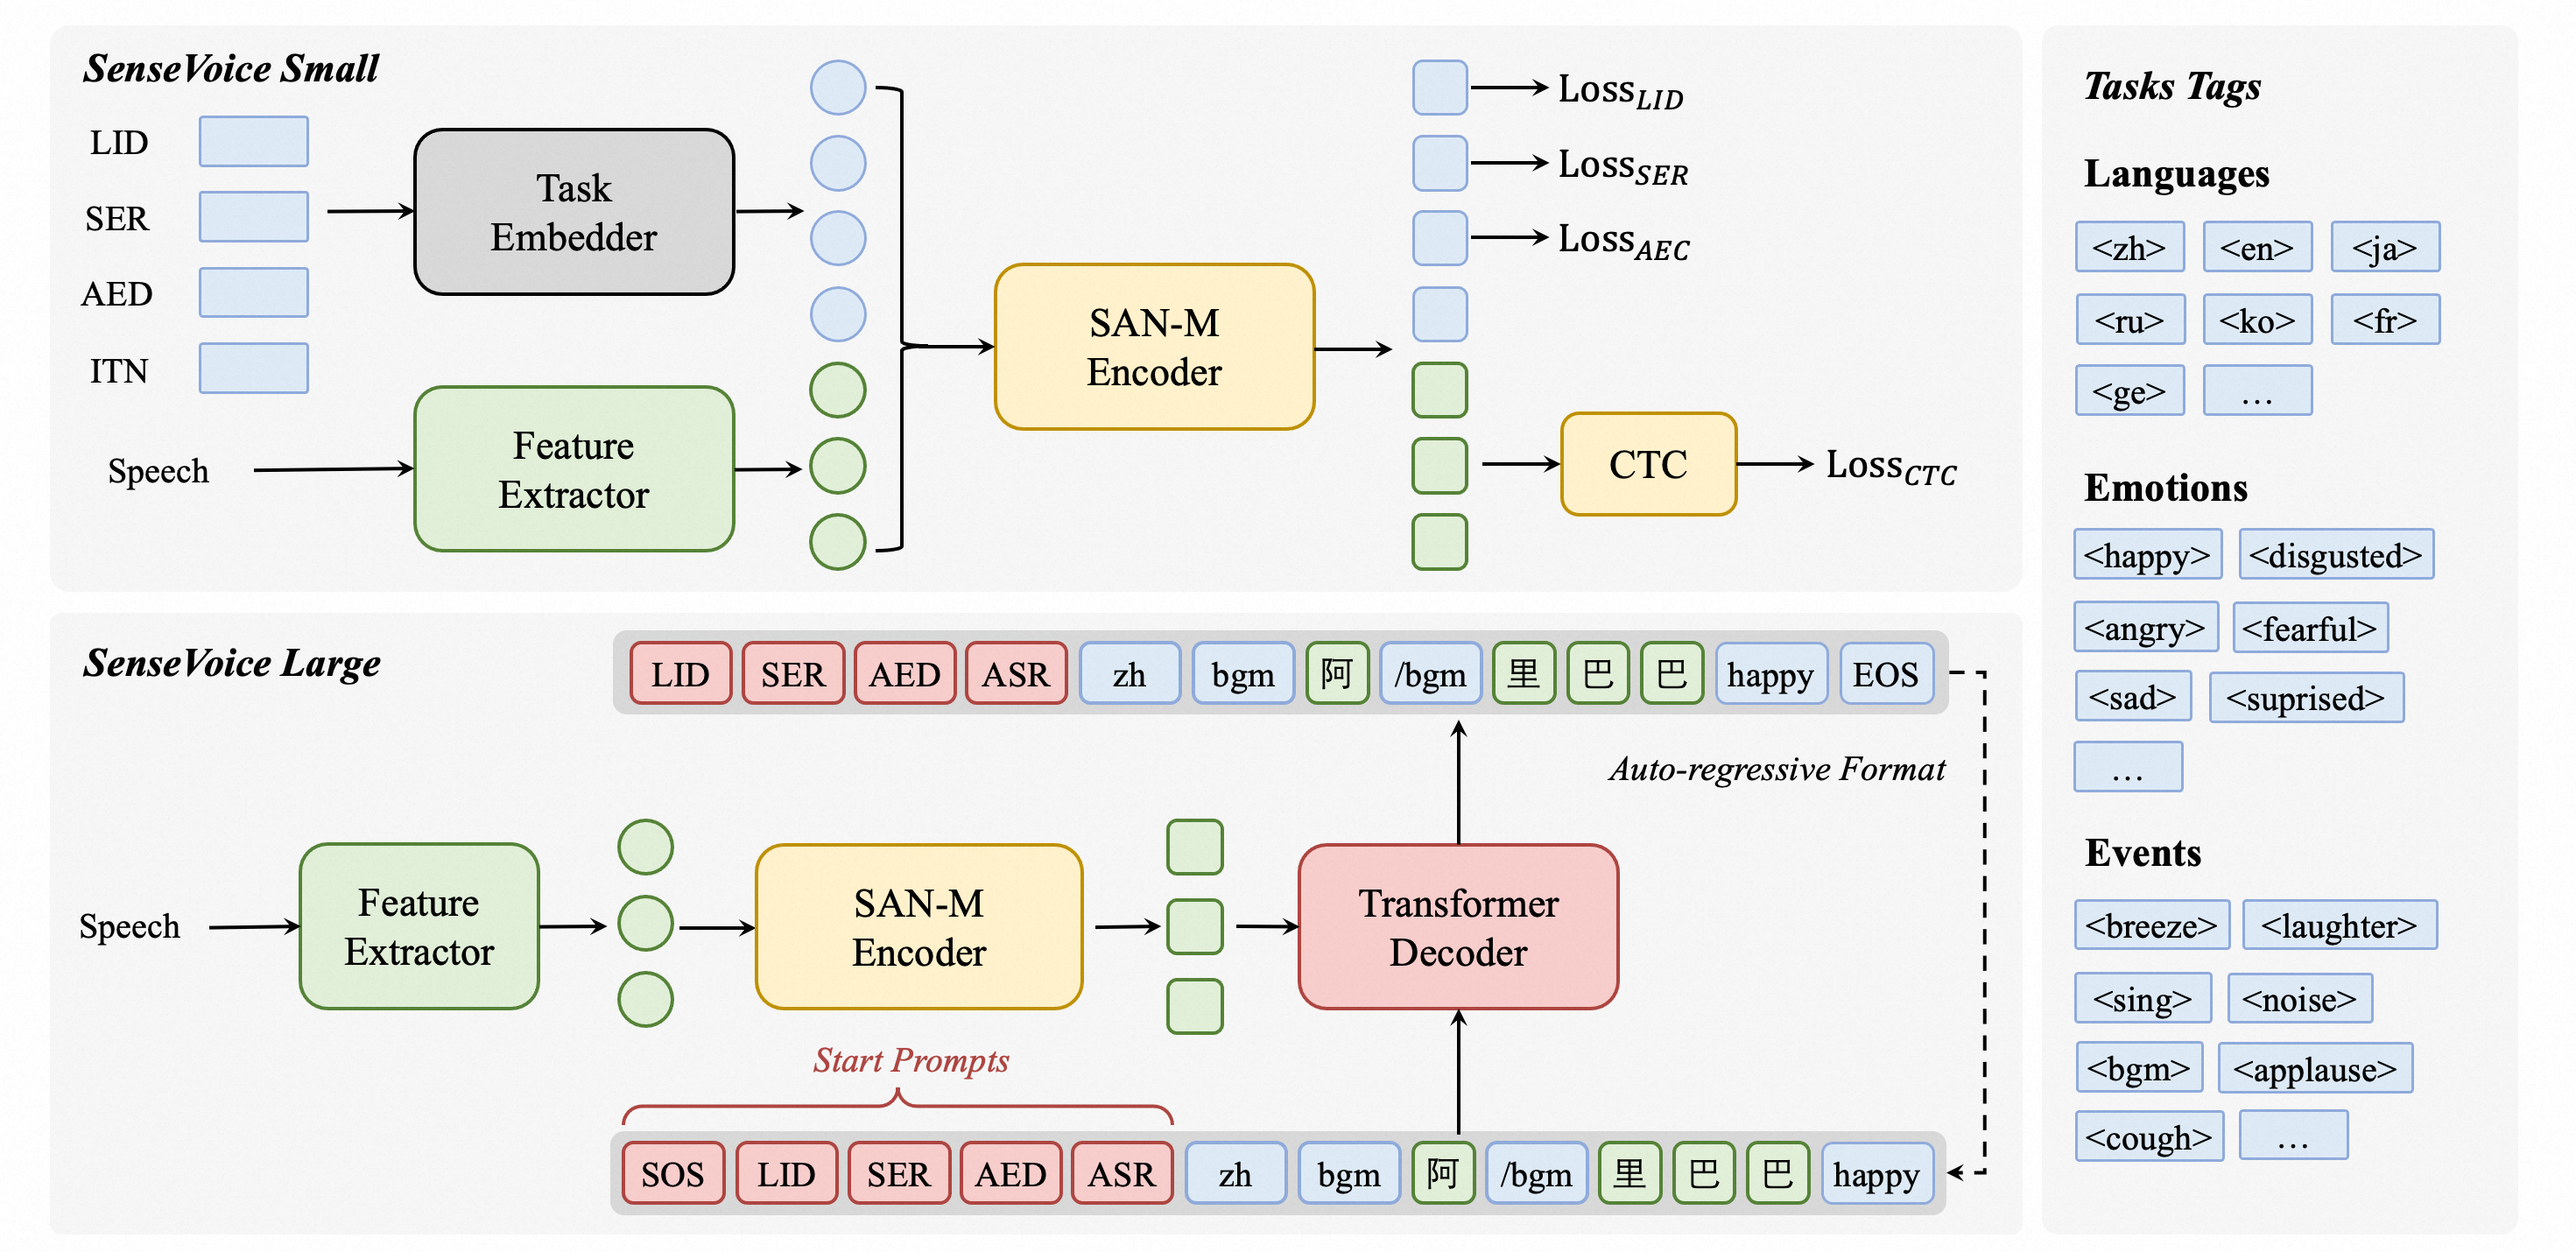
多语种语音理解模型,一次推理就能完成中英日韩粤语音识别、语种判别、情绪识别和音频事件检测,适合做语音交互与音频分析。

语音识别+4语音推理进阶
9739+29847runtime-llamacpp-v0.2.12026-09-30 10:22 UTC
speech_recognition
Uberi·Python

Python 语音识别库,统一封装多种在线和离线引擎与 API,几行代码就能把音频转成文字,省去逐个对接各家服务的麻烦。

语音识别+4语音推理入门
9000+12.4k3.17.02026-09-02 00:04 UTC
ASRT_SpeechRecognition
nl8590687·Python

基于深度学习的中文语音识别系统,用 CNN+CTC 把中文语音转成文字,适合搭建本地语音转写服务。

中文语音识别+4语音推理硬核
8403+61.9kv1.3.02026-04-10 15:33 UTC
mlx-audio
Neywa-Labs·Python

基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。

语音合成+4视觉语言模型进阶
8245+32793v0.6.52026-11-10 00:31 UTC
annyang
TalAter·TypeScript

给网页加语音识别的前端库,几行代码就能让站点听懂用户说话,支持语音指令和语音转文字。
语音识别+4语音推理入门
6822+21.0kv3.1.12026-10-29 08:30 UTC
FunClip
modelscope·Python

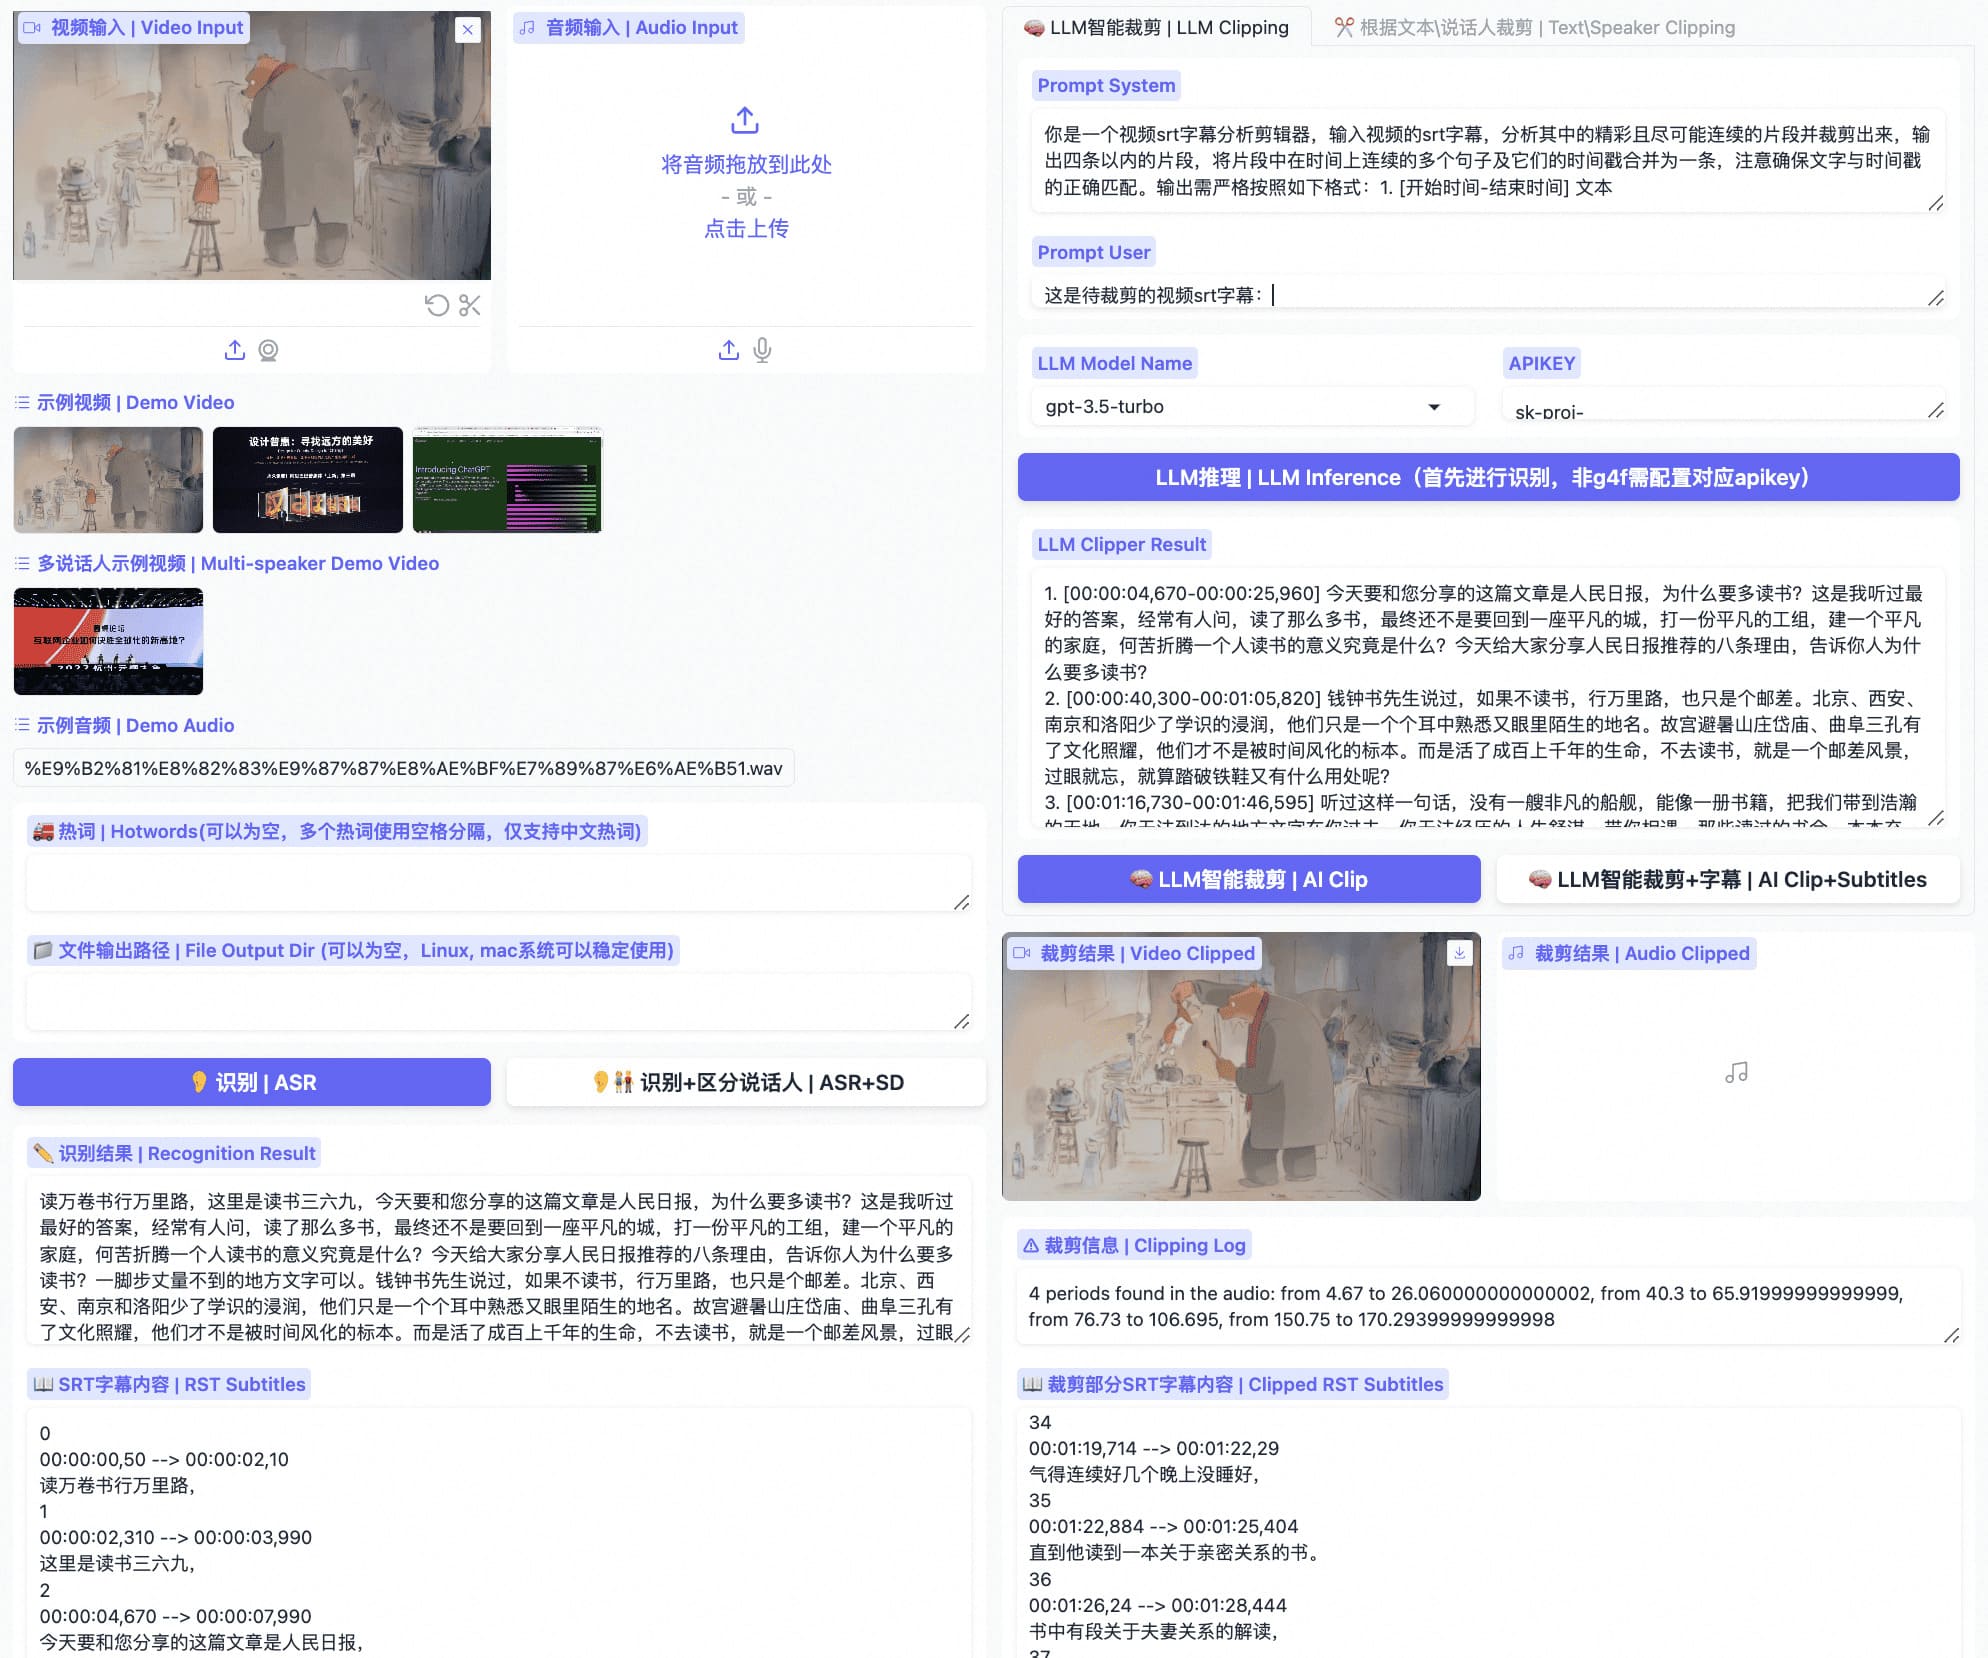
基于 FunASR 的本地视频转写与字幕生成工具,带 Gradio 界面,还能用大模型辅助自动剪辑,适合做中文视频内容创作。

语音识别+4语音推理进阶
6537+30773v2.2.12026-11-01 14:52 UTC
argmax-oss-swift
argmaxinc·Swift

面向 Apple Silicon 的端侧语音 AI 工具包,用 Swift 在 iOS 和 macOS 上本地跑语音识别、说话人分离和语音合成,不用联网也能处理音频。

端侧推理+4大模型推理服务进阶
6452+6626v1.1.12026-10-27 23:59 UTC
wav2letter
flashlight·C++

Facebook AI 开源的端到端语音识别训练工具包,用 C++ 实现,可基于 wav2letter 架构训练声学模型,省去传统 ASR 繁琐的特征工程流程。

语音识别+4语音推理硬核
6445982v0.22026-08-28 12:17 UTC
hex
anomalyco·Rust

跨 macOS、Windows、Linux 的本地语音听写工具,用 Rust 编写,把说的话实时转成文字,全程离线运行,不上传云端。

语音听写+4语音推理进阶
6306+624383v3.3.02026-11-11 11:25 UTC
PaddleX
PaddlePaddle·Python

基于飞桨的一站式开发工具,把分类、检测、分割、OCR、语音识别等任务封装成流水线,支持训练到部署全流程。
飞桨+4检测 / 分割进阶
6293+31.2kv3.7.22026-10-20 09:48 UTC
SmartSub
buxuku·TypeScript

一站式桌面工具,用本地 Whisper、FunASR 等模型离线把视频转成字幕,还能翻译、AI 配音、声音克隆和烧录字幕,支持批量处理与全平台 GPU 加速。
语音转字幕+4语音推理进阶
6008+41485v3.12.22026-11-09 07:03 UTC
YouDub-webui
liuzhao1225·TypeScript

开源 AI 视频本地化配音工具,把 YouTube/Bilibili 视频自动做语音识别、字幕翻译、声音克隆和混音渲染,一站式生成多语言配音成片。
视频翻译+4语音推理硬核
5830+18627v0.0.122026-11-06 10:56 UTC
whisper-diarization
MahmoudAshraf97·Jupyter Notebook

基于 OpenAI Whisper 的语音转写工具,能自动识别不同说话人并切分对话,适合会议记录、访谈整理等多人语音场景。

语音识别+3语音推理硬核
56735042026-08-15 09:11 UTC
wenet
wenet-e2e·Python

面向生产环境的端到端语音识别工具包,基于 PyTorch 提供 Conformer、Transformer 等模型,可直接训练和部署 ASR 服务。

语音识别+4语音推理进阶
52551.2kv3.1.02026-10-26 12:07 UTC
ml-road
yanshengjia·Python

机器学习与智能体 AI 的学习资源合集,涵盖计算机视觉、NLP、语音识别等方向的实践教程与研究资料,适合系统入门和查阅。

机器学习+4训练框架
49801.7k2026-08-01 12:36 UTC
stt
jianchang512·Python

离线运行的本地音视频转字幕工具,能把语音识别成文字,输出 JSON、SRT 字幕和纯文本格式,适合不想上传云端、注重隐私的字幕制作场景。

语音识别+4语音推理
4849+6512202508052026-01-22 08:38 UTC
WhisperSpeech
WhisperSpeech·Jupyter Notebook

把 OpenAI Whisper 语音识别模型反过来用做文本转语音的开源 TTS 系统,基于 PyTorch 实现,可直接在真实语音数据上训练出多说话人合成效果。
语音合成+4语音
46592802025-12-14 11:11 UTC
LLPlayer
umlx5h·C#

面向语言学习者的视频播放器,支持双语字幕、Whisper 语音识别自动生成字幕、OCR 识别画面文字,并接入大模型做实时翻译。

语言学习+4语音推理
4634+27291v0.3.02026-11-05 07:58 UTC
WhisperLive
collabora·Python

把 OpenAI Whisper 做成近实时的语音转文字服务,支持 TensorRT、OpenVINO、ROCm 等硬件加速,适合直播字幕和听写场景。

语音识别+4硬件加速适配
4354+5609v0.10.02026-11-02 18:59 UTC
pocketsphinx
cmusphinx·C

轻量级离线语音识别引擎,用 C 写成、体积小、资源占用低,适合在嵌入式设备和移动端做实时语音转文字。

语音识别+4语音推理
4354+2730v5.1.12026-10-13 18:10 UTC
audio.cpp
0xShug0·C++

纯 C++ 音频推理引擎,基于 ggml 实现,一套代码覆盖语音合成、识别、VAD、变声和音乐生成,不依赖 Python,适合边缘部署。

音频推理引擎+4语音推理
4167+62507v0.9.42026-11-11 05:14 UTC
speaches
speaches-ai·Python

基于 faster-whisper 的语音转写服务,提供兼容 OpenAI API 的接口,用 Docker 一键部署即可获得本地语音识别与翻译能力。

语音转写+4语音推理
3763+6465v0.9.0-rc.32026-11-11 04:51 UTC
whisper-asr-webservice
ahmetoner·Python

把 OpenAI Whisper 封装成开箱即用的 Docker 语音识别 Web 服务,上传音频即可通过 API 拿到转写文本,省去自己搭推理服务的麻烦。

语音识别+4语音推理
3369+3582v1.10.02026-10-01 17:25 UTC
whisper-standalone-win
Purfview

免装 Python 的 Whisper 与 Faster-Whisper 独立可执行程序,解压即用,直接做语音转文字、字幕生成和说话人分离。

语音识别+4语音推理
3236+4168Pro2025-11-07 19:21 UTC
ruby-openai
alexrudall·Ruby

Ruby 生态里调用 OpenAI API 的客户端库,封装 GPT-5、Realtime WebRTC、Whisper、DALL·E 等接口,让 Rails 项目直接接入对话、语音和图像能力。

OpenAI 客户端+4API 开发与调试
3220381v8.3.02026-05-01 14:37 UTC
qwen-audio-agent
QwenAudio·JavaScript

面向 AI Agent 的实时语音运行时,把语音识别和语音合成接进编码助手,让 Agent 能边说话边干活、保持在线。

实时语音+4编码 Agent
3207+44343v2.0.12026-11-11 04:00 UTC
OpenSuperWhisper
Starmel·Swift

macOS 上的本地语音听写应用,基于 Whisper 和 Parakeet 模型把语音实时转成文字,适合想要离线、隐私友好的语音输入用户。

语音听写+4语音推理
3141+82910.1.02026-11-10 08:13 UTC
willow
HeyWillow·C

自托管的本地语音助手,对标 Amazon Echo 和 Google Home,用 ESP32 硬件加语音识别在本地完成唤醒与语音转文字,数据不出户,适合注重隐私的智能家居场景。
语音助手+4IoT / 固件
3136+31290.4.32026-11-01 00:35 UTC
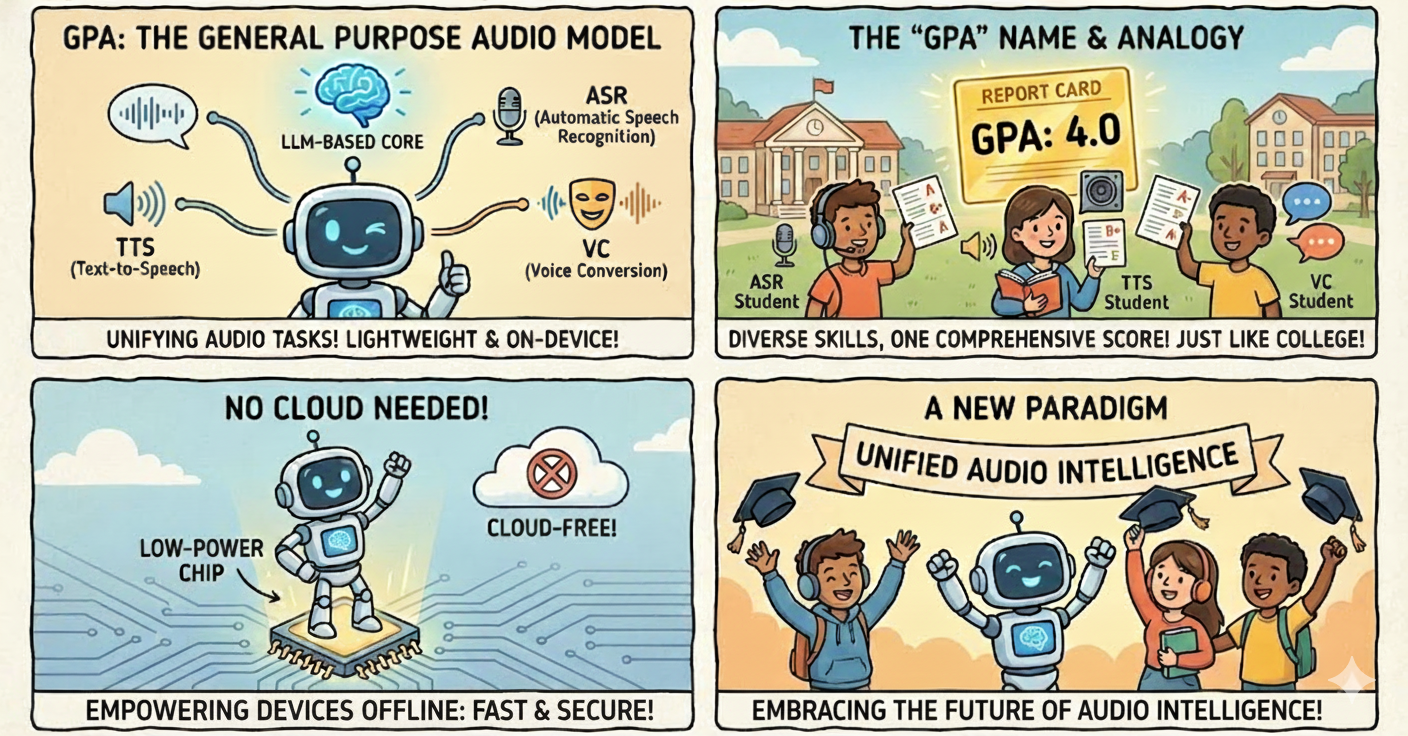
GPA
AutoArk·Python

一个超小型的通用音频模型,用同一套权重同时完成语音识别、语音合成和音色转换,省去为每种任务单独部署模型。

语音识别+4语音推理
30552012026-05-25 08:02 UTC
openai
betalgo·C#

面向 .NET 开发者的 OpenAI API 封装库,可在 C# 项目里直接调用 ChatGPT、DALL·E、Whisper 和 Azure OpenAI 服务。

OpenAI SDK+4语音推理
3022539v9.1.02026-03-21 23:26 UTC
faster-whisper-GUI
CheshireCC·Python

基于 PySide6 的 faster-whisper 图形界面,让语音转文字不用敲命令行,支持 VAD 和 WhisperX 等能力。

语音转文字+4语音推理
30011730.8.52026-08-25 17:07 UTC
Whisper-WebUI
jhj0517·Python

给 Whisper 语音识别模型套上 Gradio 网页界面,上传音视频就能自动生成字幕,省去命令行操作。

语音识别+4语音推理
2900448v1.0.82025-12-29 07:53 UTC
lingvo
tensorflow·Python

Lingvo 是 Google 开源的序列建模框架,用 TensorFlow 搭建语音识别、机器翻译、语言模型等 NLP 任务,支持分布式 GPU 训练。

序列建模+4语音推理
28684522026-10-29 06:43 UTC
whisper-timestamped
linto-ai·Python

基于 Whisper 的多语言语音识别工具,能输出词级时间戳和置信度,方便做字幕对齐和逐词定位。

语音识别+4语音推理
2860212v1.15.92026-09-28 09:57 UTC
WhisperJAV
meizhong986·Python

用 Qwen3-ASR、Whisper 和本地 LLM 给日语音视频自动生成字幕,靠 TEN-VAD 和降噪处理应对嘈杂背景音。
语音识别+4语音推理
2451+12206v1.10.12026-11-05 20:47 UTC
cicada
wquguru·Swift

给任意会议或直播加实时字幕、同声传译和 AI 会议纪要的跨平台工具,支持 Mac、Windows、Linux 和 Android,免费开源。

实时字幕+4语音推理
2159+539371v1.8.02026-11-10 16:34 UTC
parlor
fikrikarim·Python

在本地设备上跑实时多模态 AI 的 Python 项目,整合语音识别、语音合成和本地大模型,实现类似 GPT-Live 的实时对话体验,支持 Apple Silicon 和 MLX。

端侧AI+4视觉语言模型
2112281v2.0.02026-08-03 18:06 UTC
FireRedASR
FireRedTeam·Python

开源工业级语音识别模型,支持普通话、中文方言和英语,在公开普通话 ASR 榜单上刷新 SOTA,还能精准识别歌词。

语音识别+4语音推理
20141682026-02-25 07:14 UTC
julius
julius-speech·C

开源的大词汇量连续语音识别引擎,用 C 语言实现,可直接在本地完成语音转文字,适合搭建离线识别服务。

语音识别+4语音推理
1941302v4.62025-06-16 07:10 UTC
comfyui-mixlab-nodes
MixLabPro·JavaScript

为 ComfyUI 提供工作流一键转 APP、屏幕共享与悬浮视频、GPT 与 3D 节点、语音识别和 TTS 等扩展节点,方便把生成流程直接做成可交互应用。

ComfyUI 节点+4语音
1873127v0.46.02026-06-04 07:37 UTC
sherpa-ncnn
k2-fsa·C++

基于新一代 Kaldi 和 ncnn 的离线实时语音识别与语音活动检测引擎,无需联网即可在手机、嵌入式板卡和桌面端跑起来。
语音识别+4语音推理
1800222v2.1.152025-10-20 02:16 UTC
bailing
wwbin2017·Python

百聆是一个类 GPT-4o 的实时语音对话助手,串联 ASR、大模型和 TTS,端到端延迟低至 800ms,支持打断,Mac 等低配设备也能跑。

语音助手+4语音推理
1792307v0.0.32026-04-06 04:21 UTC
sglang-omni
sgl-project·Python

面向交互式超级智能系统的高性能推理服务运行时,支持语音识别、音频与音乐生成等多模态模型,并提供 OpenAI 兼容 API。

推理服务+4语音推理
1754+41719voxt-v2.0.32026-11-11 10:34 UTC

共 125 个,这里展示前 60 个。