标签:GPTQ 量化
技术标签,共 93 个项目。

一套统一接口搞定 100+ 大语言模型和多模态模型的微调,支持 LoRA 等高效训练方式,省去为每个模型单独写训练脚本的麻烦。
基于 CTranslate2 重实现的 Whisper 语音转文字推理引擎,通过量化与高效推理大幅提速并降低显存占用,适合本地部署转录。
在 LLaMA/Alpaca 基础上扩充中文词表并做中文增量预训练,提供可本地 CPU/GPU 部署的中文大模型及 LoRA 微调、量化方案。

本地部署的 AI 量化投资研究平台,集成回测、机器学习选股与自动交易,帮个人开发者搭建从策略研究到实盘的完整量化流程。
基于 TurboQuant 量化算法、用 Rust 实现并带 Python 绑定的向量索引,面向 RAG 和嵌入检索场景,提供高压缩比、低内存的近似最近邻搜索。
用纯 C99 从零实现的 Kimi K3 推理引擎,单 CPU、8.24 GB 内存即可跑 2.78 万亿参数模型,不依赖 BLAS、框架或 GPU。

让大模型在普通显卡上跑起来的 PyTorch 量化库,支持 8-bit 和 4-bit 权重压缩,也是 QLoRA 微调背后的核心依赖。
用有损量化把 PNG 压到原体积的几分之一,肉眼几乎看不出差别,适合给网页和 App 里的图片瘦身。
面向 Transformer 模型的高性能推理引擎,用 C++ 实现并支持 CUDA、AVX、NEON 等硬件加速,让机器翻译等模型在 CPU/GPU 上跑得更快、显存占用更低。
量化注意力算子库,在语言、图像、视频模型上比 FlashAttention 快 2-5 倍且不损失端到端精度,可直接替换加速推理。

用低秩分支吸收离群值的 4-bit 扩散模型量化方案,让 FLUX 等大模型在低显存下也能高速出图,并已集成 ComfyUI。

面向 vLLM 生产推理的 LLM 压缩工具,支持量化等压缩算法,把大模型压小以便高效部署。
一份 AI 工程面试速查题库,覆盖 Agent、LLM 推理、微调、量化、MCP 等考点,帮求职者系统准备面试。
为 Transformers、Diffusers 等模型提供硬件加速与量化、ONNX 导出等优化工具,让推理和训练在各类硬件上跑得更快。
Sparsity-aware deep learning inference runtime for CPUs
PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。
把 Nunchaku 的 4-bit 量化扩散模型推理接进 ComfyUI,让 FLUX 等模型在低显存下也能快速出图。
在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。
面向已训练神经网络模型的量化与压缩库,提供剪枝、量化等高级技术,帮助在部署前压缩模型体积、降低推理开销。
面向 PyTorch、TensorFlow 和 ONNX Runtime 的模型压缩工具,支持 INT8/FP8/INT4 等低比特量化和稀疏化,帮大模型在低精度下保持精度并降低显存与推理成本。
xTuring 提供从数据预处理到微调的完整流程,让开发者用 LoRA、Adapter 等轻量方法快速个性化开源大模型,降低训练门槛和显存开销。
让大参数 Qwen 模型在消费级显卡上跑得动、跑得快:通过 vLLM 补丁和重量化流水线,单张 24GB 卡即可服务 27B 模型,并附完整基准测试。
一套面向应用 AI 的实战教程,用 Jupyter Notebook 讲透大模型微调、推理与量化,帮工程师把 LLM 真正跑起来。
在 256MB 内存的十美元级开发板上跑 10 亿参数大模型,靠量化与 C 实现把 LLM 推理压进嵌入式设备。
A Python package for extending the official PyTorch that can easily obtain performance on Intel platform
腾讯开源的模型压缩工具包,支持量化、投机解码和扩散模型加速,帮你在部署大模型时降低显存占用、提升推理效率。
Intel 开源的模型量化工具,用训练后量化的低成本达到量化感知训练级别的精度,支持 int4、GGUF、MXFP4 等格式,可直接对接 vLLM、SGLang 推理。
飞桨生态下的模型压缩与架构搜索库,提供剪枝、量化、蒸馏和 NAS 等能力,帮你在部署前把深度模型压小提速。
基于 PyTorch 的神经网络量化库,支持训练后量化和量化感知训练,方便把模型部署到 FPGA 等硬件上做加速。
面向 Keras 和 TensorFlow 的模型压缩工具包,通过量化和剪枝把训练好的模型压小、跑得更快,方便部署到移动端和边缘设备。

本地完成计算机视觉模型从标注、训练到优化部署的全流程,支持增量学习与模型压缩,针对 Intel XPU 加速并兼容 CUDA。
面向大模型量化的压缩工具包,支持 NVIDIA、AMD、Intel、华为昇腾等多硬件加速,可无缝接入 HF、vLLM 和 SGLang 推理。
免训练稀疏注意力方案,可直接接入任意模型推理,加速 LLM、视觉 Transformer 和视频生成,无需重新训练即可降低注意力计算开销。
面向 OpenVINO 推理的神经网络压缩框架,提供量化、剪枝和混合精度训练,把模型压小提速后再部署。
把对话语言模型压到 2-bit 量化,小到能在 8 位 Z80 处理器上跑,用 Python 训练后导出成 CP/M 的 .COM 程序,让老电脑也能聊天。
把量化神经网络编译成 FPGA 上的数据流推理加速器,省去手写 RTL 的麻烦,适合做低延迟边缘部署。
PyTorch 量化后端,接入 Optimum 生态,支持多种量化方案,帮你在推理和训练中压缩模型、降低显存占用。
把 ONNX 模型一键转成 TFLite、TensorFlow、PyTorch 原生代码或 TorchScript,省去跨框架部署时手写转换脚本的麻烦。
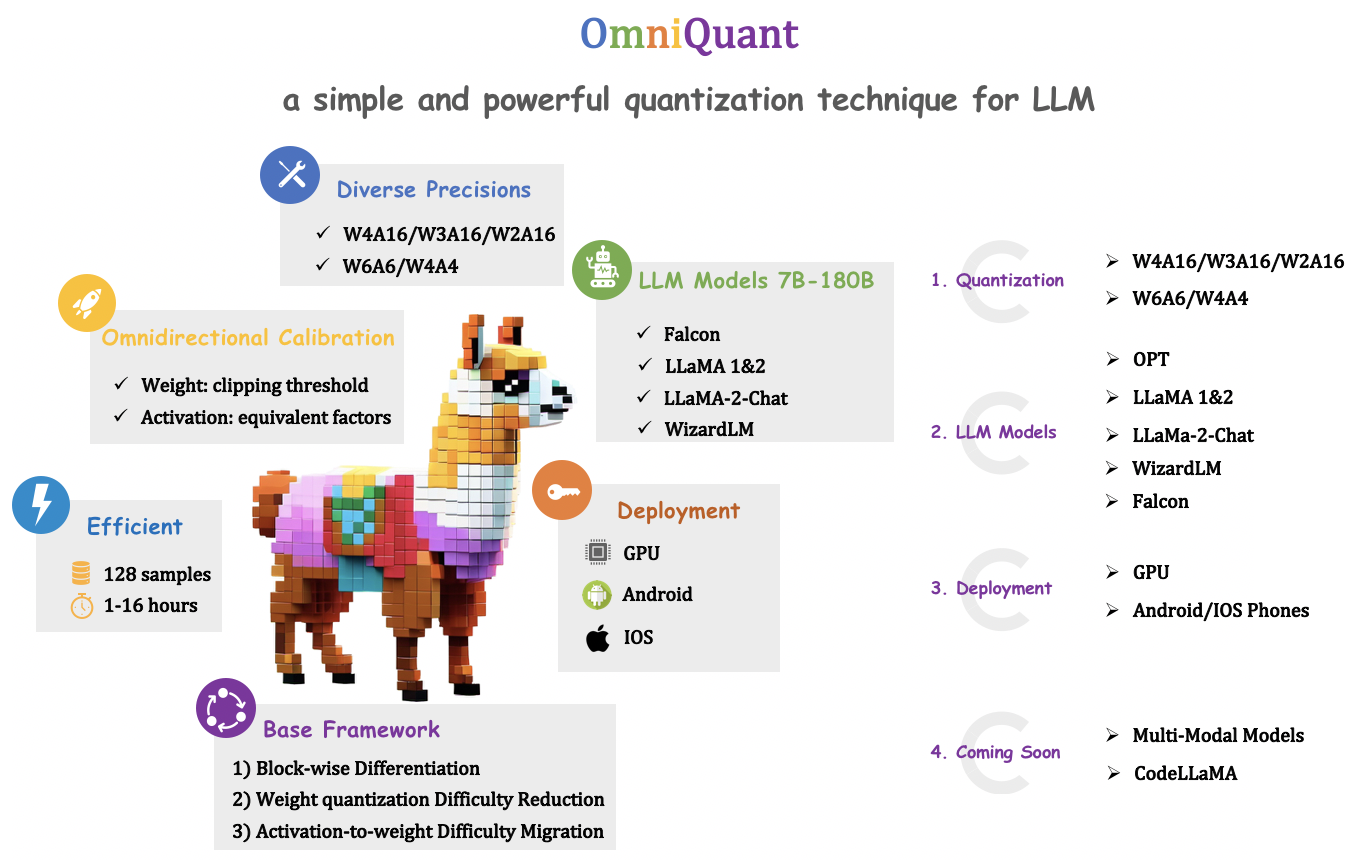
一种简单又强大的大模型量化技术,通过可学习权重裁剪和等价变换,在保持精度的同时把 LLM 压到低比特,方便部署推理。
HQQ 是一种无需校准数据的大模型量化方法,官方实现支持几行代码把 LLM 压到低比特,省显存还能保持精度。
把 RGBA 像素转换成高质量调色板图像的量化库,是 pngquant 等 PNG 压缩工具的核心,能在保持画质的同时大幅减小图片体积。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
用 Rust 写的 RDNA 原生大模型推理引擎,直接跑在 AMD GPU 上,让 RDNA 显卡也能高效做 LLM 推理和量化。
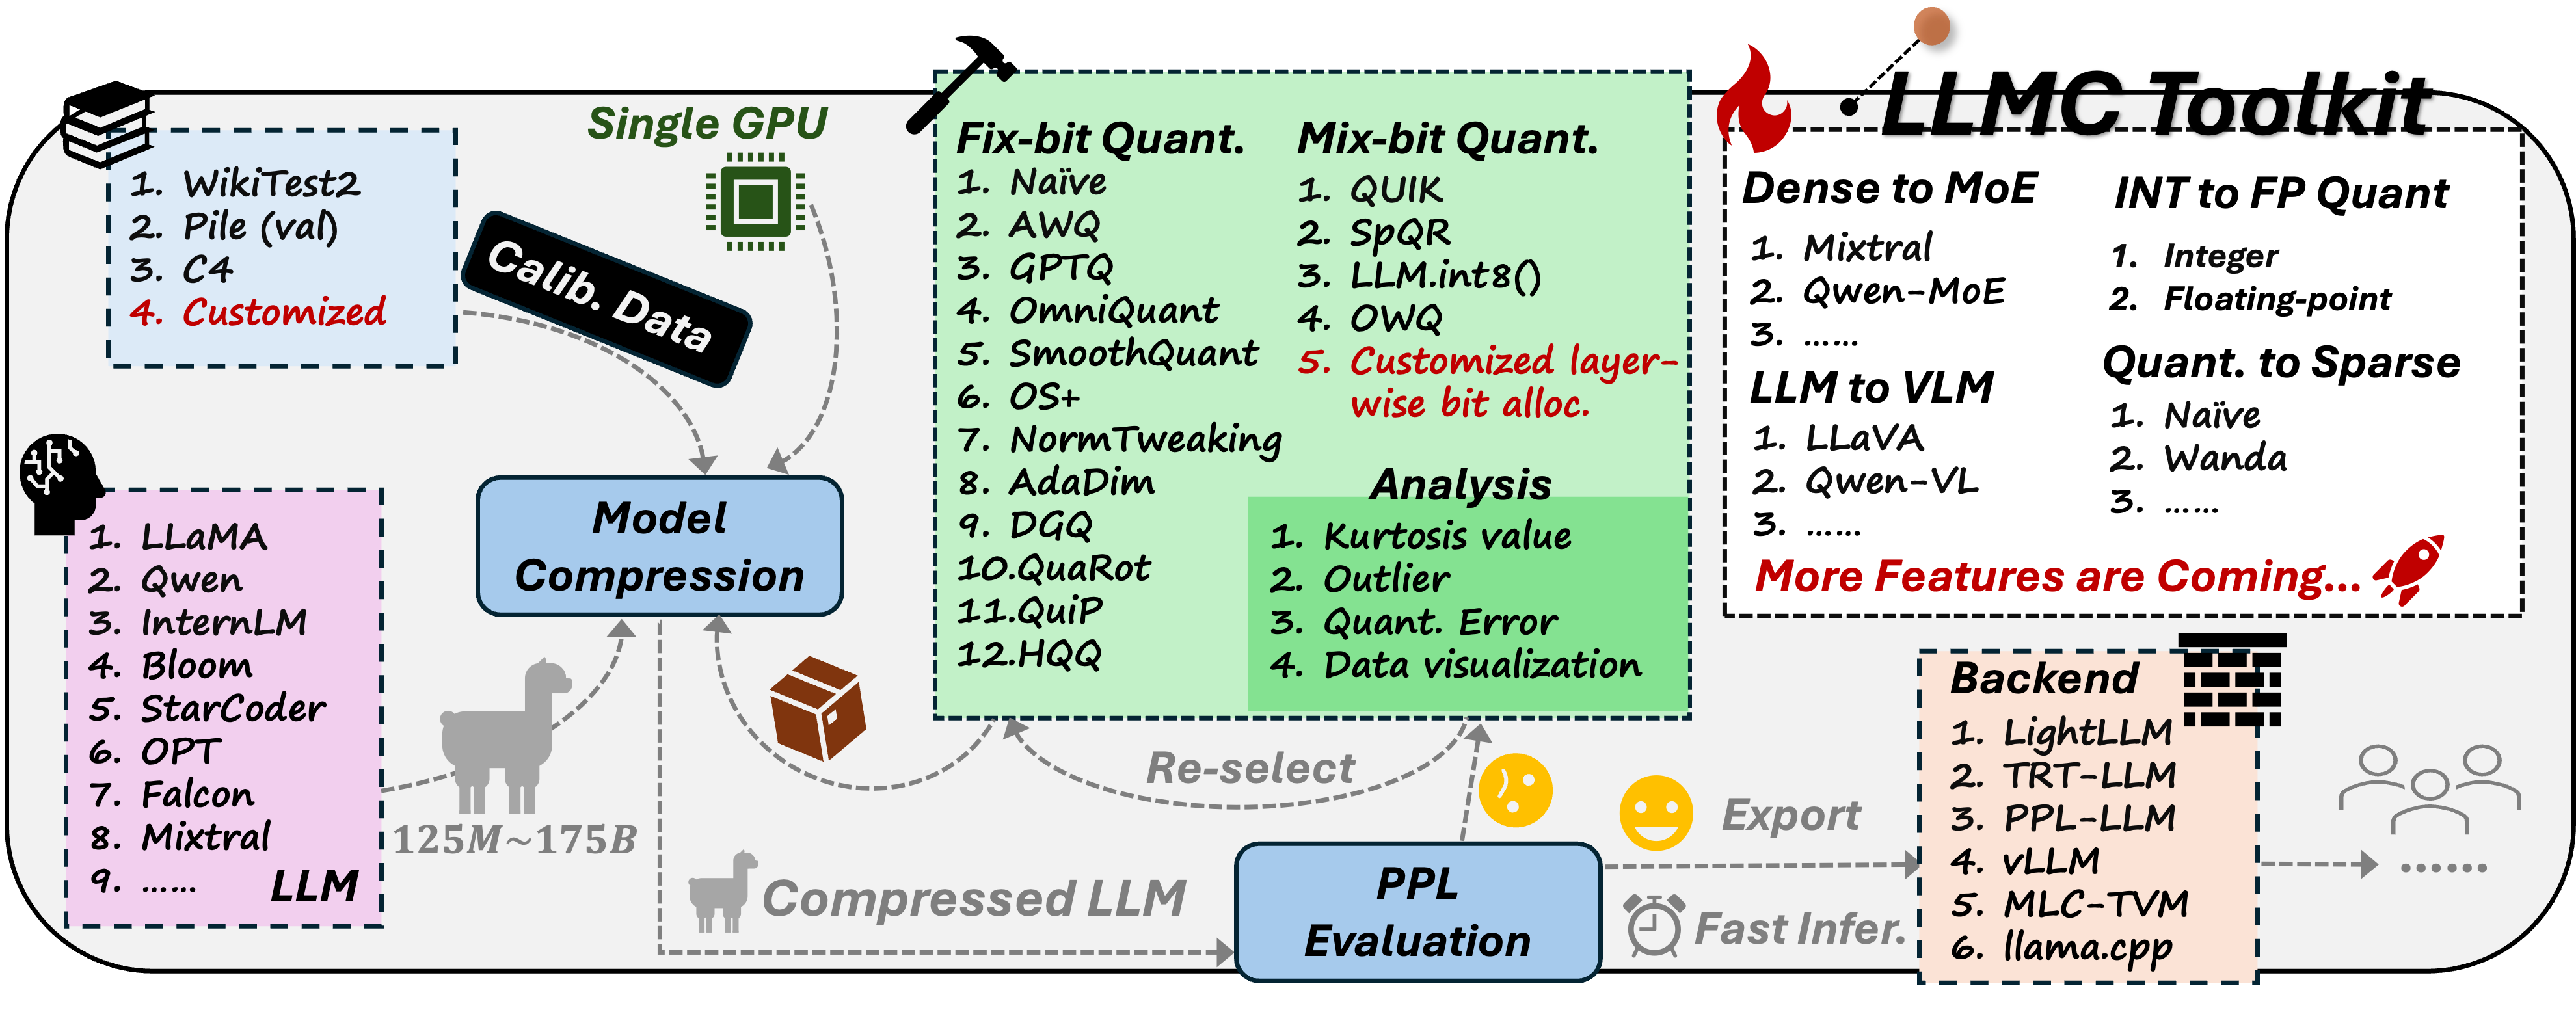
一站式大模型压缩工具箱,支持 LLM、VLM 和视频生成模型的量化与剪枝,覆盖 AWQ、SmoothQuant 等算法,并提供压缩后的评测与部署流程。
Hailo 官方预训练模型库,提供面向 Hailo-8 边缘 AI 加速器的模型、量化工具和完整评估环境,方便直接部署到端侧设备。
纯 C 写的本地大模型推理引擎,靠 MoE 稀疏激活和 NVMe 流式加载,让 32GB 笔记本跑 80B 模型,速度全面超过 llama.cpp。
面向 AI 秋招的中英双语面试速查表,覆盖机器学习、大模型、扩散模型与智能体,可生成单文件 HTML 随时翻阅,另附学术主页生成器。
SINQ 是一种即插即用的 LLM 量化方法,能把任意大模型压小并尽量保住精度,适合显存吃紧时部署 DeepSeek、Qwen 等模型。
基于 TensorFlow Keras 的量化深度学习库,支持量化感知训练,方便把模型部署到 FPGA、ASIC 等硬件加速器上。
把 ONNX 模型转成 Keras 或 TFLite 的转换工具,方便将 PyTorch 训练好的模型部署到移动端和嵌入式设备,还支持量化。
从零实现的大模型蒸馏与推理服务引擎,包含自定义 Triton/CUDA 算子、FSDP 蒸馏、分页 KV 连续批处理、投机解码和 Rust 网关,适合研究推理加速与可解释性。
QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。
给 vLLM 加一个免校准的 KV-cache 量化后端,只需一个开关就能把上下文拉长 3~5 倍,吞吐超过 FP16 且精度基本不掉,适合跑长上下文 Agent。
在单张 RTX 4090 加 110GB 内存的游戏 PC 上本地跑 552B 的 DeepSeek-V4.1-Flash 做编码智能体,MoE 专家分层放在显存、锁页内存和 NVMe 上,兼容 OpenAI 与 Anthropic API。
基于 Qwen3.6-27B 做去审查与能力增强的 abliteration 模型,配合 NVFP4 量化和 DFlash 投机解码,在 DGX Spark 上优化长上下文草稿接受率,附多种 HF 变体与 Docker 部署。
面向边缘受限硬件的神经网络压缩工具包,提供量化感知训练和训练后量化等高级量化压缩能力,帮研究者把模型高效部署到资源紧张的设备上。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。
免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。
系统讲解大模型推理与部署的理论与实践,涵盖量化、LoRA、剪枝、知识蒸馏等模型压缩与优化技术,适合想上手 LLM 部署的开发者学习。
PiSSA 是一种参数高效微调方法,用主奇异值和奇异向量初始化 LoRA 的低秩矩阵,让大模型微调收敛更快、效果更好。
共 93 个,这里展示前 60 个。