标签:vLLM 生态
技术标签,共 100 个项目。
开源语音识别工具包,覆盖训练、推理、流式 ASR、VAD、标点恢复和说话人分离全流程,并提供 OpenAI 兼容与 MCP 服务接口。
Llama 官方示例手册,手把手教你在推理、微调、RAG 等场景中落地 Llama 系列模型,并覆盖多家云服务商的端到端方案。

在 Docker 里跑 Android 模拟器,支持 noVNC 网页操作、录屏和 MCP 服务,方便在 CI 或云端做自动化测试与 AI 代理控制。
把 AI 研究与工程技能打包成可复用模块,接入 Claude Code、Codex、Gemini 等编码代理后即可获得完整科研能力。
冰霜之地的技术博客合集,深入拆解 Go、HTTP/2、密码学、算法与机器学习等源码,适合想系统啃底层实现和系统设计的工程师。

给 LLM 推理加速的 KV Cache 层,可对接 vLLM 等框架,复用和缓存键值对来降低显存占用、提升吞吐,支持 CUDA 和 ROCm。
基于 Ray 的高性能 RLHF 训练框架,支持 PPO、DAPO、REINFORCE++ 等算法与 vLLM 推理加速,可扩展地完成大模型和视觉语言模型的对齐后训练。
一行代码就能把 GPT 换成任意开源大模型,统一推理 API 支持云端、本地和笔记本部署,覆盖语言、语音和多模态模型。
面向数据中心的分布式推理服务框架,用 Rust 编写,支持 vLLM、SGLang、TensorRT-LLM 等后端,解决大规模 LLM 与扩散模型在生产环境下的解耦部署和请求路由问题。
Mooncake 是支撑 Kimi 大模型服务的推理平台,通过 KVCache 分离式架构和 RDMA 高速传输,把预填充与解码拆开部署,提升长上下文场景下的吞吐和资源利用率。
面向 LLM 推理的可编程语义路由层,按请求语义把流量分发到不同模型和算力,并内置护栏与 K8s 集成。
本地大模型推理服务的模型热切换代理,按需自动加载和卸载不同模型,让单个服务端同时对外提供多个 LLM,省去手动重启。
在 Kubernetes 上统一部署生成式与预测式 AI 模型的推理平台,支持多框架、可扩展的分布式推理服务。
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
低代码 MCP 框架,用可视化方式快速搭建复杂 RAG 流水线,省去大量胶水代码,适合快速验证检索增强生成方案。
面向系统工程师的实战课程,在 Apple Silicon 上从零搭建一个迷你 vLLM 推理引擎并跑通 Qwen 模型,帮你搞懂大模型推理系统的内部机制。
整理大模型与多模态推理加速论文和配套代码的资源清单,涵盖 Flash-Attention、Paged-Attention、低比特量化与并行策略等方向,方便快速定位和复现关键技术。
用 ML、LLM 和视觉大模型从文档、表单、发票等非结构化数据里抽取结构化字段,并支持指令调用和智能体工作流。
面向 AI Agent 的级联运行时,在 Agent 循环内按成本、延迟、质量和策略动态调度模型与决策,帮你在不牺牲效果的前提下省下推理开销。
基于飞桨的高性能推理部署工具包,专门用来把大语言模型和多模态模型跑起来、服务化,支持 ERNIE 系列和 OpenAI 兼容接口。
系统梳理 GPU 架构、CUDA 编程、大模型基础与 AI Agent 的入门知识库,帮开发者补齐 AI 基础设施底层原理。
用容器方式在本地跑 AI 模型推理的开发工具,屏蔽不同模型来源和硬件差异,一条命令就能起服务并用于生产。
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
让大参数 Qwen 模型在消费级显卡上跑得动、跑得快:通过 vLLM 补丁和重量化流水线,单张 24GB 卡即可服务 27B 模型,并附完整基准测试。
为 LLM 推理提供虚拟化弹性 KV Cache,让多个推理任务动态共享 GPU 显存,减少显存碎片和浪费,提升 GPU 利用率。
开源推理研究平台,用于在 AMD、CUDA 等不同 GPU 上对 LLM 推理服务做基准测试和性能对比,帮团队选型加速卡。
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
统一管理 VLLM、Sglang、llama.cpp、exllamav3 等本地大模型推理引擎的控制面板,省去逐个配置和切换的麻烦。
一套 0.8B 到 27B 的开源决策模型,一次前向就能为每个选项给出校准概率,只在不确定时才输出简短思考;配套 vLLM、llama.cpp 和 MLX 推理引擎。
Intel 开源的模型量化工具,用训练后量化的低成本达到量化感知训练级别的精度,支持 int4、GGUF、MXFP4 等格式,可直接对接 vLLM、SGLang 推理。
在 Apple Silicon 上跑大模型的高性能推理服务,兼容 OpenAI 和 Anthropic 接口,支持 MLX 原生加速、连续批处理、多模态和 MCP 工具调用。
把任意 LLM 改造成 Jev 风格决策模型,输出带类型的决策和真实概率,无需训练即可使用,适合需要可靠置信度的决策场景。
开源 AI 工作站整机方案,覆盖 2 卡桌面到 8 卡服务器,提供 CAD 图纸、BOM 清单、BIOS 配置和装机指南,方便自建本地大模型推理机器。
面向扩散模型和全模态模型的多模态强化学习训练框架,支持 GRPO、流匹配和 vLLM 推理,用来做图像生成与多模态模型的 RLHF 训练。
在 Kubernetes 上部署和扩缩容 ML 模型推理服务的 Operator,支持 LLM、VLM、向量嵌入和语音转文字,并提供 OpenAI 兼容 API。
面向大模型量化的压缩工具包,支持 NVIDIA、AMD、Intel、华为昇腾等多硬件加速,可无缝接入 HF、vLLM 和 SGLang 推理。
EAGLE-4 的官方推理代码,用投机解码加速大模型生成,可接入 SGLang、vLLM 等主流推理框架,显著提升 token 吞吐。
用 C++ 和 CUDA 手写一个高性能 LLM 推理引擎的教学项目,是 vLLM 的精简版,涵盖 PagedAttention 和连续批处理等核心机制。
一份 10 周、每天 30 分钟的 LLM 推理服务与优化学习路线,覆盖 vLLM、SGLang、量化、投机解码和基准测试,帮工程师系统入门推理加速。
统一多模态模型的强化学习训练框架,打通 SGLang、vLLM 推理后端,方便把多模态大模型跑通 RL 训练流程。
Spark-X2.6 是面向端侧设备的开源模型系列,主打把智能体能力压进本地运行的模型里,支持 llama.cpp、MLX 等推理后端。
一份系统梳理大模型推理的学习笔记,涵盖 Transformer 结构、KV Cache、CUDA 与 Triton 算子编程,以及 vLLM 等框架的源码分析。

本地离线运行的便携式 OCR 软件,用 DeepSeek-OCR-2 模型直接在你自己机器上识别图片和 PDF,适合不想把文档传到云端的场景。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
在 Debian 上从零搭建完全本地私有的 LLM 服务器,集成聊天、联网搜索、RAG、模型管理、MCP、图像生成和语音合成。
一个可审计的 AI 数据分析工作台,能查看结果背后的代码和证据、回放验证计算过程,并支持本地开源模型等多种模型选择。
把 Discord 变成大模型聊天前端,接入 OpenAI、Gemini、Ollama 等多种 LLM,在服务器频道里直接对话。
在免费 Kaggle TPU v5e-8 上跑 GLM-5.3-Flash 320B MoE 和 Qwen3.8-27B 等前沿大模型,自研 JAX 推理引擎支持 262k 长上下文和前缀缓存,可接入 Claude Code 等编码代理。
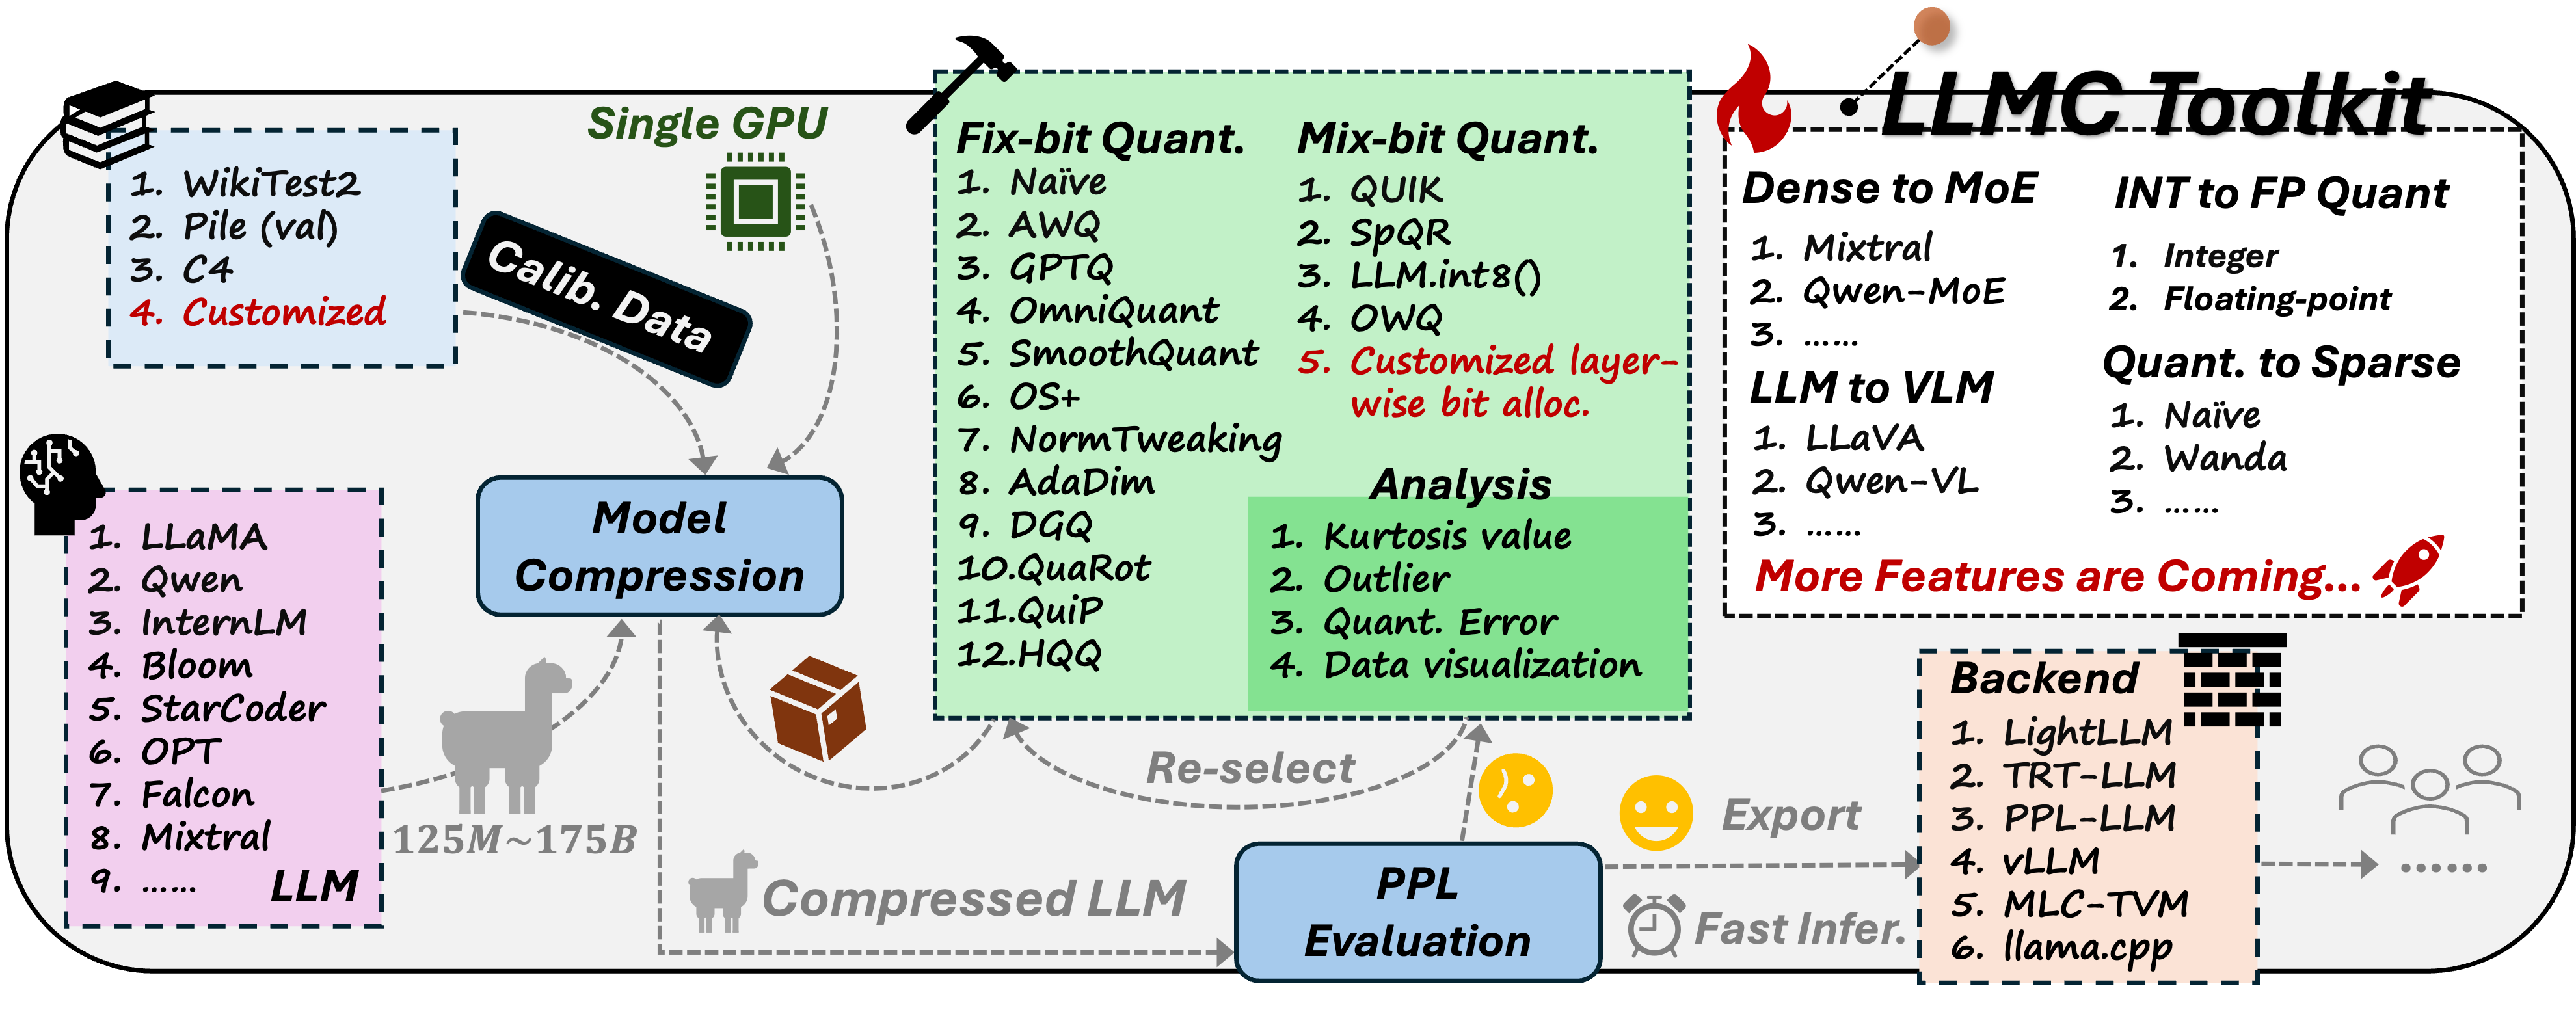
一站式大模型压缩工具箱,支持 LLM、VLM 和视频生成模型的量化与剪枝,覆盖 AWQ、SmoothQuant 等算法,并提供压缩后的评测与部署流程。
纯 Rust + CUDA 实现的大模型推理引擎,不依赖 PyTorch,兼容 OpenAI 接口,可部署 Qwen3 到 Kimi-K2 等模型。
面向 LLM 推理系统的可扩展仿真器,能在不实际部署集群的情况下,大规模、高精度地模拟 Transformer 推理性能,用于容量规划与架构选型。
用 Rust 写的引擎无关 LLM 网关,统一兼容 OpenAI 与 Anthropic 接口,把 vLLM、SGLang、Gemini 等后端接到同一入口,并支持 KV 缓存感知路由和 gRPC 流水线。
把 SAM3 通过渐进式知识蒸馏压缩成轻量边缘模型,实现快速的可提示概念分割与跟踪,适合端侧部署。

自托管的 AI Agent 操作系统,把记忆、聊天、Agent 和文件都留在自己的硬件上,默认离线运行,还能把树莓派、Mac mini、游戏 PC 自动组集群。
把模型打包成 OCI 镜像来分发和运行,让任意 agent 都能跑在任意模型上,省去环境配置和模型管理的麻烦。

基于 Kubernetes 的云原生 AI 训练与推理平台,集成 Jupyter、PyTorch、Ray、LLaMA-Factory 等组件,帮团队在集群上统一管理深度学习环境的构建与任务调度。
在 RTX 5090 / RTX PRO 6000(sm_120)上跑 DeepSeek-V4.1-Flash 等前沿 MoE 大模型的 vLLM 适配方案,支持 GPU+CPU 混合推理和 2-bit 专家量化。
面向机器人操作任务的统一大脑模型,把抽象指令逐步落到具体动作,配套官方推理代码,可直接用于具身智能研究。
在 NVIDIA DGX Spark 上快速启动、管理和停止 LLM 推理服务,支持 vLLM、SGLang、llama.cpp 等后端,省去手动配置环境的麻烦。
给 vLLM 推理服务器套上现代化 Web 界面,方便管理和对话,兼容 GPU/CPU,并针对 macOS Apple Silicon 与 OpenShift/Kubernetes 部署做了优化。
共 100 个,这里展示前 60 个。