模型工具链
232 个仓库模型的转换、量化、编译与硬件适配。
一个跨平台本地大模型聊天客户端,通过统一界面连接 llama.cpp 本地模型以及 Anthropic、OpenAI、DeepSeek、Ollama 等远程服务。
在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。
Local AI API Platform
面向已训练神经网络模型的量化与压缩库,提供剪枝、量化等高级技术,帮助在部署前压缩模型体积、降低推理开销。
面向 PyTorch、TensorFlow 和 ONNX Runtime 的模型压缩工具,支持 INT8/FP8/INT4 等低比特量化和稀疏化,帮大模型在低精度下保持精度并降低显存与推理成本。

汇集计算机视觉方向的实战项目合集,覆盖 Python、C++、CUDA 和嵌入式部署,方便直接上手跑通检测、识别等模型并落地到 TensorRT 等推理环境。
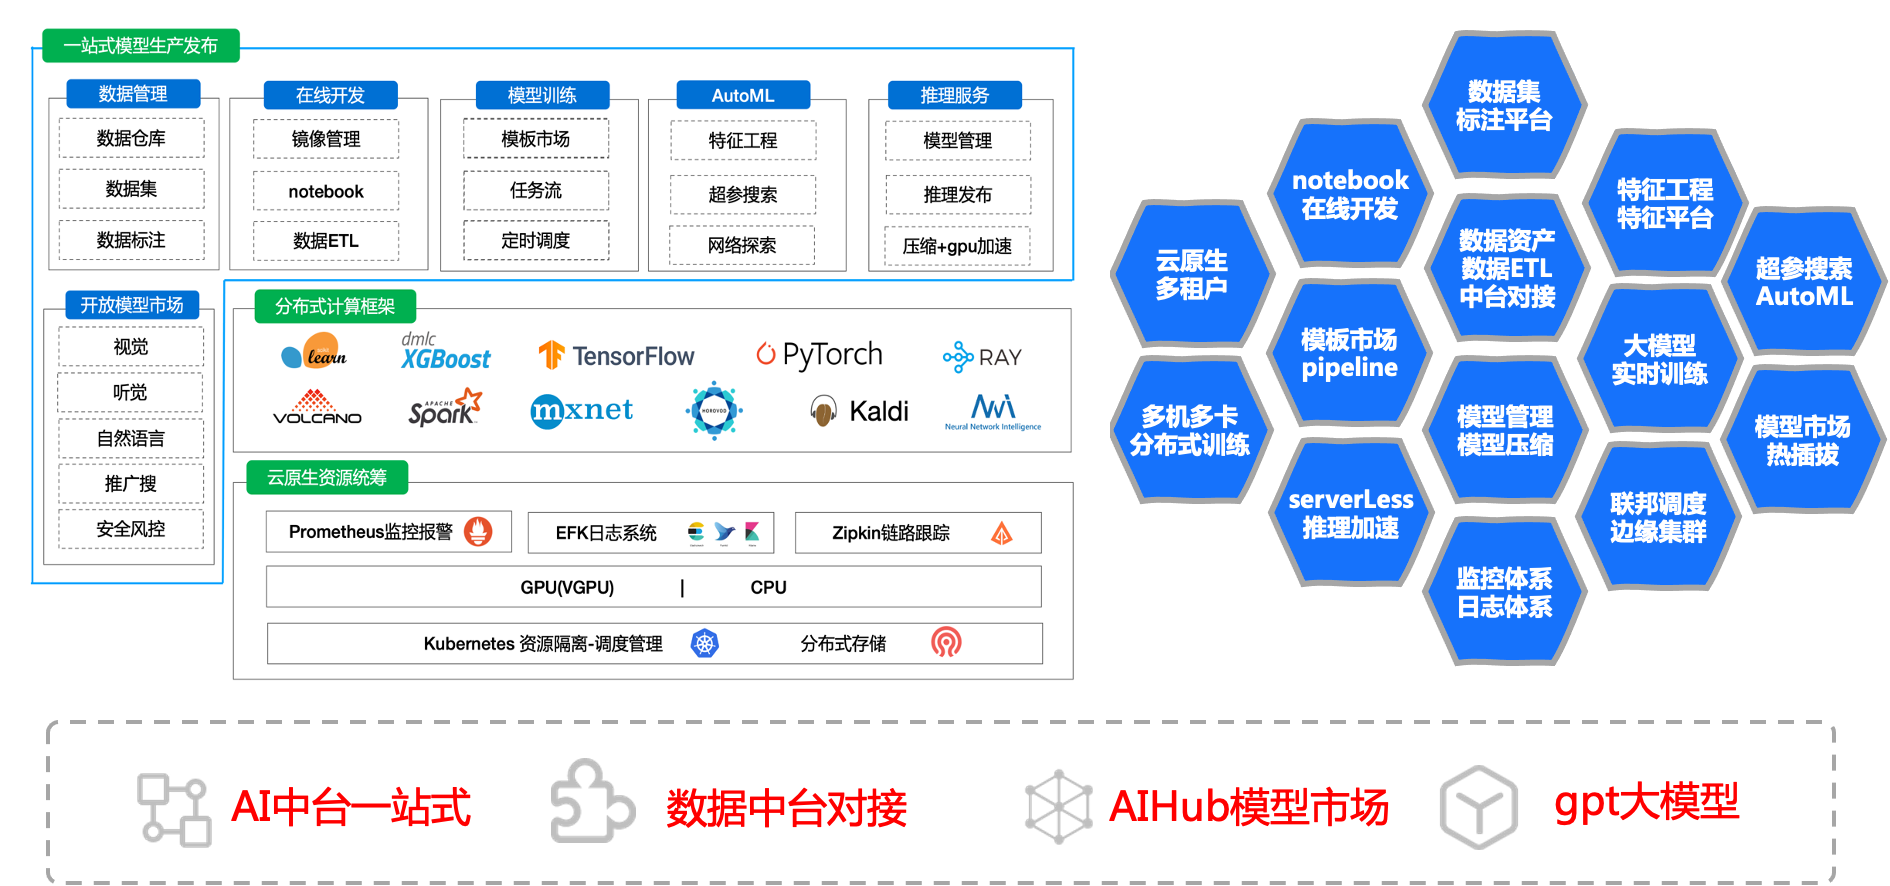
开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
把 TensorFlow、Keras、TensorFlow.js 和 TFLite 模型一键转成 ONNX 格式,方便跨框架部署和推理。
一套用于计算机系统课程教学的自编译 C 编译器、自执行 RISC-V 模拟器和自托管 RISC-V 虚拟机监控器,帮助学生在动手实现中理解编译、执行与虚拟化的完整链路。
GPTQ 是 ICLR 2023 论文的官方实现,能在训练后把 GPT 类大模型量化到 3/4 比特,几乎不掉精度,大幅降低显存占用和推理成本。

在 ComfyUI 里搭建 LLM Agent 的框架,接入 MCP、GraphRAG、语音合成与 OCR 节点,兼容 OpenAI 接口的各类模型和本地 GGUF 模型。
AutoAWQ implements the AWQ algorithm for 4-bit quantization with a 2x speedup during inference. Documentation:
把 Keras、PyTorch、ONNX 训练好的神经网络模型自动转成 FPGA 可综合的 HLS 代码,方便在硬件上做低延迟推理。
在 CPU 上实时做人脸检测和面部关键点跟踪,附带 Unity 集成,适合做虚拟形象、动捕这类不需要 GPU 的场景。
用 C++ 写的轻量级 ONNX 推理库,靠流式加载把内存压到极低,能在树莓派 Zero 2 或 298MB 内存里跑 Stable Diffusion XL 1.0,桌面端也能跑 Mistral 7B。
用 AnimeGANv3 把照片或视频一键转成日漫风格,支持 Colab、ONNX、CoreML、TFLite 等多种部署格式,方便直接产出动画作品。
整理大模型高效化研究的资源清单,汇总量化、剪枝、知识蒸馏等压缩与加速方向的论文和工具,方便快速找到降低推理成本的方法。
专为 AMD Ryzen AI NPU 深度优化的本地大模型推理引擎,几分钟内就能在 AMD NPU 上跑起 LLM,省去繁琐配置。
A Python package for extending the official PyTorch that can easily obtain performance on Intel platform
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
本地运行的 AI 聊天应用与推理引擎,基于 llama.cpp 加载 GGUF 开源权重模型,完全离线、保护隐私,支持 Apple Silicon 桌面端。
macOS 上的本地语音转文字工具,基于端侧 AI 实现听写与转录,数据不出本机,也可按需接入云端。
一款简单易用、高性能的 AI 部署框架,支持 ONNX Runtime、MNN、昇腾等多种推理后端,用低代码方式把深度学习模型和生成式 AI 应用部署到各类硬件上。
一套面向大语言模型的实战课程 Notebook,覆盖 Hugging Face、LangChain、PEFT 微调、模型剪枝和向量数据库等,帮你从零动手跑通 LLM 应用与优化流程。