标签:Transformers
技术标签,共 123 个项目。
微软出品的 21 节生成式 AI 入门课程,用 Jupyter Notebook 带你从零理解大模型、提示工程和 ChatGPT 应用开发。
从零用 PyTorch 一步步实现类 ChatGPT 大语言模型,覆盖注意力机制、预训练、指令微调全流程,适合边跑代码边理解 LLM 内部原理。

从零手写实现 AI 工程核心组件的实战课程,覆盖智能体、大模型、计算机视觉与深度学习,边学边构建可交付的项目。

一套统一接口搞定 100+ 大语言模型和多模态模型的微调,支持 LoRA 等高效训练方式,省去为每个模型单独写训练脚本的麻烦。
用 PyTorch 逐行复现 60 多篇深度学习经典论文,代码旁配注释讲解,涵盖 Transformer、优化器、GAN、强化学习等,适合边读论文边对照实现学习。
用 PyTorch 实现的 Vision Transformer(ViT),只需一个 Transformer 编码器就能在图像分类任务上达到 SOTA,代码简洁易读,适合快速复现和二次开发。
汇总 CVPR 2026 录用论文及其配套开源代码,方便计算机视觉研究者快速找到带实现的新工作并跟进复现。
用 LoRA、Adapter 等少量参数微调大模型和扩散模型,大幅降低显存与训练成本,是 Hugging Face 生态里做参数高效微调的标准库。
一本面向大模型工程实践的开源手册,系统讲解 GPU 训练、推理、调试、网络与扩展性等落地问题,帮工程师把模型真正跑起来。

面向企业私有化部署的 AI 平台,可搭建智能体、助手和文档检索问答,支持多模型接入、深度研究与 API 连接。
NVIDIA 的大规模 Transformer 训练框架,支持张量并行、流水线并行等模型并行策略,用来在成百上千张 GPU 上高效预训练大语言模型。

在浏览器里直接跑 Hugging Face 的 Transformer 模型,不用后端服务器,前端就能做文本、视觉等机器学习推理。
RWKV 是一种兼具 RNN 与 Transformer 优势的语言模型架构,支持像 GPT 一样并行训练,推理时线性时间、常量显存、无限上下文,无需 KV 缓存。
一站式语义搜索与 LLM 编排框架,把向量检索、RAG 和智能体工作流整合在一起,用 Python 就能搭建基于语言模型的应用。

从下载数据到生成文本,手把手教你从零训练自己的大语言模型,适合想搞懂 LLM 训练全流程的开发者动手实践。
基于飞桨的 NLP 与大模型开发库,提供丰富模型库,覆盖 BERT、ERNIE、LLaMA 等,支持分布式训练、压缩和文档智能等任务。

基于 PyTorch 的开源语音工具包,覆盖语音识别、说话人识别与分离、语音增强等任务,提供预训练模型和训练流程,方便快速搭建语音系统。
微软开源的 PII 检测与脱敏框架,能从文本、图像和结构化数据中识别并匿名化姓名、电话等敏感信息,支持 NLP 与正则规则组合的自定义流水线。
基于 PyTorch 的语义分割模型库,提供 500+ 预训练卷积与 Transformer 骨干网络,开箱即用,省去自己搭建和训练分割模型的麻烦。
HuggingFace Transformers 库的实战教程合集,用 Jupyter Notebook 演示 BERT、GPT-2、LayoutLM、ViT 等模型的微调与推理,适合边跑边学。

用 Rust 实现的高性能分词器库,支持 BERT、GPT 等主流模型,兼顾研究实验与生产部署,解决文本预处理速度慢、跨语言调用不便的问题。

把训练好的深度学习模型优化并部署到 Intel CPU、GPU 等硬件上做推理,支持视觉、LLM 和生成式模型,省去自己折腾底层加速的麻烦。

在 Android 手机上本地跑 NLLB 模型的实时翻译 App,支持蓝牙耳机对话翻译,全程离线不联网也能用。
用一份 YAML 配置就能微调大模型,靠分层流式加载让 8B 模型在 4GB 显存的笔记本 GPU 上跑起来,省去手写训练脚本和显存焦虑。
基于 Ray 的高性能 RLHF 训练框架,支持 PPO、DAPO、REINFORCE++ 等算法与 vLLM 推理加速,可扩展地完成大模型和视觉语言模型的对齐后训练。

SANA 是英伟达开源的高效扩散生成模型与配套训练推理引擎,支持文生图、文生视频和世界模型,用线性注意力和 NVFP4 量化在低显存下实现快速生成。
一行代码就能把 GPT 换成任意开源大模型,统一推理 API 支持云端、本地和笔记本部署,覆盖语言、语音和多模态模型。
Accelerate local LLM inference and finetuning (LLaMA, Mistral, ChatGLM, Qwen, DeepSeek, Mixtral, Gemma, Phi, MiniCPM, Qwen-VL, MiniCPM-V, etc.) on Intel XPU (e.g., local PC with iGPU and NPU, discrete GPU such as Arc, Flex and Max); seamlessly integrate with llama.cpp, Ollama, HuggingFace, LangChain, LlamaIndex, vLLM, DeepSpeed, Axolotl, etc.
基于下一尺度预测的自回归视觉生成模型,用GPT式架构做图像生成并击败扩散模型,代码简洁易用,附带缩放定律研究。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
在 Jupyter 里交互式可视化 BERT、GPT-2、RoBERTa 等 Transformer 模型的注意力权重,帮助理解模型内部机制。

用 BERT 句向量加 c-TF-IDF 做主题建模,生成的主题可解释性强,适合从大量文本里快速挖掘和归类话题。
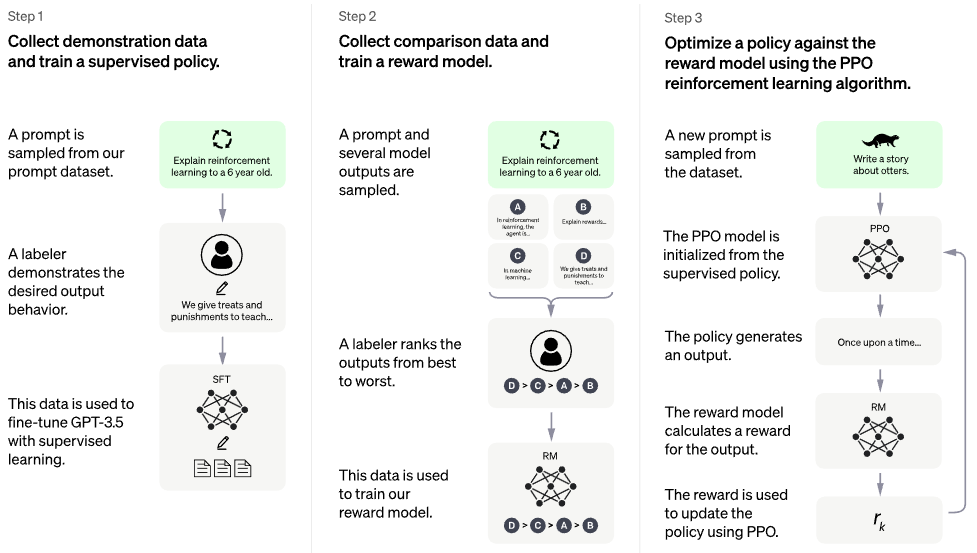
在 PaLM 架构上实现 RLHF 人类反馈强化学习,复现 ChatGPT 式训练流程,适合研究大模型对齐与强化学习微调。
基于 Megatron 和 DeepSpeed 在 GPU 上训练大规模自回归 Transformer 的模型并行框架,用来复现和扩展 GPT-3 级别的语言模型。

一站式 WebUI,基于 Diffusers 和 PyTorch 统一完成 AI 图像与视频生成、打标和后期处理,省去在多个工具间切换的麻烦。
基于 Python 的开源离线翻译库,用本地语言模型完成多语种互译,无需联网即可在自有设备上跑机器翻译。
面向 Apple Silicon 的端侧语音 AI 工具包,用 Swift 在 iOS 和 macOS 上本地跑语音识别、说话人分离和语音合成,不用联网也能处理音频。
把时间序列当成语言来建模的预训练预测模型,基于 Transformer 架构,可直接用于零样本或微调预测,省去从零训练的成本。

中文版 CLIP 预训练模型,支持中文图文跨模态检索和表征生成,可直接用于图文匹配、零样本分类等任务。
纯 Rust 实现的 WebGPU 推理引擎,原生支持 GGUF 模型,兼容 OpenAI API,无需 Python 和 llama.cpp,单个二进制文件即可在任意 GPU 上跑本地大模型。
一个简洁但完整的全注意力 Transformer 实现,集成了多篇论文中值得尝试的实验性特性,方便研究者快速试验各种注意力变体。
提供一套稳健的训练配方,用人类和 AI 偏好数据对齐语言模型,涵盖 SFT、DPO 等流程,帮你把基座模型调成听话好用的助手。
把数据库和 AI 模型直接打通的全栈框架,让你在 MongoDB 等数据源上直接做推理、训练和部署自定义 AI 应用与智能体。
从 PDF 学术论文中自动抽取标题、作者、参考文献等结构化元数据的机器学习工具,支持全文解析与引文提取。
面向 AI 研究者的开源实验环境,可在本地硬件到 GPU 集群之间无缝训练、评估和扩展大模型与扩散模型。
从零手搓大模型全链路的教学项目,涵盖 Transformer、LLaMA、Qwen、RAG、Agent 和扩散模型,帮学习者拆开白盒子理解每个环节的实现细节。
用 100 多张原创原理图把 LLM 和强化学习的关键算法讲清楚,适合想系统理解大模型训练与 RL 机制的人对照学习。
LightGlue 是一个基于 Transformer 的轻量级局部特征匹配网络,速度快、精度高,适合 SLAM、三维重建和位姿估计等需要实时图像匹配的场景。
把自然语言提示词编译成结构化输出的提示工程工具,支持 GPT 等模型,并提供提示词版本管理,省去手写解析逻辑。
开源的 AI 训练跟踪与可视化工具,支持云端和私有化部署,可无缝接入 PyTorch、Transformers 等主流训练框架,用来记录指标、对比实验。
Hugging Face 官方 Transformers 课程,系统讲解 Transformer 模型与 NLP 的实战用法,适合从零上手深度学习训练与微调。
中文语言理解测评基准,提供数据集、基线模型、预训练模型和排行榜,用于统一评估中文 NLU 模型能力。
基于 Transformers 的 Python 训练库,把文本分类、NER、问答、信息检索、语言生成、多模态和对话 AI 等任务的训练与推理流程统一封装,省去手写训练循环的麻烦。
从零手写现代 LLM 的教学项目,逐行注释、用大白话讲解注意力机制与 GPT/Llama 结构,适合想搞懂大模型内部原理的人边看边练。
基于 Spark 的分布式 NLP 库,把 BERT、LLM、ONNX 等模型封装成可直接调用的流水线,在集群上批量做命名实体识别、分词、翻译等任务。
封神榜大模型是 IDEA 研究院开源的中文大模型体系,提供预训练模型、分布式训练和多模态能力,为中文 AIGC 与认知智能应用提供基础模型支撑。
基于 JAX 的计算机视觉研究库,提供注意力机制、Transformer 和 Vision Transformer 等模型实现,方便快速搭建和复现视觉研究实验。
面向中文 NLP 的大模型实战代码库,覆盖数据准备、模型训练与推理全流程,含 BERT、ChatGLM、LLaMA 等示例,适合直接上手跑通中文大模型任务。
Multi-LoRA inference server that scales to 1000s of fine-tuned LLMs
把大语言模型包装成 scikit-learn 风格的估计器,让文本分类、标注等任务能直接套用 fit/predict 和 Pipeline,省去自己写调用逻辑。
共 123 个,这里展示前 60 个。