具身智能 / VLA

视觉-语言-动作模型与机器人学习。
ShowUI
showlab·Python

开源的端到端视觉-语言-动作模型,让 GUI 智能体看懂屏幕截图并直接输出点击、输入等操作,用于自动化电脑操作。
GUI智能体+3电脑 / 浏览器 Agent
19291442026-04-24 07:16 UTC
Autoregressive-Models-in-Vision-Survey
ChaofanTao

系统梳理视觉自回归模型的研究综述(TMLR 2025),覆盖图像生成、多模态、点云、运动预测等方向,帮研究者快速理清技术脉络与加速方法。
视觉自回归+4具身智能 / VLA
805232026-05-05 15:14 UTC
rai
RobotecAI·Python

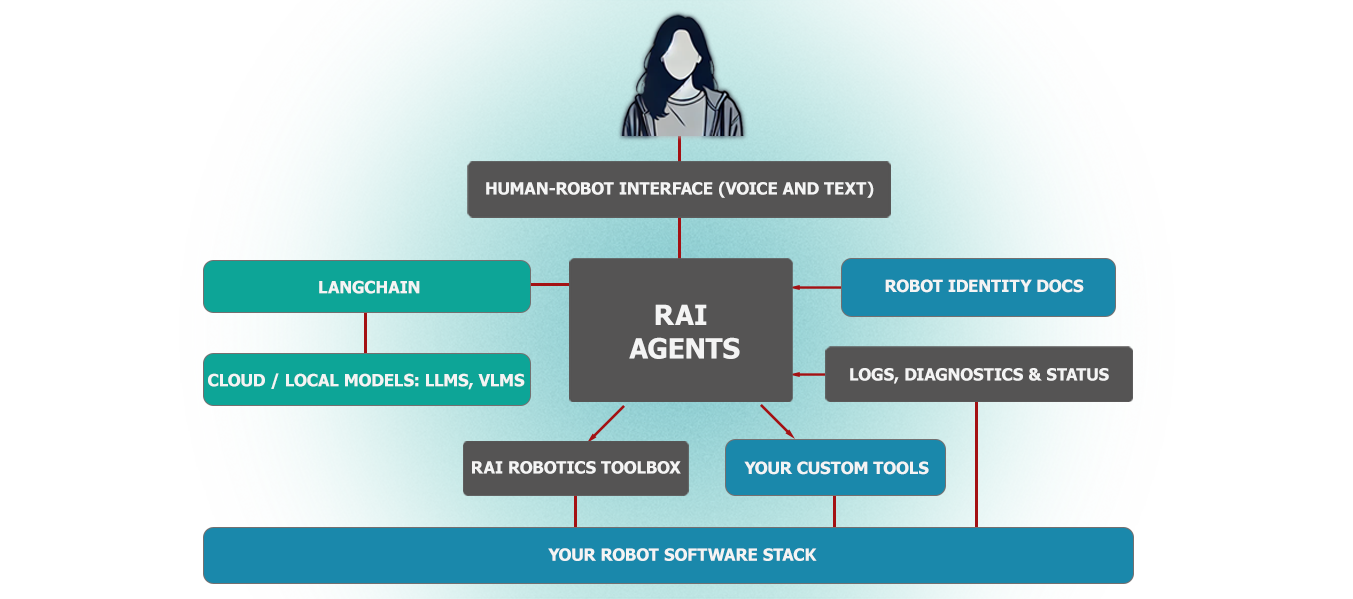
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
具身智能+4具身智能 / VLA
615+1792.12.42026-11-09 14:08 UTC
RoboBrain
FlagOpen·Python

面向机器人操作任务的统一大脑模型,把抽象指令逐步落到具体动作,配套官方推理代码,可直接用于具身智能研究。

具身智能+4具身智能 / VLA
568442025-10-13 04:14 UTC
Awesome-Embodied-AI
haoranD

整理具身智能方向的论文与行业资源清单,覆盖检测、导航、语言学习等主题,方便快速定位相关研究。

具身智能+4具身智能 / VLA
539292025-06-03 15:13 UTC
awesome-vla-for-ad
worldbench·HTML

汇总自动驾驶领域的视觉-语言-动作(VLA)模型资源,梳理其发展脉络与未来方向,方便快速了解该方向的研究与落地进展。

自动驾驶+4自动驾驶
524602026-11-06 04:53 UTC
VAGEN
mll-lab-nu·Python

面向多轮视觉语言模型智能体的世界模型强化学习框架,让 VLM Agent 在交互中通过 RL 训练提升多轮决策能力。
世界模型+4具身智能 / VLA
522+263v25.12.302026-10-29 10:15 UTC
GroundingPI
groundingpi·Python

一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。
视觉定位+4具身智能 / VLA
421+38142026-10-31 13:19 UTC
robonix
syswonder·Rust

面向机器人的智能体操作系统,用 Rust 编写,把 VLM/VLA 模型和 Skill-MD 技能编排成可执行任务,让机器人具备自主决策与操作能力。
机器人操作系统+4具身智能 / VLA
412+260v1.1.02026-11-10 11:23 UTC
habitat-gs
zju3dv·C++

基于动态高斯泼溅的高保真导航仿真器,为具身导航和视觉语言导航研究提供逼真的三维场景与动态人体渲染。
导航仿真器+4具身智能 / VLA
338+1202026-10-13 05:33 UTC
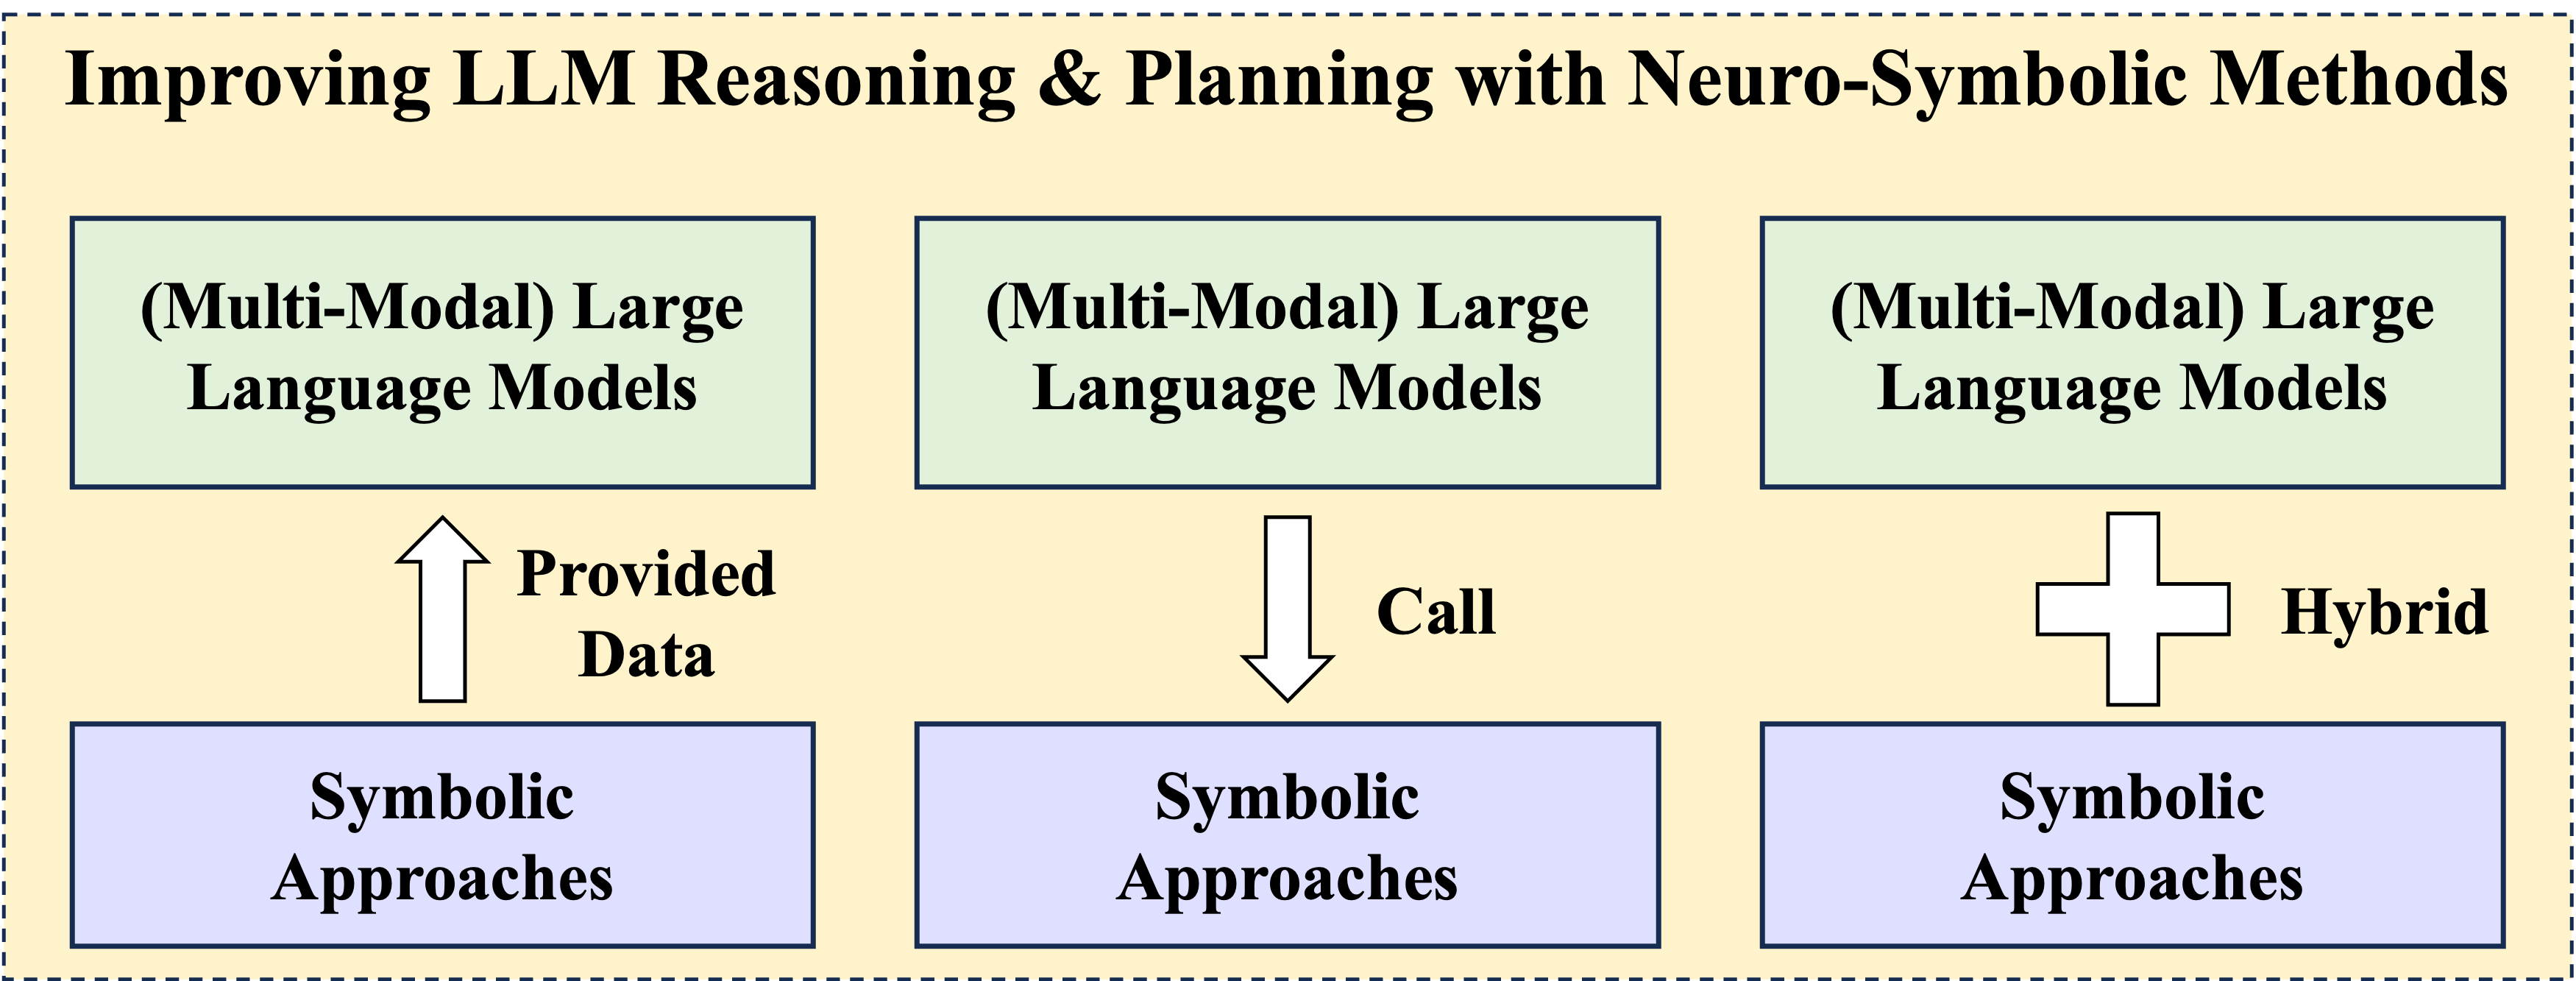
Awesome-LLM-Reasoning-with-NeSy
LAMDA-NeSy

汇总大语言模型时代神经符号学习的最新进展,涵盖一阶逻辑、逻辑编程、知识图谱与具身智能等方向,帮研究者快速跟进这个交叉领域的论文与资源。

神经符号学习+4具身智能 / VLA
335302025-06-19 11:31 UTC
solo-cli
GetSoloTech·Python

面向物理 AI 的命令行工具,把 VLA、VLM、WAM 等机器人多模态模型串起来,方便在 NVIDIA、Nebius 环境里做模型部署和对话机器人调试。

物理AI+4具身智能 / VLA
30244v1.0.02026-04-11 04:18 UTC
OmTrackVLA
om-ai-lab·Python

面向视觉-语言-动作模型(VLA)的可复现开源研究项目,聚焦目标跟踪类 VLA,提供训练与评测代码,方便复现和对比实验结果。

视觉语言动作模型+4具身智能 / VLA
289162026-07-21 05:58 UTC