标签:CUDA
技术标签,共 102 个项目。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。
面向大语言模型的高吞吐、低显存推理与服务引擎,通过 PagedAttention 等优化显著提升并发吞吐并降低显存占用,适合部署在线推理服务。

开源 AI 语音工作室,支持声音克隆、语音听写和语音生成,基于 Qwen3-TTS 与 Whisper,可在 CUDA 或 MLX 上本地运行。
高性能大模型与多模态模型推理服务框架,通过优化注意力机制和调度策略提升吞吐与延迟表现,支持 Llama、DeepSeek、MoE 等主流模型部署。
用多分辨率哈希编码把 NeRF、SDF 等神经图形基元的训练从几小时压到几秒,实时渲染三维场景。
Rust 写的张量库和深度学习框架,兼顾灵活性与效率,支持自动微分、跨平台后端和内核融合,可训练和部署神经网络。
Kaldi 是经典的语音识别工具库,提供声学建模、解码和说话人识别等完整流程,适合搭建语音转文字与说话人验证系统。
用 Python API 定义大模型,并借助 TensorRT 在 NVIDIA GPU 上做极致优化推理,还提供 Python/C++ 运行时来编排高性能服务。
Open3D 是一个现代 3D 数据处理库,提供点云、网格、RGB-D 和 3D 可视化等算法与工具,支持 C++ 和 Python,可用于 3D 感知、重建与机器学习研究。

给 LLM 推理加速的 KV Cache 层,可对接 vLLM 等框架,复用和缓存键值对来降低显存占用、提升吞吐,支持 CUDA 和 ROCm。
把机器学习模型打包成标准 Docker 容器,自动生成 HTTP 推理服务接口,省去自己写 Dockerfile 和部署脚本的麻烦。
用 Go 语言调用 OpenCV 做计算机视觉的封装库,支持 DNN 推理、CUDA 加速、OpenVINO 和扩展模块,省去写 C++ 胶水代码的麻烦。
像 htop 一样在终端里实时查看 NVIDIA GPU 的进程占用、显存和利用率,还能导出指标接入 Grafana 做监控面板。

面向 LLM 推理服务的高性能 CUDA 内核库,提供注意力、MoE 等算子的 JIT 实现,用来加速 GPU 上的大模型推理。
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
NVIDIA 官方多 GPU 集合通信库,提供 all-reduce、broadcast 等优化通信原语,是分布式深度学习训练中跨卡数据同步的底层依赖。

基于 PyTorch 的 3D 深度学习加速库,提供可微渲染、光照、相机 API 和物理仿真等模块,帮研究者快速搭建 3D 重建与神经渲染实验。
面向 Transformer 模型的高性能推理引擎,用 C++ 实现并支持 CUDA、AVX、NEON 等硬件加速,让机器翻译等模型在 CPU/GPU 上跑得更快、显存占用更低。
极快的 C++/CUDA 神经网络框架,专为 MLP 等小网络在 GPU 上训练和推理加速,常用于 NeRF 等实时渲染场景。

基于 MLIR 的可重定向机器学习编译器与运行时工具包,把 PyTorch、TensorFlow、JAX、ONNX 等模型编译到 CPU、CUDA、ROCm、Vulkan 等多种硬件上运行。
量化注意力算子库,在语言、图像、视频模型上比 FlashAttention 快 2-5 倍且不损失端到端精度,可直接替换加速推理。

一个原生桌面应用,把 3D Gaussian Splatting 场景的训练、查看、编辑、自动化和导出都集成在一起,省去在多个工具间来回切换的麻烦。

自托管的本地 NVR 与 AI 视觉监控软件,支持目标检测、移动侦测、人脸识别和车牌识别,可接入 IP 摄像头并利用 Coral、CUDA 等硬件加速,数据不出本地。
系统梳理 GPU 架构、CUDA 编程、大模型基础与 AI Agent 的入门知识库,帮开发者补齐 AI 基础设施底层原理。
用容器方式在本地跑 AI 模型推理的开发工具,屏蔽不同模型来源和硬件差异,一条命令就能起服务并用于生产。
PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。
把 PyTorch、TorchScript 和 FX 模型编译成 TensorRT 引擎,在 NVIDIA GPU 上做推理加速,省去手写 TensorRT 网络的麻烦。
在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。
GPU 加速的图像处理与计算机视觉库,专为云端大规模负载设计,用 CUDA 把预处理和视觉算子跑在 GPU 上,缓解 CPU 瓶颈。

汇集计算机视觉方向的实战项目合集,覆盖 Python、C++、CUDA 和嵌入式部署,方便直接上手跑通检测、识别等模型并落地到 TensorRT 等推理环境。
让大参数 Qwen 模型在消费级显卡上跑得动、跑得快:通过 vLLM 补丁和重量化流水线,单张 24GB 卡即可服务 27B 模型,并附完整基准测试。
把远程机器上的 GPU 通过 IP 网络桥接给只有 CPU 的机器使用,让无显卡设备也能跑 CUDA 计算和推理任务。
跨厂商 3D 高斯泼溅训练器,能把视频转成 splat 再生成网格,支持 Vulkan 或 CUDA 后端,并带量化训练加速。
在 Node.js 里直接跑 llama.cpp 的绑定库,支持 GPU 加速和 GGUF 模型,还能在生成阶段强制模型按 JSON Schema 输出,方便做结构化抽取和函数调用。
把 YOLO 系列模型接入 NVIDIA DeepStream SDK 的推理实现,支持 Darknet、PyTorch、Paddle 等多种权重格式,方便在 Jetson 和 GPU 上做实时目标检测部署。
开源推理研究平台,用于在 AMD、CUDA 等不同 GPU 上对 LLM 推理服务做基准测试和性能对比,帮团队选型加速卡。
开箱即用的扩散模型推理加速库,兼容 Diffusers 和 ComfyUI,通过编译优化和 LoRA 支持显著提升图像生成速度。
实时稠密视觉 SLAM 系统,用 RGB-D 相机在线重建房间级三维场景,适合做实时建图与稠密重建研究。
面向大规模部署的 LLM 推理引擎,支持 CUDA、ROCm、TPU、Inferentia 等多种硬件后端,并提供 LoRA 与投机解码等加速能力。
面向 GPU 工作负载的无服务器平台,可快速部署推理服务、沙箱和后台任务,按需自动扩缩容,省去自建集群的运维成本。
Datawhale 与 SGLang 官方合作的 LLM 推理课程,从零手写 mini-sglang 理解推理原理,再读真实源码并完成第一个 PR。
面向 Tenstorrent 加速卡的 TT-NN 算子库和 TT-Metalium 底层内核编程模型,让大模型和图像生成模型能在非 GPU 硬件上高效推理。
面向交互式超级智能系统的高性能推理服务运行时,支持语音识别、音频与音乐生成等多模态模型,并提供 OpenAI 兼容 API。
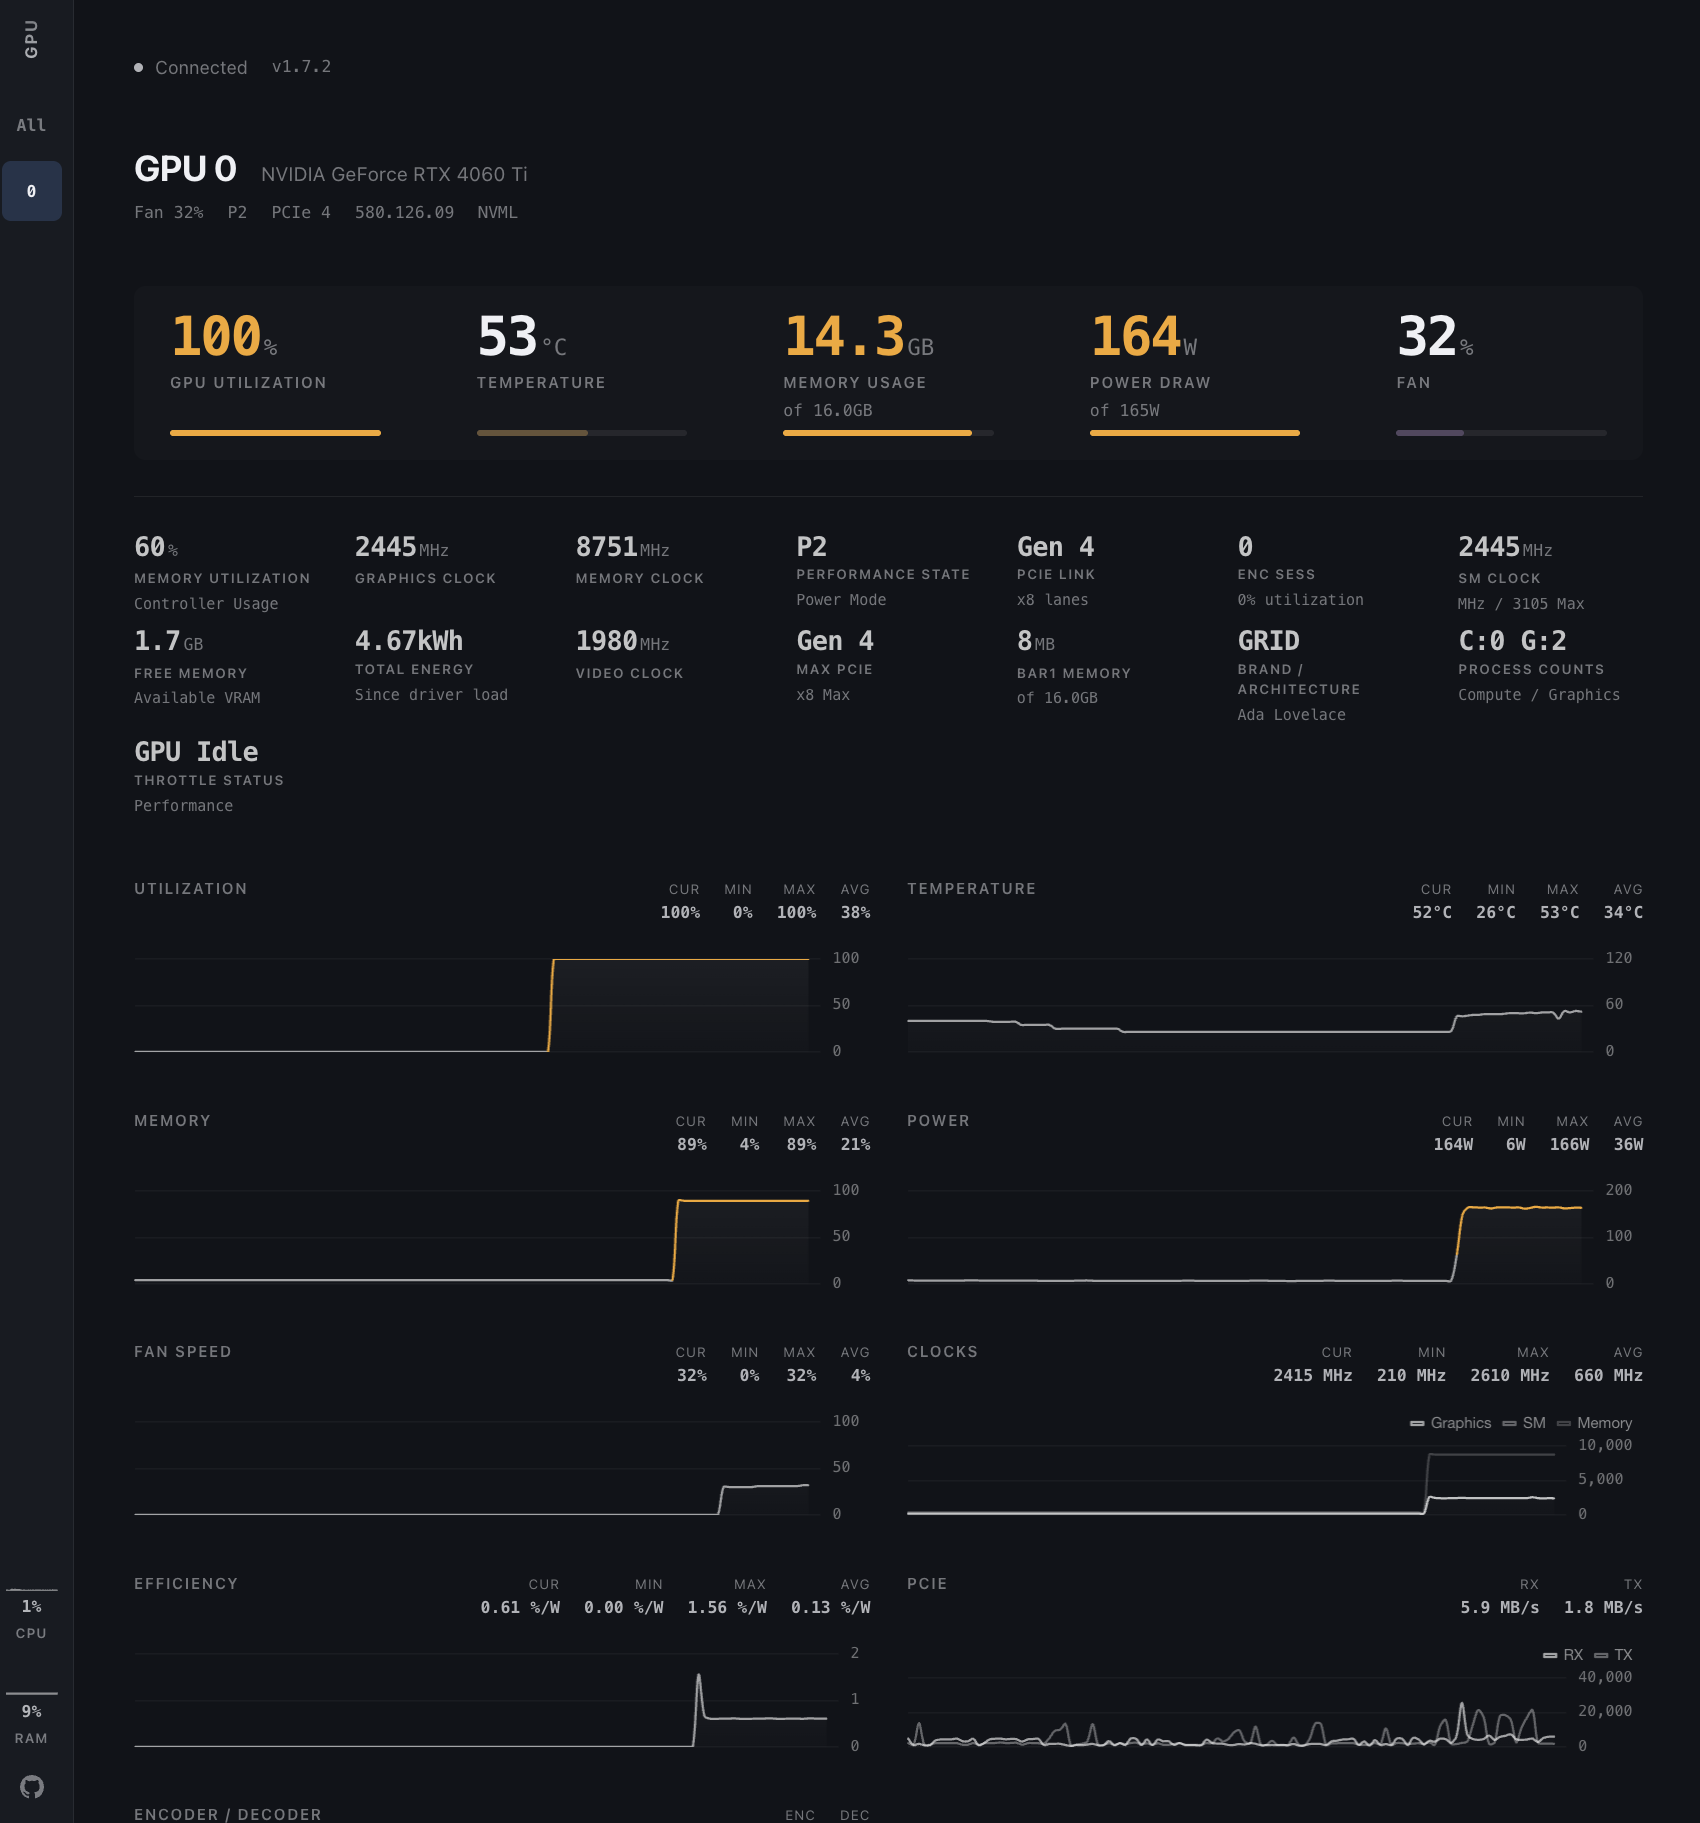
实时监控 NVIDIA GPU 的 Web 仪表盘,用图表展示显存、利用率、温度等指标,方便运维和 MLOps 排查显卡状态。
自托管 Chatterbox 语音合成模型的服务端,带 Web 界面和 OpenAI 兼容 API,支持预置音色、声音克隆和长篇有声书文本处理,可在 NVIDIA、AMD 和 CPU 上加速运行。
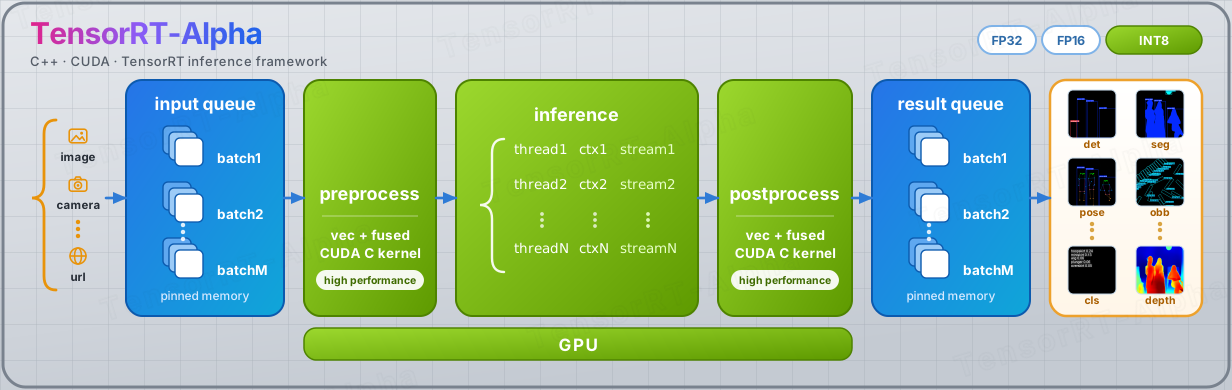
基于 TensorRT 和 CUDA 加速 YOLO 系列模型部署的 C++ 示例库,覆盖检测、姿态、分割、深度估计、OBB 和分类等任务,帮你在 NVIDIA 显卡上把推理跑得更快。
用 C++ 和 CUDA 手写一个高性能 LLM 推理引擎的教学项目,是 vLLM 的精简版,涵盖 PagedAttention 和连续批处理等核心机制。

提供 CUDA 加速的机器学习与信息检索基础算法和原语,方便快速搭建高性能应用,涵盖最近邻搜索、聚类、线性代数等常用模块。
一门讲高效深度学习系统的课程材料,覆盖 CUDA 编程、分布式训练和推理优化,帮你搞懂怎么把模型训得更快、跑得更省。
跨平台多媒体处理框架,支持 GPU 加速和异构调度,可把转码、AI 推理、算法模块和直播流处理串成一条流水线。
为 Jetson Nano 准备的 Ubuntu 20.04 系统镜像,预装 CUDA、OpenCV、PyTorch、TensorFlow、TensorRT 等深度学习环境,省去在边缘设备上手动配置的麻烦。
面向吞吐量优化的高性能 LLM 服务框架,通过 CUDA 加速提升大模型推理的并发处理能力。
面向 Llama 及其变体的大模型推理加速引擎,用 CUDA 和 C++ 做底层优化,主打高吞吐低延迟的模型服务部署。
基于 GPU 的向量检索与聚类库,为近似最近邻搜索和相似度计算提供 CUDA 加速,适合大规模向量数据和 LLM 检索场景。
基于 Python 的视频分析与计算机视觉框架,内置 NVIDIA DeepStream 和 CUDA 支持,可在边缘设备上快速搭建目标检测、实例分割等推理流水线。
C++ 编写的三维几何处理 SDK,提供网格布尔运算、修复、简化、重网格化、偏移、点云三角化和 ICP 配准,并带 Python、C#、C 和 JavaScript 绑定。

用 Python 写的高性能视觉库,把图像预处理、增强和 GPU 加速封装成简洁 API,省去重复样板代码,让研究者专注模型实验。
汇集大模型、视觉语言模型、视觉语言动作模型与 AIGC 相关的优质开源项目、数据集和应用,帮开发者快速找到所需资源。

完全本地运行的私密语音转文字应用,支持多种模型后端、说话人分离和日历模式,覆盖 Windows、macOS 和 Linux。
纯 Rust + CUDA 实现的大模型推理引擎,不依赖 PyTorch,兼容 OpenAI 接口,可部署 Qwen3 到 Kimi-K2 等模型。
共 102 个,这里展示前 60 个。