视觉与 3D
464 个仓库检测、分割、3D 重建与定位。
汇总 ICCV 2023–2025 三届顶会的计算机视觉论文,附代码链接,方便快速追踪 3D 重建、人脸识别等方向的最新研究。
面向自动驾驶场景的 3D 目标检测开源实现,基于深度学习的点云与图像融合方法,可用于训练和评测车辆、行人等目标的立体检测模型。
用 Python 做点击流和事件日志分析的工具包,支持用户旅程、行为分群、A/B 测试和马尔可夫链模拟,还能让 AI 代理复现并交叉验证分析结果。
Niantic 开源的 3D 高斯泼溅压缩文件格式,体积比 PLY 小约 10 倍,视觉质量几乎无损,适合存储和分发大规模 3DGS 场景。
FasterViT 是 NVIDIA 提出的高效视觉主干网络,通过分层注意力机制在 ImageNet 分类、COCO 检测和 ADE20K 分割上兼顾精度与推理速度。
基于 CNN 的音频分割工具包,能自动切分语音、音乐和噪声片段,并识别说话人性别,适合大规模按性别统计发言时长的研究。
基于 PyTorch 的医学图像分割非官方实现,支持 2D 和 3D 数据,方便快速搭建和训练分割模型。
紧耦合多传感器融合 SLAM 框架,在传感器退化与时空扰动下仍能稳定运行,适合机器人和自动驾驶的定位建图。

汇总 CARLA 自动驾驶仿真器的教程、博客、代码和数据资源,帮研究者快速上手仿真环境与数据采集。
面向人的深度学习实用工具库,封装了 3D 目标检测、分割、传感器融合和视频合成等常用功能,省去重复造轮子。
面向医学影像的智能标注与主动学习工具,在 3D Slicer 等客户端里边标注边训练模型,减少人工勾画工作量。
把 VGGT 扩展到公里级场景的官方实现,解决超长序列三维重建中显存和尺度爆炸的问题,能处理大规模空间数据。
用点、线、面、消失点等结构化几何特征做三维视觉建图、定位和 SfM 的 C++ 工具箱,弥补纯点特征在低纹理场景下的不足。
用 2D 高斯建模做连续超分辨率,把像素映射成高斯表示,实现超快任意尺度放大,适合需要实时连续超分的场景。
精选 CVPR 2025 最具影响力的计算机视觉论文合集,每篇附论文、代码和演示,方便快速跟进检测、分割、多模态等方向的前沿工作。
基于 PyTorch 的通用分割精修网络,通过全局与局部级联细化,把任意已有分割掩码提升到超高分辨率,无需针对特定类别重训。

把 3D 高斯泼溅烘焙进扩散去噪器,单阶段从单张图快速生成和重建可扩展的 3D 场景与网格,免去多阶段流程。
基于 Python 的视频分析与计算机视觉框架,内置 NVIDIA DeepStream 和 CUDA 支持,可在边缘设备上快速搭建目标检测、实例分割等推理流水线。
基于 LIO-SAM 改造的激光惯性 SLAM 方案,支持 6 轴 IMU 和 GNSS 融合,解决低成本 6 轴 IMU 无法直接跑原版 LIO-SAM 的问题。
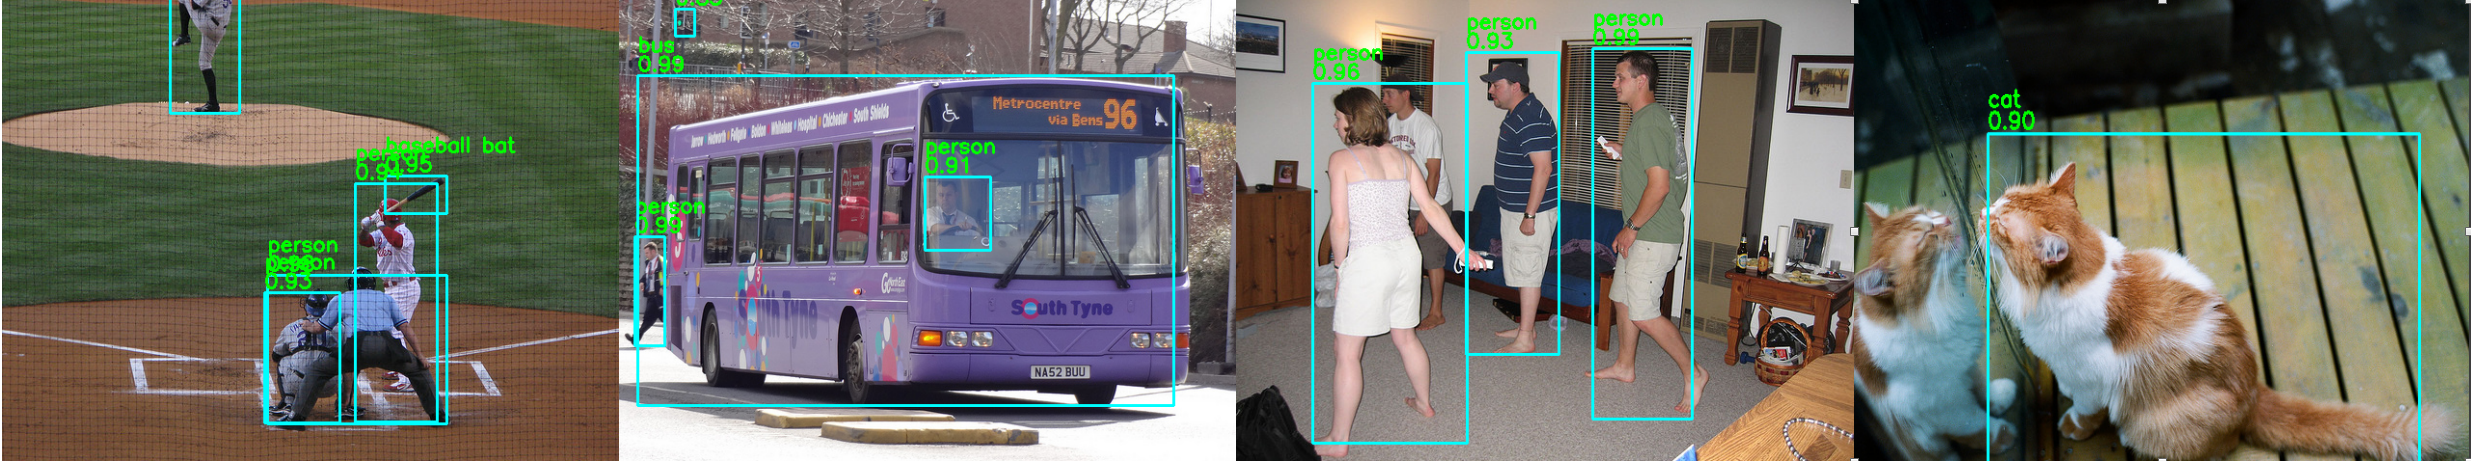
超轻量无锚框目标检测算法,权重仅 250K 参数,比 yolo-fastest 快 10%,后处理更简单,适合边缘设备部署。
用 C 和 CUDA 写的 YOLO 目标检测框架,能在本地训练和推理,适合需要轻量、可嵌入的实时检测场景。
可见光-红外成对图像数据集,专为低光照视觉任务设计,可用于图像融合、图像翻译和目标检测等模型的训练与评测。
基于 .NET 8 的 C# 视觉推理库,用 ONNX Runtime 或 TensorRT 跑 YOLO 模型,支持图像和实时视频的分类、检测、OBB、分割与姿态估计。
DIPY 是 Python 的 3D/4D 医学影像处理库,覆盖扩散、灌注与结构成像,提供配准、去噪、机器学习和可视化等通用方法。