视觉与 3D
464 个仓库检测、分割、3D 重建与定位。

基于 HMM 与熵率计算的快速中文分词与词性标注工具,用 Java 实现,适合需要轻量级 NLP 解析的工程场景。
基于点、线、面特征的稀疏视觉 SLAM 系统,支持单目、RGB-D 和双目相机,在保持建图与定位精度的同时提升效率。
SuperVINS 是面向弱光、低纹理等恶劣成像条件的实时视觉惯性 SLAM 框架,把深度学习特征点融入传统 VINS 流程,提升跟踪鲁棒性。
面向无人机集群的去中心化激光雷达惯性里程计,让多机在无中心节点的情况下高效完成协同定位与建图。
把一句文字提示变成可编辑的参数化 3D 程序,而不是死模型,方便后续改尺寸、换材质和加关节,适合 CAD 与机器人场景。
浏览器里就能用的媒体编辑器,支持 3D 模型、高斯泼溅、Lottie 动画和时间线合成,给创意工具提供可被智能体调用的底层基础。

基于 PyQt5 的图形界面工具,用 YOLO 系列模型做目标检测、跟踪、实例分割和人体姿态估计,支持图片、视频和摄像头输入。
低成本地面机器人 SLAM 系统,融合多传感器,在弱纹理、剧烈运动等极端场景下仍能稳定定位建图。
Patchwork++ 的 ROS/ROS2 封装,用于激光雷达点云的快速地面分割与地面点剔除,方便直接接入机器人感知流程。

一套用 C++ 上手和实验 SLAM 的工具集,涵盖特征匹配、因子图优化、回环检测与三维可视化,方便快速搭建和调试视觉 SLAM 原型。
面向嵌入式设备的开源 AI 模型训练与部署工具,支持在 ESP32、Jetson、树莓派等硬件上完成图像分类、目标检测等任务的训练与推理。
面向动态环境的视觉惯性 SLAM 系统,能在场景中存在移动物体时稳定完成定位与建图,适合机器人在人群或杂乱环境中使用。
跨平台计算机视觉标注工具,集成 Grounding DINO 与 SAM 实现自动预标注,支持目标检测和旋转框标注,大幅减少手工画框工作量。

基于 ROS 2 的紧耦合激光雷达惯性 SLAM 包,融合 NDT/GICP 点云配准与 IMU 数据,用于机器人在复杂环境中的实时定位与建图。
基于 OpenPifPaf 人体姿态估计模型做跌倒检测,结合目标跟踪分析视频中的人体关键点,判断是否发生摔倒,可在 CPU 或 GPU 上运行。
QGIS 插件,用 Segment Anything Model 在地理栅格影像上快速分割和勾绘地貌,省去手工描边的麻烦。
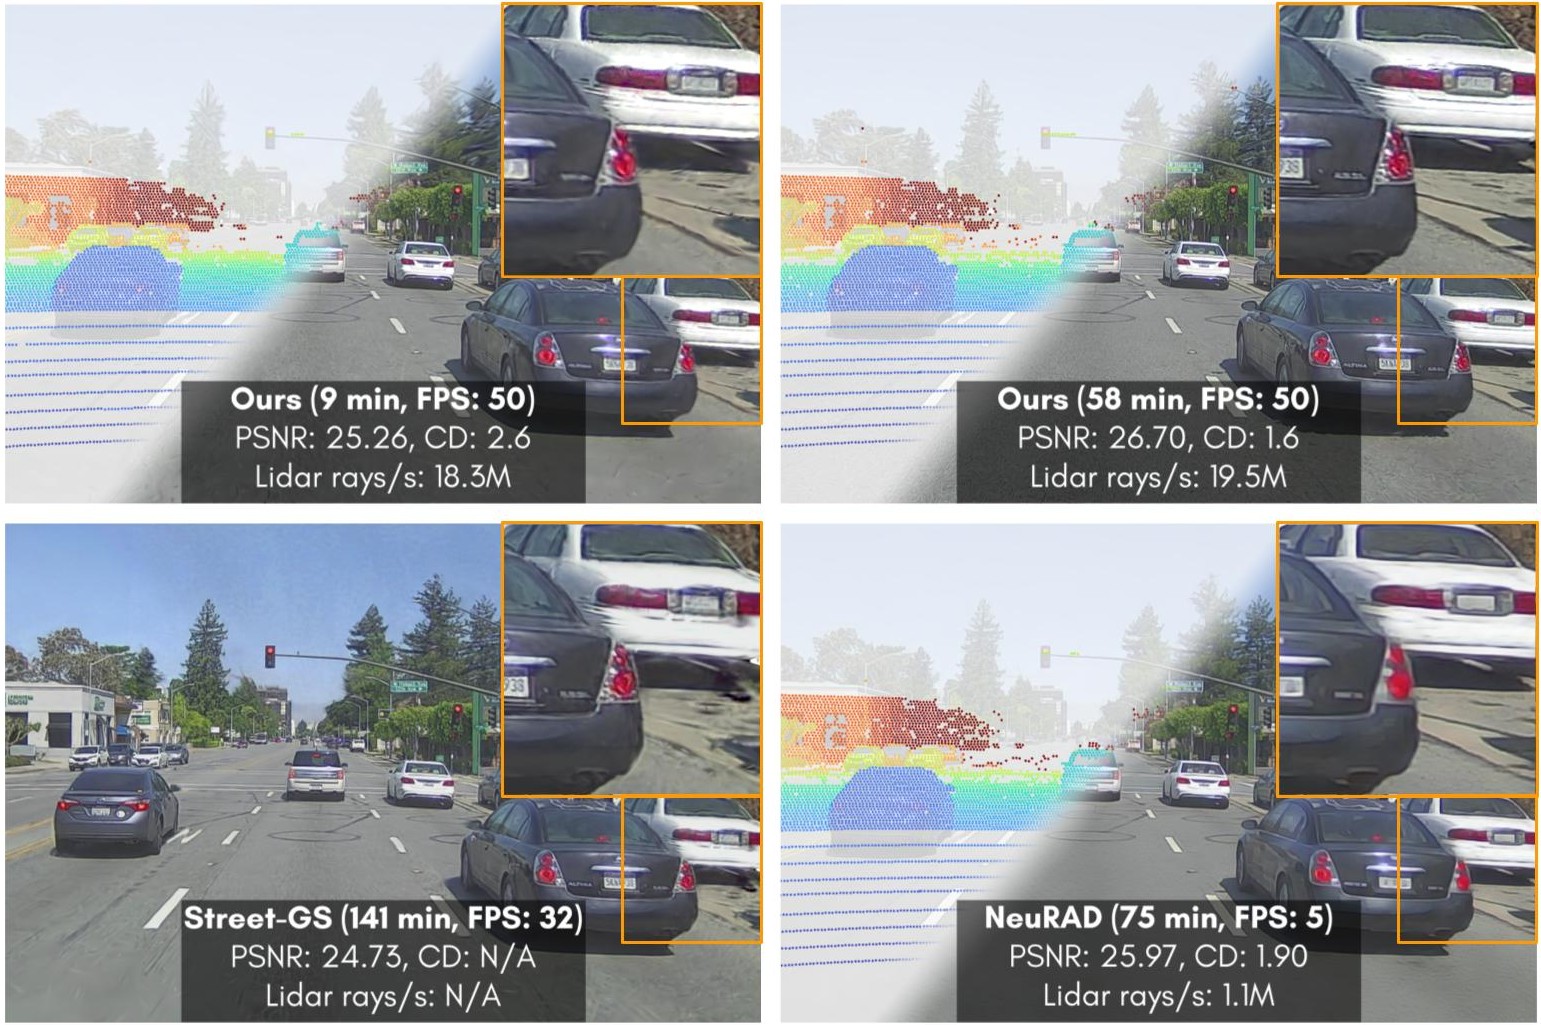
用 3D 高斯泼溅实现自动驾驶场景下激光雷达与相机数据的实时渲染,为感知算法提供高保真仿真环境。
把 SAM、MobileSAM、EfficientSAM、SAM 2/2.1 和 SAM 3 导出成 ONNX 模型,方便在任意平台跑可移植的图像分割,不用绑死原始框架。
基于 Viterbi 算法的日语分词器,用 Rust 实现,适合需要高性能形态素分析的 NLP 场景。
重构版高斯泼溅训练代码库,50 秒即可完成 3DGS 训练,适合快速迭代三维重建实验。
一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。
基于零样本分割模型实现任意图像抠图,无需针对特定类别训练即可提取前景透明通道,适合快速落地通用抠图需求。
轻量级卡尔曼滤波 Python 库,用于视觉定位、里程计和 SLAM 中的状态估计与传感器数据融合。
单张图片一次前向即可重建画面中多人的 SMPL-X 三维人体网格与姿态,提供 PyTorch 推理代码和预训练模型,适合做多人姿态估计与人体重建的落地验证。