硬件与机器人
共 51 个仓库 · Python
用点式隐式神经表示做 LiDAR SLAM,在保持全局地图一致性的同时完成定位与建图,适合机器人和 3D 建图场景。

在瑞芯微 NPU 上跑大模型的推理服务,类似 Ollama 的替代方案,通过优化 rkllm 让 Orange Pi 等设备高效离线运行 AI 模型。
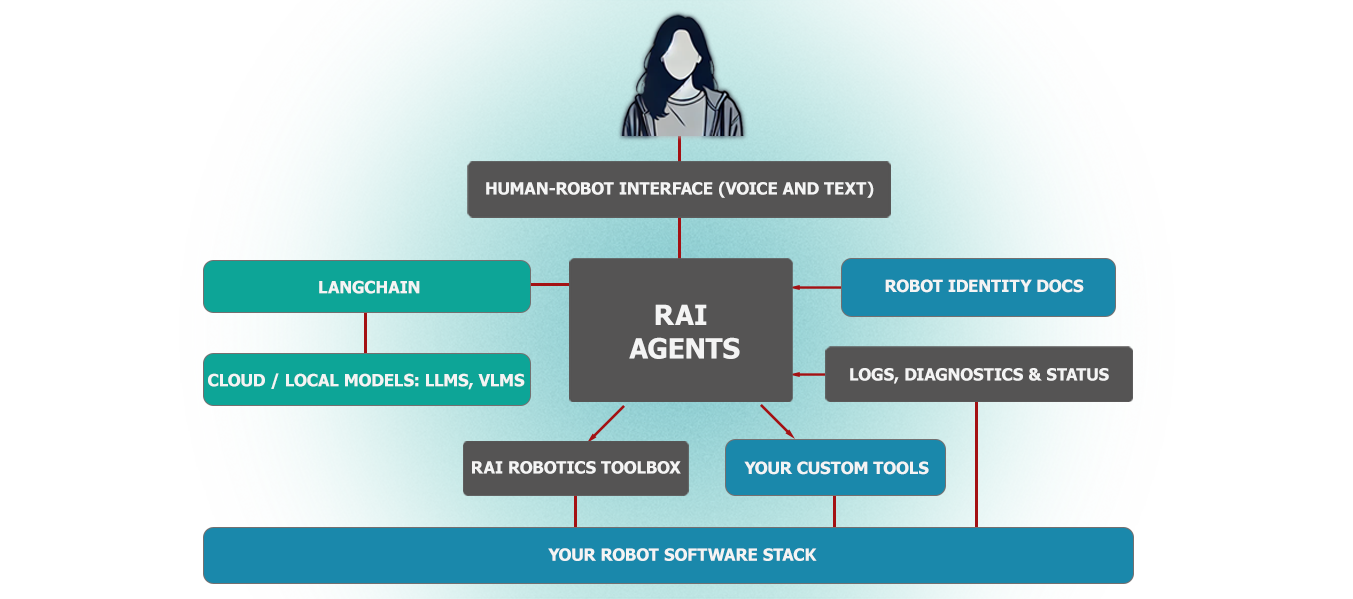
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。

自托管的 AI Agent 操作系统,把记忆、聊天、Agent 和文件都留在自己的硬件上,默认离线运行,还能把树莓派、Mac mini、游戏 PC 自动组集群。
一套统一的视觉 SLAM 评测框架,把主流 VSLAM 系统和公开数据集整合到同一套流程里,省去逐个配置环境、跑对比实验的麻烦。
面向机器人操作任务的统一大脑模型,把抽象指令逐步落到具体动作,配套官方推理代码,可直接用于具身智能研究。
开箱即用的 LiDAR SLAM 系统,用 Python 实现,能直接完成激光雷达建图与定位,省去繁琐配置。
面向多轮视觉语言模型智能体的世界模型强化学习框架,让 VLM Agent 在交互中通过 RL 训练提升多轮决策能力。
仅用一段 MP4 监控录像和对应的谷歌地图位置,就能重建出数字孪生风格的三维交通场景,把画面里的车辆投影到真实地理坐标上。
把视觉语言模型直接改造成机器人操作策略,无需改动架构就能训练出顶尖的视觉-语言-动作模型。
仅靠视觉输入就能完成闭环自动驾驶的视觉-语言-动作模型,把语言理解和驾驶动作对齐,在 CARLA 里做端到端评测。
面向嵌入式设备的开源 AI 模型训练与部署工具,支持在 ESP32、Jetson、树莓派等硬件上完成图像分类、目标检测等任务的训练与推理。

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。
一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。
基于树莓派和 SX1302/SX1303 集中器的开源 LoRa 基站,为 Meshtastic/MeshCore 提供多信道被动抓包、本地仪表盘和原生发射能力。
半监督 LiDAR 语义分割方法,通过激光混合策略利用少量标注数据训练 3D 点云分割模型,提升自动驾驶场景下的分割精度。
把本地 OpenAI 兼容服务(llama.cpp、vLLM、Ollama 等)接入 Home Assistant,让智能家居助手用上自托管大模型做对话。
面向物理 AI 的命令行工具,把 VLA、VLM、WAM 等机器人多模态模型串起来,方便在 NVIDIA、Nebius 环境里做模型部署和对话机器人调试。
面向视觉-语言-动作模型(VLA)的可复现开源研究项目,聚焦目标跟踪类 VLA,提供训练与评测代码,方便复现和对比实验结果。
一份边缘机器学习资源清单,汇总了研究论文、推理引擎、竞赛、书籍和线下活动,方便快速找到在嵌入式与移动端部署模型的相关资料。
RoboRefer 是面向机器人场景的空间指代推理视觉语言模型官方实现,让机器人能理解「把左边那个杯子递给我」这类带空间关系的指令。
给 AI 编程助手加上的拓竹 3D 打印技能:自动找模型、用 CAD 生成设计、检查可打印性,并交给 Bambu Studio 切片、读取打印机和 AMS 状态。
汇总自动驾驶场景生成与分析方向的基础模型论文,涵盖扩散模型、大语言模型和多模态模型,持续更新最新研究进展。
用稀疏视角重建户外场景的神经辐射场方法,面向自动驾驶场景的新视角合成,提供 ICCV'23 论文的 PyTorch 实现与训练代码。