标签:TensorRT
技术标签,共 63 个项目。

基于 PyTorch 的目标检测全家桶,覆盖训练、推理、实例分割、图像分类和模型导出,开箱即用,适合快速落地视觉任务。
NVIDIA 官方的高性能深度学习推理 SDK,能把训练好的模型在 NVIDIA GPU 上做极致加速和部署,适合追求低延迟高吞吐的生产推理场景。
高性能无锚框 YOLO 目标检测器,精度超过 YOLOv3~v5,支持 MegEngine、ONNX、TensorRT、ncnn 和 OpenVINO 多后端部署。

基于 PyTorch 的 YOLOv3 系列实现,覆盖训练、验证、推理全流程,并支持导出 ONNX、CoreML、TensorRT 等多种格式,方便做实时目标检测和边缘部署。

面向 NVIDIA Jetson 嵌入式设备的深度学习推理部署指南,用 TensorRT 加速图像识别等视觉任务,配套教程和预训练模型开箱即用。

基于 ONNX Runtime、OpenVINO、PaddlePaddle 等多家推理后端的 OCR 工具包,支持多语言识别,方便在不同硬件上快速部署文字检测与识别。

提供可插拔的 Python 和 C++ 多目标跟踪模块,集成 BoT-SORT、ByteTrack、OC-SORT 等 SOTA 算法,支持轴对齐与旋转框跟踪。
用 TensorRT 网络定义 API 手写实现 YOLO、ResNet、Swin Transformer 等主流深度学习模型,并附 C++ 推理代码,方便直接部署到 NVIDIA GPU。

从零基础到 CV、NLP、LLM 项目实战再到 ONNX/TensorRT 工程化部署的 PyTorch 中文教程,配套 Jupyter Notebook 边学边练。
一个轻量级 C++ AI 工具包,集成 100+ 模型,支持 MNN、ONNX Runtime 和 TensorRT 推理,覆盖目标检测、分割、Stable Diffusion、人脸融合等任务。

把 OpenAI Whisper 做成近实时的语音转文字服务,支持 TensorRT、OpenVINO、ROCm 等硬件加速,适合直播字幕和听写场景。
提供基于 GPU 加速和微服务架构的生成式 AI 参考工作流,涵盖 RAG、LLM 推理等场景,帮你在 Triton、TensorRT 等基础设施上快速搭建可落地的服务。
把 PyTorch、TorchScript 和 FX 模型编译成 TensorRT 引擎,在 NVIDIA GPU 上做推理加速,省去手写 TensorRT 网络的麻烦。

汇集计算机视觉方向的实战项目合集,覆盖 Python、C++、CUDA 和嵌入式部署,方便直接上手跑通检测、识别等模型并落地到 TensorRT 等推理环境。

基于 C++ 的深度学习服务端与命令行工具,封装 Torch、TensorRT 等后端,通过 REST API 提供图像分类、目标检测、分割和以图搜图能力。
把任意电脑或边缘设备变成计算机视觉推理服务器,一条命令部署目标检测、分类、实例分割等模型,省去自己搭服务的麻烦。
把 YOLO 系列模型接入 NVIDIA DeepStream SDK 的推理实现,支持 Darknet、PyTorch、Paddle 等多种权重格式,方便在 Jetson 和 GPU 上做实时目标检测部署。
一款简单易用、高性能的 AI 部署框架,支持 ONNX Runtime、MNN、昇腾等多种推理后端,用低代码方式把深度学习模型和生成式 AI 应用部署到各类硬件上。
基于 TensorRT 的 YOLO 系列模型部署工具包,支持检测、分割、姿态估计和旋转框检测,帮你在 NVIDIA 显卡上把推理跑得更快更省事。
把 YOLOv8 的检测、分割、姿态模型导出为 ONNX 并用 TensorRT 加速推理,支持 Jetson 和 DeepStream 部署。
在 Jetson 上跑 TensorRT 加速的视觉模型示例集,涵盖 MODNet 抠图、YOLOv3/v4 检测、SSD、MTCNN 人脸和 GoogLeNet,帮你快速部署边缘推理。
BiSeNet 语义分割网络的 PyTorch 实现,支持 Cityscapes、ADE20K、COCO-Stuff 数据集,并提供 ncnn、OpenVINO、TensorRT、Triton 等推理部署方案。
飞桨生态下的模型压缩与架构搜索库,提供剪枝、量化、蒸馏和 NAS 等能力,帮你在部署前把深度模型压小提速。
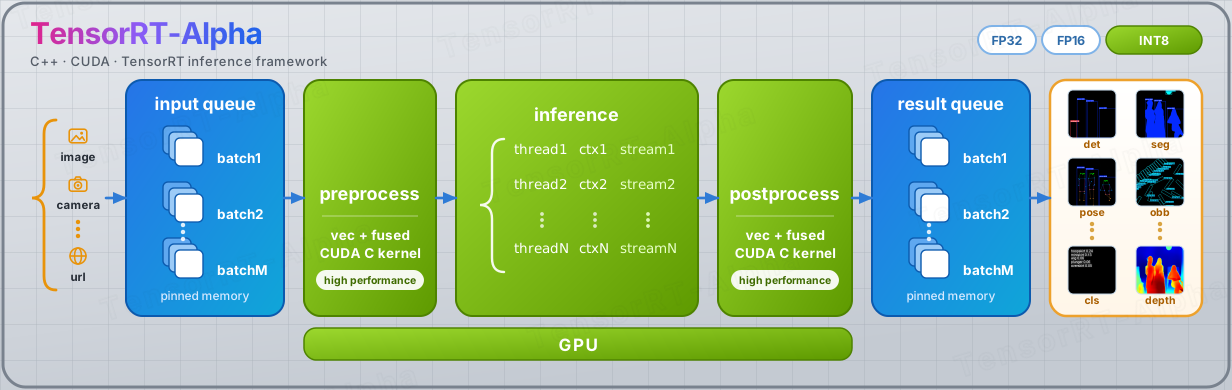
基于 TensorRT 和 CUDA 加速 YOLO 系列模型部署的 C++ 示例库,覆盖检测、姿态、分割、深度估计、OBB 和分类等任务,帮你在 NVIDIA 显卡上把推理跑得更快。
把 YOLO 全系列(v5 到 v12、YOLOX)模型转成 TensorRT 引擎做加速推理,内置 NMS 插件,省去自己写后处理的麻烦。
基于 TensorRT FP16 加速的 PP-OCRv6 推理服务,在 OmnidocBench 上跑出 200+ img/s,提供 HTTP 和 gRPC 接口,适合高吞吐文档解析与 RAG 场景。
从 NLP 基础一路讲到 LLM 微调与部署的算法全栈教程,覆盖 BERT、LLaMA、LoRA 等内容,适合系统入门大模型。
基于 YOLO 系列模型和 TensorRT 加速的 FPS 游戏自动瞄准工具,用 GPU 实时检测画面中的目标并驱动准星移动。
跨平台多媒体处理框架,支持 GPU 加速和异构调度,可把转码、AI 推理、算法模块和直播流处理串成一条流水线。
为 Jetson Nano 准备的 Ubuntu 20.04 系统镜像,预装 CUDA、OpenCV、PyTorch、TensorFlow、TensorRT 等深度学习环境,省去在边缘设备上手动配置的麻烦。
基于 Python 的视频分析与计算机视觉框架,内置 NVIDIA DeepStream 和 CUDA 支持,可在边缘设备上快速搭建目标检测、实例分割等推理流水线。
基于 .NET 8 的 C# 视觉推理库,用 ONNX Runtime 或 TensorRT 跑 YOLO 模型,支持图像和实时视频的分类、检测、OBB、分割与姿态估计。
自动驾驶学习笔记,系统梳理感知、BEV、Transformer、规划控制等模块知识点,并整合行业优秀方案,帮读者快速建立自动驾驶技术体系。
一套 TensorRT C++ API 实战教程,演示如何用 C++ 加载 ONNX 模型并构建高性能推理引擎,适合想在工程里落地 GPU 推理的开发者。
在 mpv 播放器里用轻量超分模型实时把动漫画面放大到 4K,基于 Real-ESRGAN 和 TensorRT 加速,看番时直接获得高清画质。
用 C++ 把 YOLOv8 模型部署到 TensorRT 上做高性能推理,适合需要低延迟目标检测的工程落地场景。
基于 YOLO12 的 AI 瞄准辅助,支持所有 FPS/TPS 游戏,通过 TensorRT、CUDA 或 DirectML 在 GPU 上推理,并配合 Arduino、KMBox 等硬件实现鼠标控制。
把 YOLOv5 模型部署到 TensorRT、LibTorch、ONNX Runtime、TVM、NCNN 等推理后端的运行时工具链,省去自己写适配代码。
把 Depth Anything V3 单目深度估计模型封装成 ROS2 节点,用 TensorRT 加速推理,从相机图像直接输出米制深度图和点云。
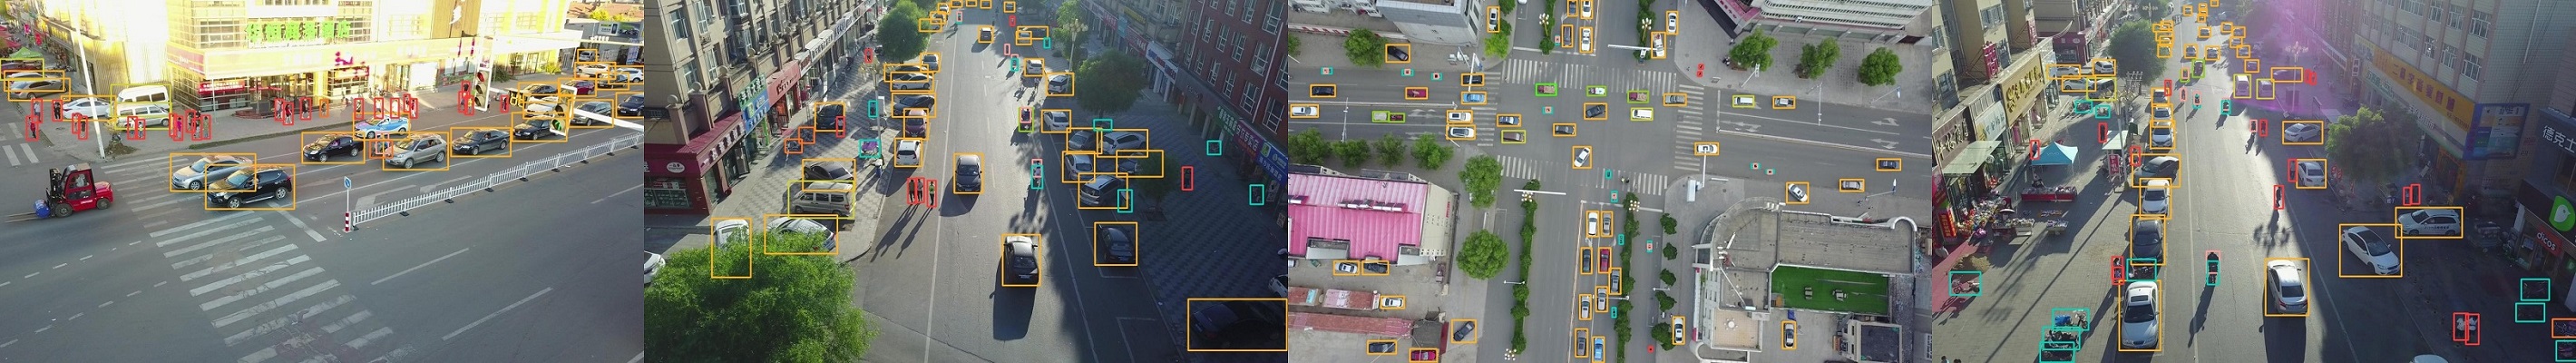
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
收录 CUDA、cuBLAS、CUTLASS、TensorRT-LLM、Triton、TVM、MLIR 等 GPU 加速与高性能计算开源项目的精选清单,方便按方向找底层算子、编译器和推理框架。
基于深度学习与 NVIDIA GPU 加速的 3D 物体位姿估计 ROS/ROS2 包,可在 Jetson 上通过 TensorRT 推理,为机器人抓取和操作提供实时六自由度位姿。
为 VapourSynth 视频处理框架提供 CPU/GPU 高效推理运行时,内置 waifu2x、Real-ESRGAN、RIFE、Real-CUGAN 等超分、降噪、插帧模型,方便在视频后期流程里直接调用。
提供示例应用,演示如何把 TAO 训练的模型部署到 DeepStream 视频分析流水线,覆盖 YOLOv3、RetinaNet、DSSD 等模型。
基于 Rust 和 ONNXRuntime 的计算机视觉与视觉语言模型库,集成 YOLO、FastVLM、OCR、SAM 等模型,方便在 Rust 项目中直接做目标检测、分割和图文理解。
面向 ROS 1/2 的实时 3D 激光雷达障碍物检测工具,集地面分割、聚类、跟踪与轨迹预测于一体,单核 CPU 约 10ms 处理一帧,可选 TensorRT 加速的 CenterPoint。
基于 tensorRT_Pro 扩展的 TensorRT C++ 推理库,集成 YOLO、RT-DETR、PPOCR、车道线检测、深度估计等多类视觉模型,提供高性能部署方案。
把 YOLO11 的检测、姿态估计、分割和跟踪模型用 TensorRT v8.0+ 部署到 C++ 和 Python 接口,省去自己写推理代码的麻烦。
一站式动漫视频增强工具,一次处理即可完成 AI 超分、RIFE 补帧和画质修复,支持命令行、独立程序和 After Effects 插件。
把 YOLOX 目标检测封装成 ROS2 节点,支持 ONNX Runtime、OpenVINO、TensorRT、TFLite 等多种推理后端,方便机器人项目直接接入实时检测。
基于 GStreamer 和 TensorRT 的 GPU 加速实时视频与多传感器分析 SDK,可在边缘、本地和云端搭建多路视频 AI 推理流水线。
面向 NVIDIA GPU 的深度学习推理调优工具包,帮助把训练好的模型调优并部署到 TensorRT、ONNX Runtime 等推理后端上跑得更快。
用 ONNX 模型给视频做超分和插帧的图形界面工具,在 Windows 和 Linux 上通过 TensorRT 或 DirectML 加速推理。
基于 ViTPose 的 2D 人体与动物多姿态估计工具,支持 ONNX、TensorRT 加速,可实时输出多种骨架格式。
用 TensorRT 加速 ComfyUI 的图片放大节点,把 ESRGAN、Real-ESRGAN 等放大模型跑出 2~4 倍速度,适合出图后处理提速。
用 YOLOv8 做检测、ByteTrack 做跟踪的目标跟踪工程,通过 C++ 和 TensorRT 加速推理,适合需要实时多目标跟踪的部署场景。
用 Python 把多路视频流、多个模型和多块 GPU 串起来做实时视频分析,底层靠 CUDA、TensorRT 和 DeepStream 加速,适合搭建高吞吐的视觉推理流水线。
基于 C++/CUDA 的高性能 SDK,把音频实时驱动成 3D 面部表情和口型,内置后处理,适合做虚拟人、数字主播这类实时动画。
一站式实时视觉训练与部署框架,覆盖目标检测、关键点估计、实例与语义分割,支持导出 TensorRT、ONNX、OpenVINO、CoreML 到边缘设备。
用 Rust 封装 ONNX Runtime 跑 Ultralytics YOLO 推理,支持 CUDA、CoreML、OpenVINO 等 GPU 后端,还带命令行和 WebGPU/WASM,方便在本地或浏览器里做目标检测、分割、姿态估计。
共 63 个,这里展示前 60 个。