视觉与 3D
464 个仓库检测、分割、3D 重建与定位。
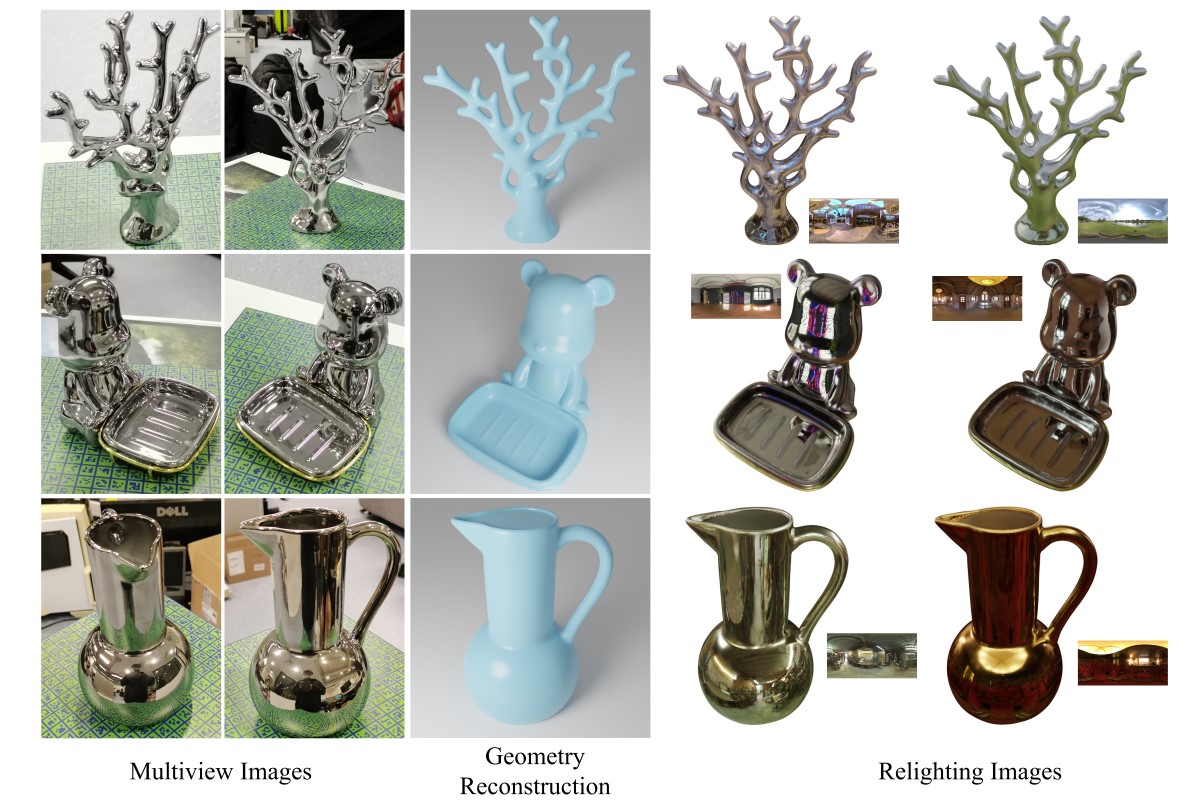
从多视角图像重建高反射物体的神经几何与BRDF,解决反光表面难以准确建模和渲染的问题。
面向 AR/VR 的视觉惯性 SLAM 工具箱与基准测试,提供可直接运行的 VIO/SLAM 实现和评测流程,方便对比算法效果。
面向计算机视觉的高性能图像增强库,支持分类、分割、检测等任务,可同步变换边界框和掩码,适合深度学习训练数据扩增。
用轨迹场把任意视频表示为 4D 结构,从普通视频中重建出带时间维度的三维场景,适合做动态场景的 4D 重建研究。
原生多模态大模型,把文本和图像统一到 3D 生成与理解任务中,支持文生 3D、图生 3D、3D 描述和编辑。
一套统一的视觉 SLAM 评测框架,把主流 VSLAM 系统和公开数据集整合到同一套流程里,省去逐个配置环境、跑对比实验的麻烦。
从多视角立体视觉出发,前馈式快速重建可泛化的高斯泼溅表示,无需逐场景优化即可合成新视角。

实时 SLAM 系统,融合点、线特征、体素建图与 3D 无监督增量分割,适合需要边建图边分割的机器人或 AR 场景。
统一模型,从单目视频中同时重建动态人体与三维场景,输出带时间维度的4D结果,可用于人体姿态估计与场景理解。
用深度学习和传统手工特征做多视图图像匹配,为 COLMAP 等 SfM 软件提供高质量匹配结果,支持高分辨率图像和带旋转的图像,提供命令行和图形界面。
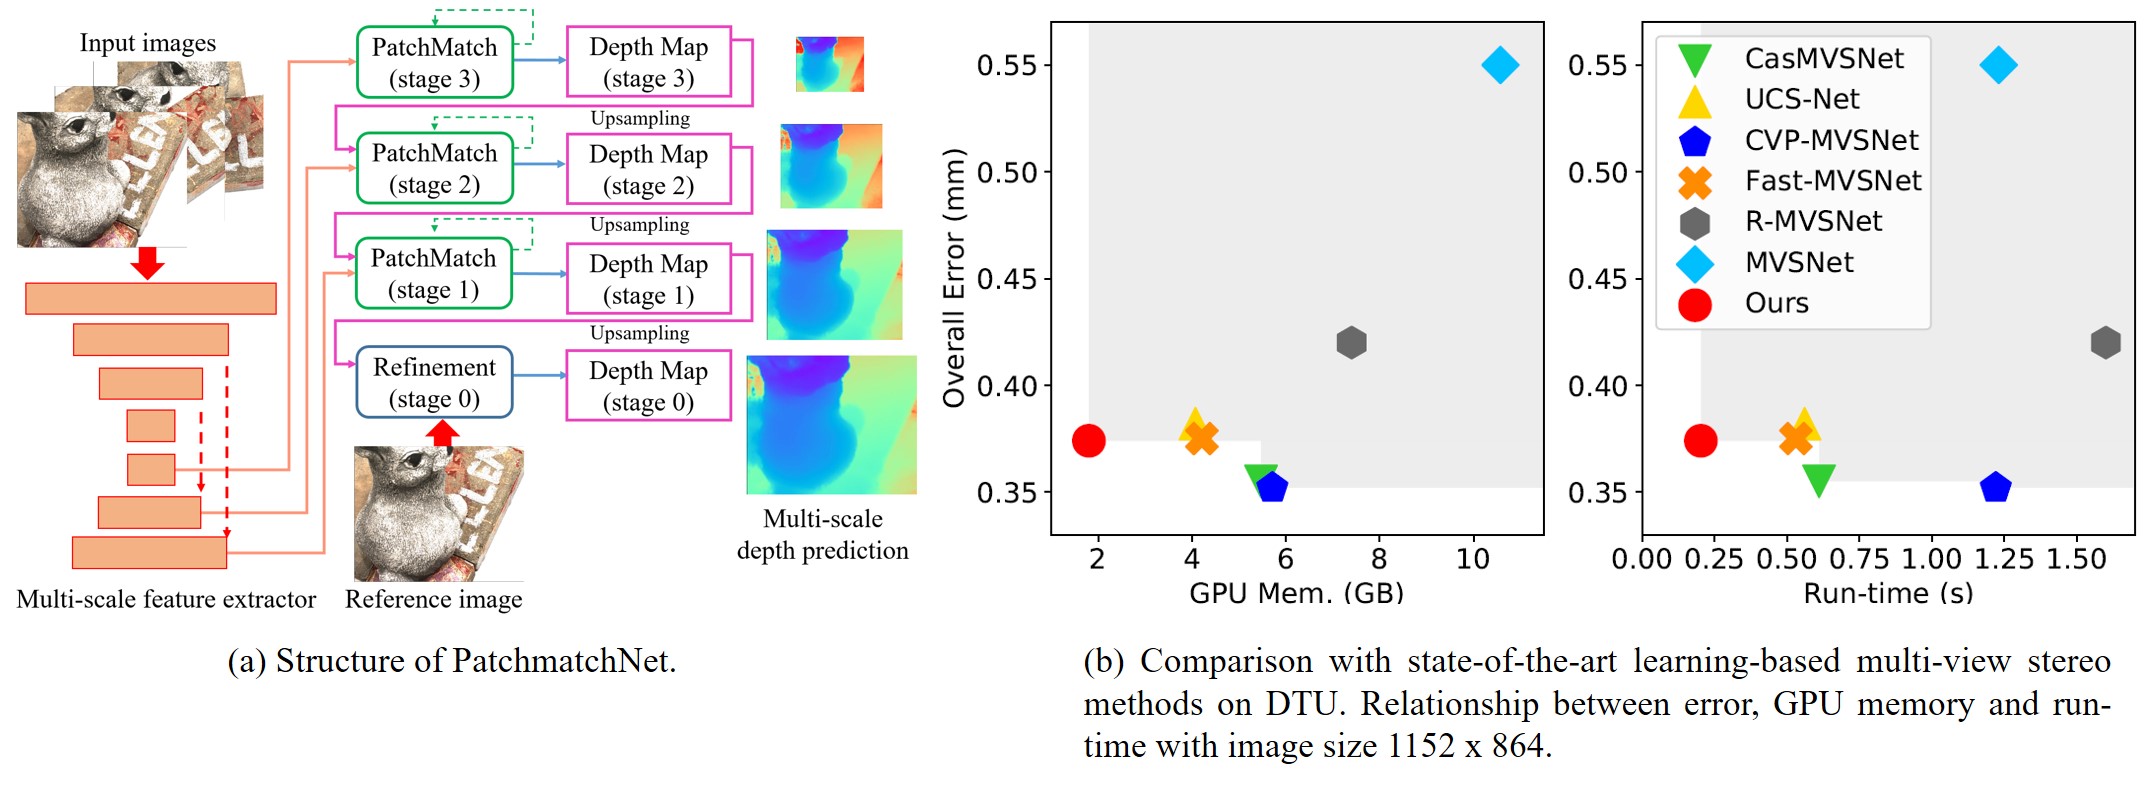
PatchmatchNet 是 CVPR 2021 Oral 的官方实现,用可学习的 Patchmatch 做多视图立体匹配,从多张图片重建稠密三维点云。
RectLabel 是一款离线图像标注工具,用于给目标检测和分割任务画框、打标签、生成掩码,支持 Faster R-CNN、Mask R-CNN、Detectron 等格式。
在 Blender 里轻量查看高斯泼溅数据、设计相机运动轨迹,并把配置导出给外部高斯渲染器使用。
从单张图片生成多视角一致图像,进而重建完整三维场景,解决单视图场景重建中视角覆盖不足的问题。
面向大规模场景的可扩展测试时训练 3D 重建方案,通过在线自适应提升深度估计与重建精度,适合处理超长序列和大范围场景。

把 Webots 机器人仿真器和 ROS 2 打通的官方软件包,提供示例、定位、导航、SLAM 和运动规划接口,方便在仿真里快速搭建和调试机器人程序。
开箱即用的 LiDAR SLAM 系统,用 Python 实现,能直接完成激光雷达建图与定位,省去繁琐配置。
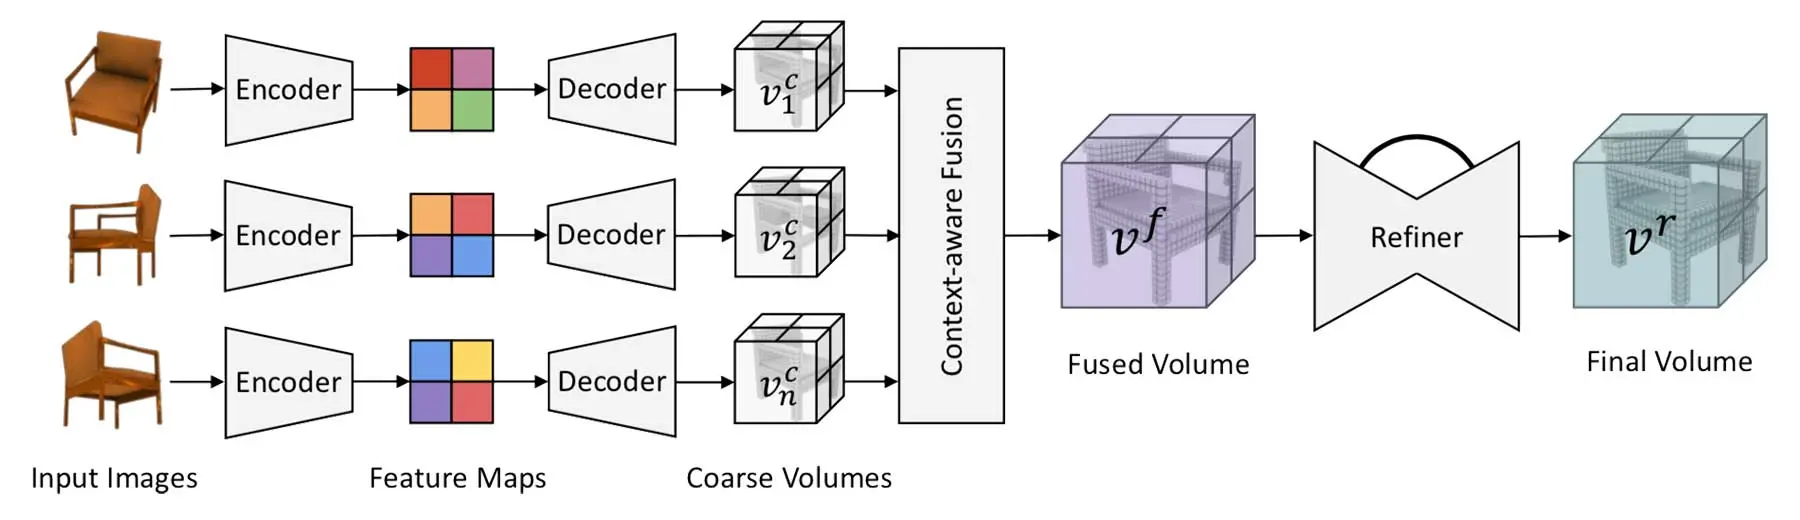
从单张或多视角图片重建三维体素模型的官方实现,基于 ICCV 2019 论文,用上下文感知融合提升重建精度。

基于 ImGui 和 OpenGL 的 3D 可视化库,方便快速搭建点云、SLAM 和定位算法的原型调试界面。
开放词表目标计数模型,基于视觉语言基础模型,能按任意文本描述统计图像中物体数量,无需针对新类别重新训练。
MILo 是 SIGGRAPH Asia 2025 的官方实现,把网格优化嵌进 3D 高斯泼溅流程,从多视角图像重建出细节丰富又轻量的表面网格。
整理具身智能方向的论文与行业资源清单,覆盖检测、导航、语言学习等主题,方便快速定位相关研究。
TurtleBot3 的 Gazebo 仿真环境,提供移动机器人导航、SLAM 和感知算法的开发与测试平台,无需真机即可验证 ROS 程序。
用 C++ 实现的快速 LiDAR SLAM,从激光雷达点云做里程计与建图,适合机器人、自动驾驶的实时定位需求。